

Python爬虫实战:Cookie持久化存储与SSL证书忽略处理
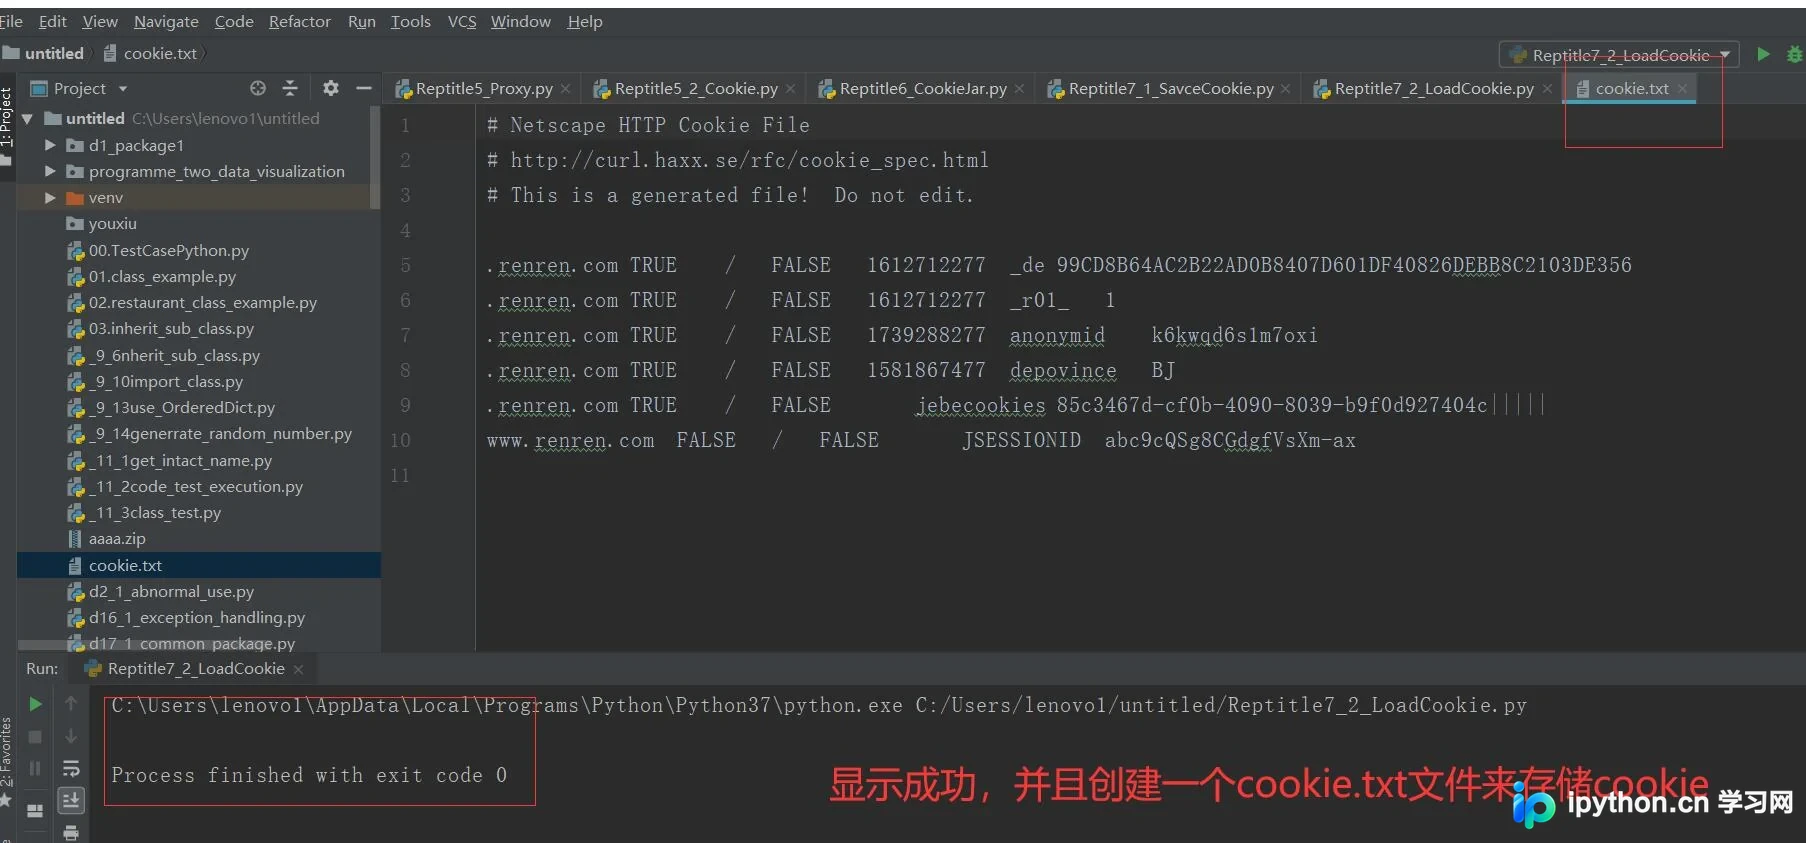
本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
2026-10-13
6

本文详解Python爬虫中Cookie的持久化保存与读取方法,利用FileCookieJar类实现登录状态的文件存储。同时介绍如何处理HTTPS请求中的SSL证书验证问题,通过替换默认上下文环境来忽略不信任的SSL证书,确保爬虫程序在复杂网络环境下的稳定运行。
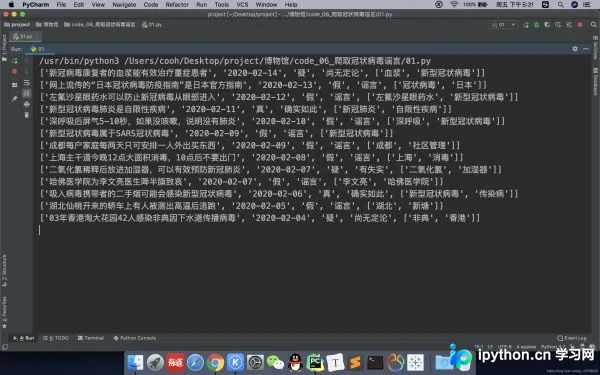
本文详细介绍如何使用Python爬取权威辟谣平台数据,并通过Pandas和Matplotlib进行可视化分析。文章涵盖从数据抓取、清洗嵌套列表关键字,到绘制谣言真假占比饼图及高频关键字柱状图的全过程,帮助读者掌握利用编程手段进行舆情数据分析的完整技能。
本文介绍如何使用Python调用有道翻译API实现一个简单的桌面翻译工具。通过逆向分析网页请求参数,包括MD5签名生成、时间戳和随机盐值的处理,展示了如何构造POST请求获取翻译结果。代码包含完整的请求头、Cookie及参数设置,适合Python初学者学习网络请求与数据处理。
本文详细介绍Python爬虫框架Scrapy的基础使用,涵盖环境安装、项目创建及目录结构解析。通过一个具体的题库抓取案例,演示如何编写Spider、定义Items、配置Pipeline以及处理数据库存储,帮助开发者快速掌握Scrapy的核心流程与代码实现。
本文详细介绍在Scrapy框架中实现网站登录的三种常见方式。第一种通过预置Cookies直接访问;第二种手动解析网页获取隐藏字段后发送POST请求;第三种利用FormRequest.from_response自动处理表单提交。文章提供完整代码示例,帮助开发者掌握不同场景下的登录策略。
本文详细介绍如何使用Python Scrapy框架搭建第一个爬虫项目。内容涵盖从创建项目、定义抓取字段、编写Spider逻辑到配置管道保存数据至MongoDB的完整流程,帮助初学者快速掌握Scrapy的核心使用方法。
本文详解Python爬虫中URL管理器的实现方法,重点解析如何利用collections模块中的deque双向队列高效维护待抓取与已抓取URL集合。通过示例代码展示如何判断URL存在性、执行去重逻辑及防止页面跳转死循环,为构建稳定爬虫系统提供核心组件参考。
本文介绍如何使用Python通过16行代码批量下载王者荣耀高清皮肤。教程涵盖获取英雄列表JSON、解析皮肤URL规则、利用urllib.urlretrieve下载及文件管理逻辑,帮助开发者快速掌握基础爬虫技巧。
本文深入解析Python BeautifulSoup库中的核心数据结构。详细讲解如何利用Tag对象获取HTML/XML标签名、读写属性及处理多值属性;介绍NavigableString类用于处理标签内文本及替换操作;阐述BeautifulSoup对象作为文档整体的特性,以及Comment对象在提取注释内容时的应用。
本文详细解析使用Docker部署Python爬虫项目的完整步骤。内容涵盖Docker环境安装、基础镜像拉取、Python运行环境编译、依赖库处理、Dockerfile编写规范、镜像构建命令及容器启动参数配置,帮助开发者实现爬虫项目的标准化与自动化部署。
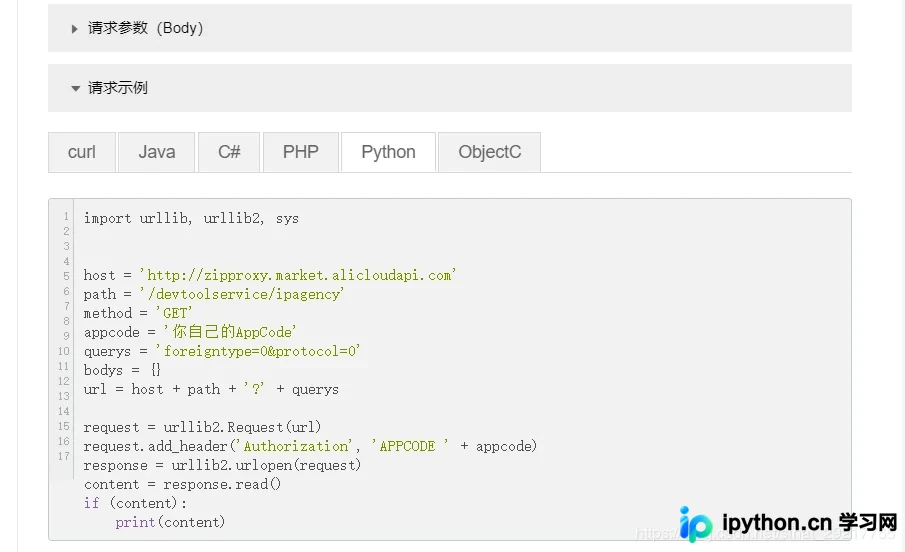
本文详细讲解在Python3 Scrapy框架中配置IP代理的方法。针对阿里云IP代理参数变更及公共IP池不可用的问题,提出结合阿里云API生成有效IP池并在middlewares.py中通过process_request动态设置request.meta['Proxy-Authorization']的解决方案,确保爬虫稳定运行。
本文介绍如何使用 Python3 结合 requests 和 BeautifulSoup 库,通过递归方式爬取指定网站下的所有 URL 链接。文章详细解析了从首页提取初始链接、遍历子页面获取新链接,以及利用递归函数处理深层页面的完整流程,并提供了完整的可运行代码示例,帮助开发者快速实现网站链接抓取功能。