详解使用scrapy进行模拟登陆三种方式
本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
2026-10-14
6

本文详细介绍在Scrapy框架中实现模拟登录的三种核心方式:直接携带Cookies、使用FormRequest发送POST请求以及利用from_response自动解析表单。通过GitHub登录示例,解析代码逻辑与配置要点,帮助开发者掌握不同场景下的最佳实践。
本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详细介绍在Python3爬虫项目中安装RedisDump的方法。由于RedisDump基于Ruby实现,需先配置Ruby环境及rvm工具。文章涵盖通过gem命令安装redis-dump的详细步骤,包括国内源配置、版本验证及命令测试,帮助开发者顺利完成Redis数据迁移工具的部署。
本文详细介绍如何使用Python的multiprocessing.dummy模块实现线程池爬虫,以梨视频为例演示短视频的批量抓取与下载。内容涵盖URL解析、动态链接拼接、文件命名冲突处理及并发下载优化,提供完整代码示例与关键技术点解析,帮助开发者掌握高效网络爬虫开发技巧。
本文介绍使用Python编写爬虫程序,通过BeautifulSoup解析网页获取视频URL,并利用迅雷COM接口实现自动批量下载的方法。代码包含获取最新网址、分页处理、URL提取及调用迅雷一键下载功能,适合需要自动化视频采集场景的开发者参考。
本文介绍如何利用Python爬虫技术实现全网音乐搜索与下载功能。通过调用第三方音频解析接口,获取歌曲直链并保存为MP3文件。文章详细讲解了从命令行工具到Tkinter图形界面的代码优化过程,包括请求模拟、JSON数据解析及文件下载逻辑,最终打包为可执行文件供用户使用。
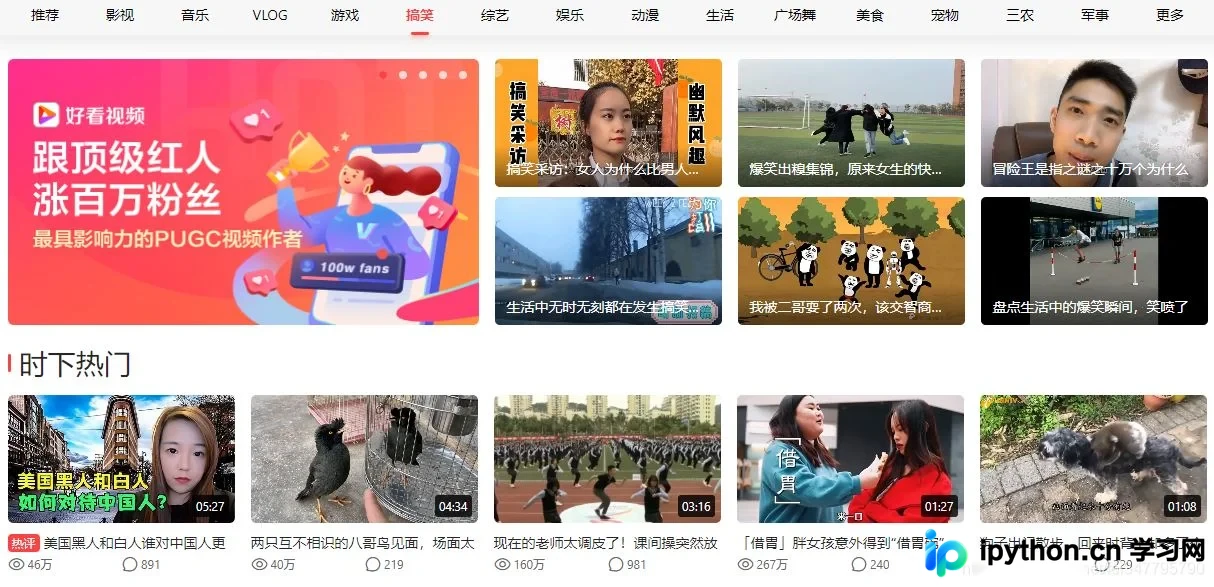
本文介绍使用Python爬取好看视频平台搞笑栏目短视频的方法。针对网站懒加载特性,通过构造API请求获取视频列表,解析标题与播放地址,并利用requests库下载保存视频文件。
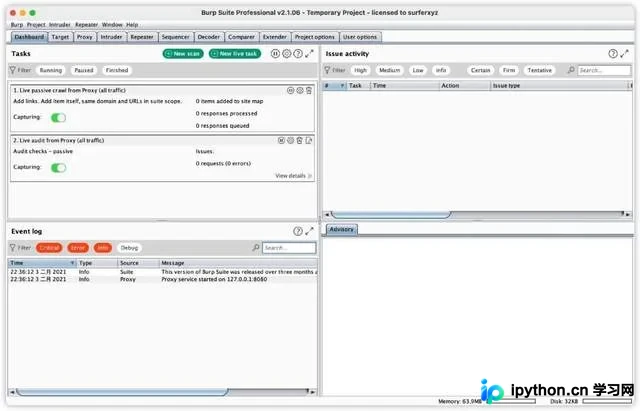
本文详解如何使用Python批量下载抖音个人主页的无水印视频。核心思路是通过BurpSuite抓取手机App的HTTPS请求,分析获取视频列表的API接口。文章介绍了从单个视频去水印技巧到批量抓取链接的完整流程,重点讲解如何模拟手机请求以绕过网页端的限制,为开发自动化下载脚本提供技术参考。
本文详细介绍如何使用Python爬虫实现智能翻页并批量下载文件。通过解析初始页面获取分类链接,自动识别尾页页数进行循环翻页,提取每页的文件名与下载链接,最终将文件保存至本地指定文件夹。以京客隆网站为例,演示了从解析HTML到批量下载PDF文档的完整流程。
本文介绍如何使用Python多线程技术高效爬取西刺代理IP,并通过BeautifulSoup解析HTML提取关键信息。代码展示了从单页抓取到多线程并发处理的实现,最后将结果转换为SSR工具可直接识别的JSON格式,适用于需要批量获取代理IP的场景。
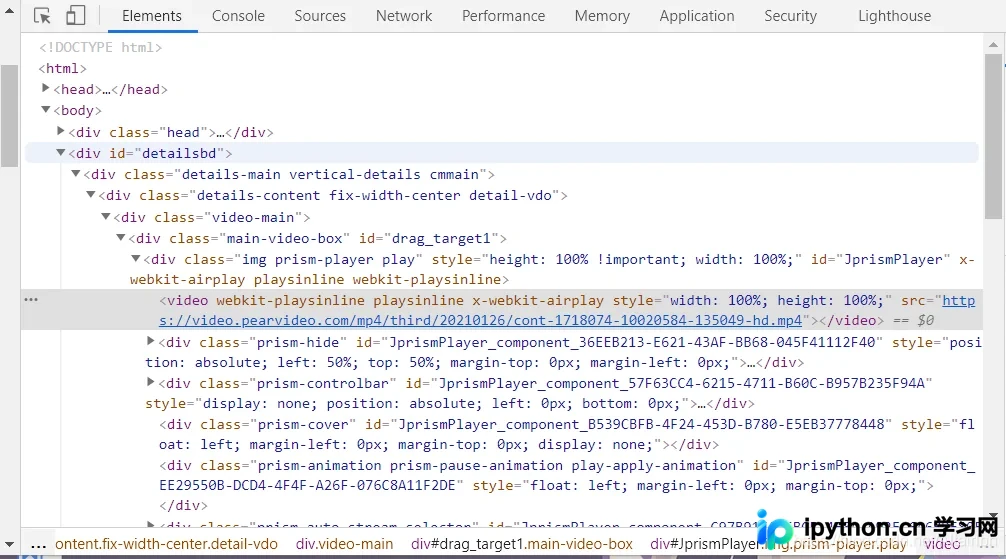
本文详解使用Python爬取梨视频美食区视频的完整流程。针对视频URL动态加载及JSON数据中链接返回404的问题,通过分析请求头Referer参数及对比不同来源的URL结构,总结出正确的URL拼接规则。结合XPath解析与多线程下载,实现高效视频抓取。
本文通过B站爬虫案例,指出Selenium中使用XPath直接获取属性(如./a/@href)会报错,正确做法是先定位元素节点再调用get_attribute()方法。文章提供了完整的Python代码示例,展示了如何在无头浏览器环境下解析网页数据并提取链接与标题。