

Python实现海量表情包多线程爬虫:从环境配置到代码详解
本文详细介绍如何使用Python结合requests、bs4及多线程技术,实现海量表情包的自动抓取与本地保存。内容涵盖环境配置、核心类设计、URL解析逻辑及完整的爬虫代码示例,帮助开发者快速掌握并发爬取技巧。
2026-10-14
6

本文详细介绍如何使用Python结合requests、bs4及多线程技术,实现海量表情包的自动抓取与本地保存。内容涵盖环境配置、核心类设计、URL解析逻辑及完整的爬虫代码示例,帮助开发者快速掌握并发爬取技巧。
本文系统讲解Python爬虫核心知识,涵盖Web交互原理、Requests库的get/post/put方法及Response对象属性。提供10个基础代码实例,演示URL传参、Headers伪装绕过反爬、文件保存及编码处理。最后通过完整实例展示如何结合正则表达式从百度贴吧批量下载图片,适合初学者快速掌握爬虫基本操作。

本文深入解析Python标准库urllib.request模块。详细讲解Request类的构造参数与数据编码,阐述Handler与Opener的协作机制。通过身份验证、代理配置及Cookie持久化(Mozilla与LWP格式)的完整代码示例,展示如何灵活构建HTTP请求处理器,适用于Python网络编程与爬虫开发场景。
本文介绍如何在 Python Selenium 中通过 Chrome DevTools Protocol (CDP) 获取接口数据。Selenium 本身不提供直接查询接口响应的方法,但可通过配置性能日志(performance logging)捕获 requestid,进而调用 Network.getResponseBody 命令提取特定 URL 的完整响应内容。
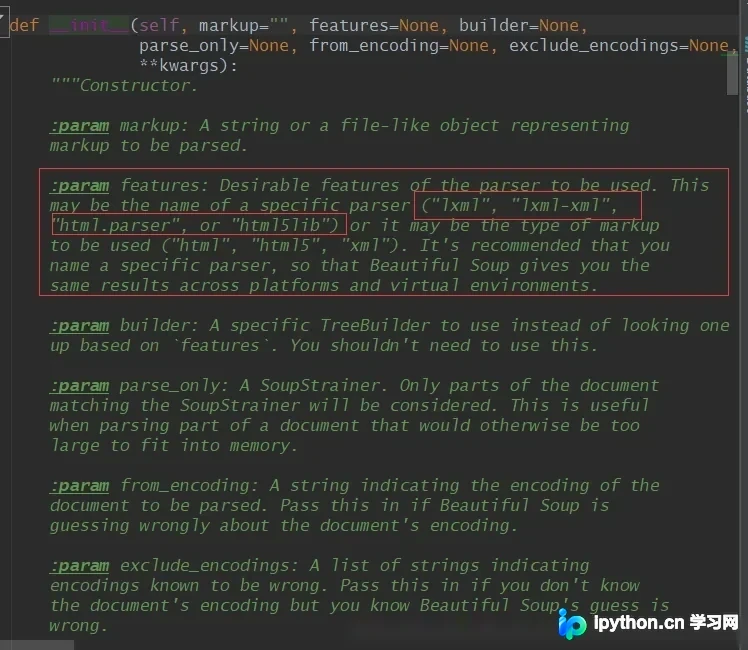
本文详细介绍Python中BeautifulSoup库的核心查找方法find和find_all。通过构建实例、解析HTML结构,演示如何精准定位标签、提取文本与属性。重点讲解处理class关键字冲突的技巧,以及find_all在批量提取数据时的灵活应用,帮助开发者高效完成网页数据抓取任务。
本文详解在Python爬虫中获取指定class样式的div标签的三种方法。对比字符串查找与正则表达式的局限性,重点介绍BeautifulSoup库的使用技巧。通过字典形式赋值attrs参数解决官方文档示例无效的问题,并提供完整代码示例及图片下载实战,帮助开发者高效准确提取网页数据。
本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
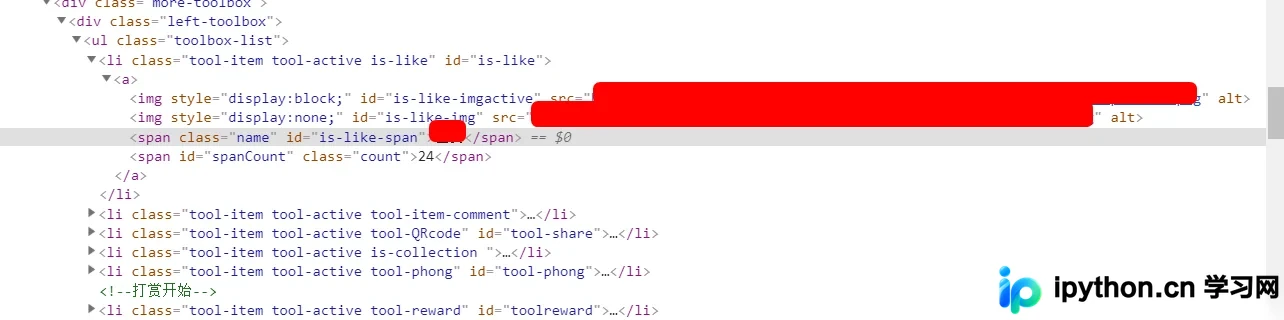
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
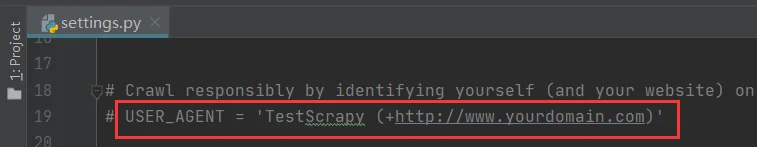
本文详细解析Scrapy中请求头部的生成机制与覆盖优先级。从自动添加的User-Agent和Accept-Encoding,到settings.py中的DEFAULT_REQUEST_HEADERS配置,再到Request对象及下载中间件中的自定义Header,层层剖析其生效顺序。特别指出Referer中间件的最高优先级特性及关闭方法,帮助开发者精准控制HTTP请求头部。
本文深入解析Python函数中return语句的使用机制,阐明未显式返回时默认返回None的原理,并通过对比代码实例说明调用差异。同时,结合爬虫场景,介绍如何利用random和time库实现随机等待时间,以降低被封IP的风险。
本文详细介绍 Python Selenium 中两种核心元素等待机制:显式等待与隐式等待。通过 WebDriverWait 类结合 expected_conditions 实现精准的元素状态检测,以及利用 implicitly_wait 设置全局超时轮询。文章包含完整代码示例与参数解析,帮助开发者解决页面加载不同步导致的定位失败问题,提升爬虫稳定性。
本文详解Python Selenium中关闭浏览器的两种方法:close()用于关闭当前窗口,quit()用于关闭所有窗口并释放驱动。通过代码示例展示如何在多窗口场景下遍历句柄并逐一关闭,帮助开发者正确管理浏览器资源。