

Python爬取梨视频实战:动态加载与URL拼接解析

本文详解使用Python爬取梨视频美食区视频的完整流程。针对视频URL动态加载及JSON数据中链接返回404的问题,通过分析请求头Referer参数及对比不同来源的URL结构,总结出正确的URL拼接规则。结合XPath解析与多线程下载,实现高效视频抓取。
本文以梨视频美食区最热标签下的三个视频为例,展示完整的爬取流程。
- 首先访问首页,提取每个视频对应的唯一编号以及视频标题名称。
- 利用获取到的视频编号,构建符合网站规范的请求URL地址。
- 通过构造好的URL发起请求,并将返回的视频二进制数据保存至本地文件。
整个爬取过程的核心思路分为三个主要步骤。
第一步尝试从静态网页源码中直接获取视频链接。
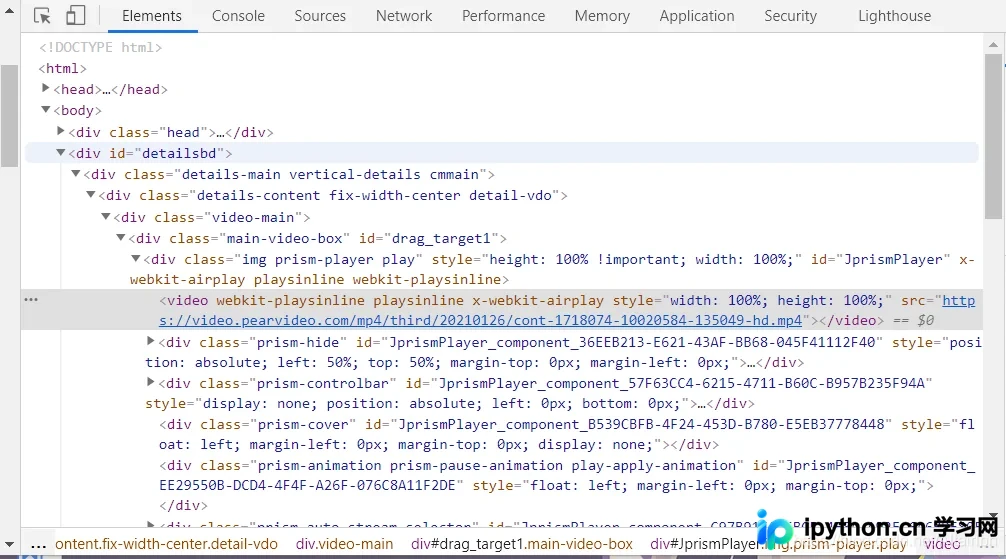
观察发现,视频的播放地址位于ID为“JprismPlayer”的div元素内部的video标签的src属性中,因此计划使用XPath解析网页来获取该属性值。
video_url = tree.xpath("//div[@id='JprismPlayer']/video/@src")然而执行XPath解析后返回结果为空,这表明该video标签并未直接存在于初始加载的HTML源码中,推测其是通过JavaScript动态加载生成的。
第二步转向分析页面的动态网络请求,以寻找真正的视频源地址。
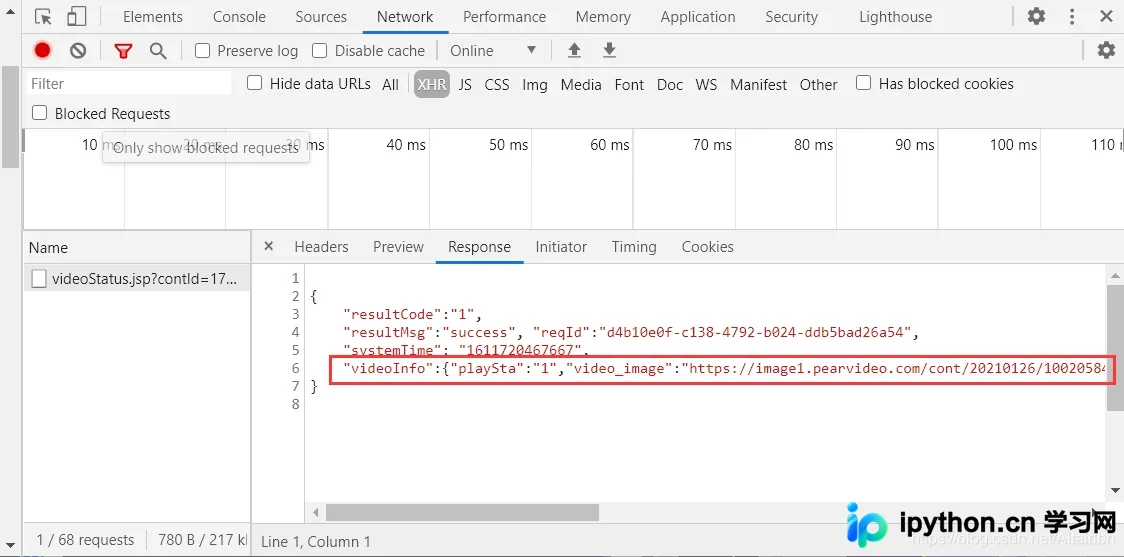
通过浏览器开发者工具监控网络流量,确实在动态请求中发现了包含视频播放URL的JSON数据。
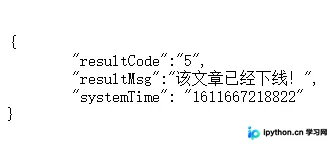
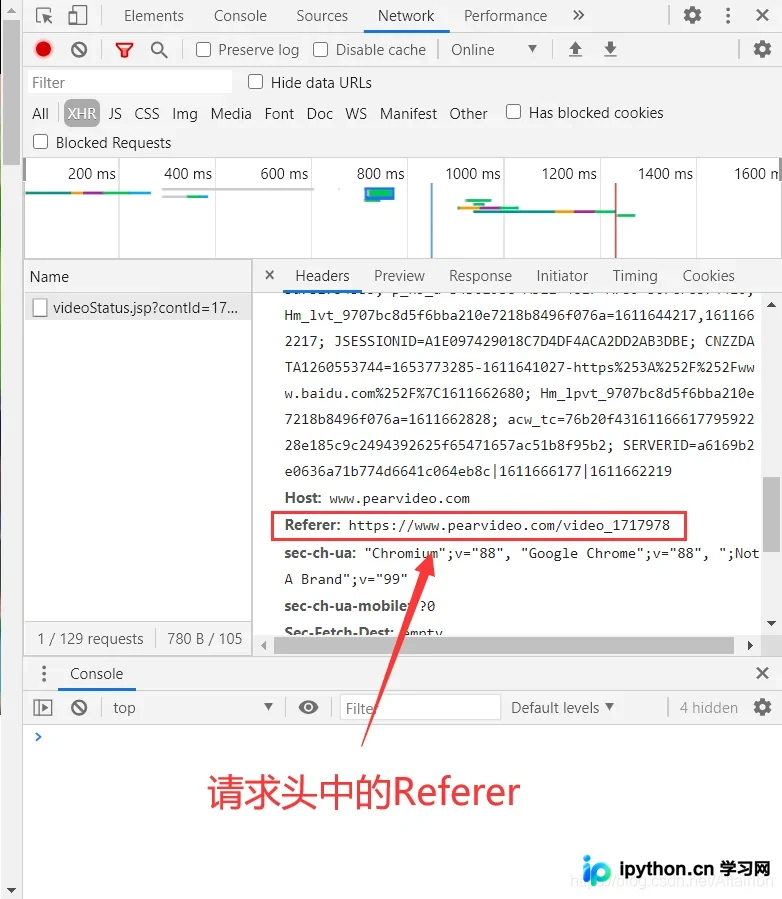
但在实际发起请求获取JSON数据时,返回的内容与抓包工具中观察到的不一致。经过排查,发现需要在请求头(headers)中补充Referer参数,且该Referer值的末尾部分“video_”后需跟随首页中获取到的视频编号,才能正确获取数据。
{
	"resultCode":"1",
	"resultMsg":"success", "reqId":"fd1c910d-f49a-431a-b9a4-9c193c3c1983",
	"systemTime": "1611666178518",
	"videoInfo":{"playSta":"1","video_image":"https://image1.pearvideo.com/cont/20210125/11107897-184717-1.png","videos":{"hdUrl":"","hdflvUrl":"","sdUrl":"","sdflvUrl":"","srcUrl":"https://video.pearvideo.com/mp4/third/20210125/1611666178518-11107897-181816-hd.mp4"}}
}
在请求头中正确添加Referer参数后,成功获取到了预期的JSON数据。
然而,直接使用JSON数据中的视频URL发起请求时,服务器返回了404错误页面,说明该链接不可用。
第三步重点在于修正并拼接出正确的视频下载URL。
经过反复排查前面的步骤,发现动态请求返回的JSON数据中的视频URL与首页video标签中加载出的URL存在本质差异。

对比两者结构可知,首页直接加载的视频链接是有效的,可以直接用于下载;而JSON数据中的链接会导致404错误。两者的前半部分一致,但在关键标识符处不同:正确的URL格式应为“cont-视频id-”,而JSON数据中对应部分是一串纯数字。因此,只需将JSON数据中的那串数字替换为“cont-视频id-”格式,即可构造出可用的视频下载URL。
以下是实现上述逻辑的Python代码示例。
# 爬取梨视频

import requests
from lxml import etree
import os
from multiprocessing import Pool

# 梨视频首页url
url = "https://www.pearvideo.com/category_6"
headers = {
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36'
  }

# 获取响应,并用etree解析
response = requests.get(url=url, headers=headers).text
tree = etree.HTML(response)

# 拿到视频的名字和视频号
video_id_list = tree.xpath("//ul[@class='listvideo-list clearfix']/li[@class='categoryem ']//a[@class='vervideo-lilink actplay']/@href")
video_name_list = tree.xpath("//ul[@class='listvideo-list clearfix']/li[@class='categoryem ']//a/div[@class='vervideo-title']/text()")
data_list = [{"name": video_name_list[i], "idNum": video_id_list[i][6:]} for i in range(len(video_name_list))]

# 创建一个存放视频的文件夹
if not os.path.exists("./videos"):
  os.mkdir("./videos")

# 获取视频的函数
def down_video(data):
  name = data['name']
  idNum = data['idNum']

  # 获取视频需要的headers,注意这里的Referer要和视频的id匹配
  headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.104 Safari/537.36',
    'Referer': f'https://www.pearvideo.com/video_{idNum}'
  }
  # 获取接近真正视频url的url,这里的id也需要和视频id匹配才行
  url = f'https://www.pearvideo.com/videoStatus.jsp?contId={idNum}'

  # 得到包含视频地址json响应数据
  response = requests.get(url=url, headers=headers).json()
  video_url = response["videoInfo"]["videos"]["srcUrl"]

  # 将视频地址中的数字替换成 cont-视频编号 拿到真正的视频地址
  video_url = video_url.replace(video_url.split("/")[-1].split("-")[0], "cont-" + idNum)

  # 拿到视频并保存
  video = requests.get(url=video_url, headers=headers).content
  with open(f"./videos/{name}.mp4", "wb") as f:
    print(f"正在下载视频 {name} ...")
    f.write(video)
    print(f"视频 {name} 下载完成!")

if __name__ == '__main__':
  # 创建进程池并使用
  pool = Pool(3)
  pool.map(down_video, data_list)
  pool.close()
  pool.join()
最后对整个过程进行总结。
爬取过程中的难点在于获取正确的视频URL,中间涉及动态加载分析和URL格式修正,过程较为曲折。只要掌握了URL的拼接规律,并结合从首页获取的视频ID,即可顺利下载视频。若需爬取首页所有视频,仅需调整XPath的选择路径即可。
以上是Python爬取梨视频的示例详解,更多关于Python爬取视频的技术资料,欢迎查阅本站其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









