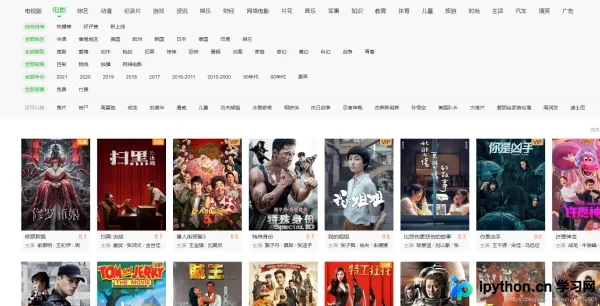
Python趣味爬虫之爬取爱奇艺热门电影
本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。
2026-10-14
6

本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。
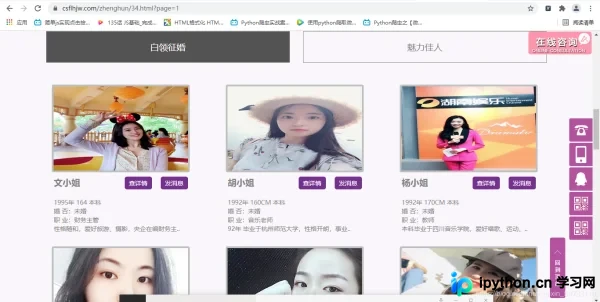
本文详细演示如何使用Python抓取某婚恋网站的公开征婚数据。通过浏览器开发者工具分析页面加载机制,确定采用同步加载处理方式。文章逐步解析URL规律、构造请求头、利用XPath提取关键信息,并完整展示数据保存至CSV文件的代码实现,为初学者提供清晰的爬虫开发思路。
本文详解如何使用Python爬取《哆啦A梦:伴我同行2》的豆瓣短评,并通过jieba库进行中文分词、去停用词处理,最终利用wordcloud库生成可视化词云图。教程涵盖requests请求、正则解析、词典动态调整及词频统计等核心步骤,适合爬虫初学者练手。
本文介绍使用Python编写脚本从指定网站批量爬取高清原图壁纸的方法。通过构建代理IP池以规避反爬机制,利用urllib库进行HTTP请求,并结合正则表达式解析页面结构,实现图片的自动识别与保存。代码包含完整的代理获取、验证及下载逻辑,适合Python初学者参考学习网络爬虫基础技术。
本文介绍使用Python和BeautifulSoup4编写简易爬虫,分别抓取开心网和豆瓣的个人日记。教程涵盖获取浏览器Cookie、配置请求头、处理HTML解析及文件保存等核心步骤,并提供完整代码示例与注意事项。
本文介绍使用Python编写的影视网站资源抓取工具,通过requests和re模块解析网页结构,结合多线程与并发处理提升效率。代码包含自定义请求头、Cookie管理及正则提取逻辑,支持批量获取指定影视内容的下载链接,适合对Python爬虫感兴趣的用户参考学习。
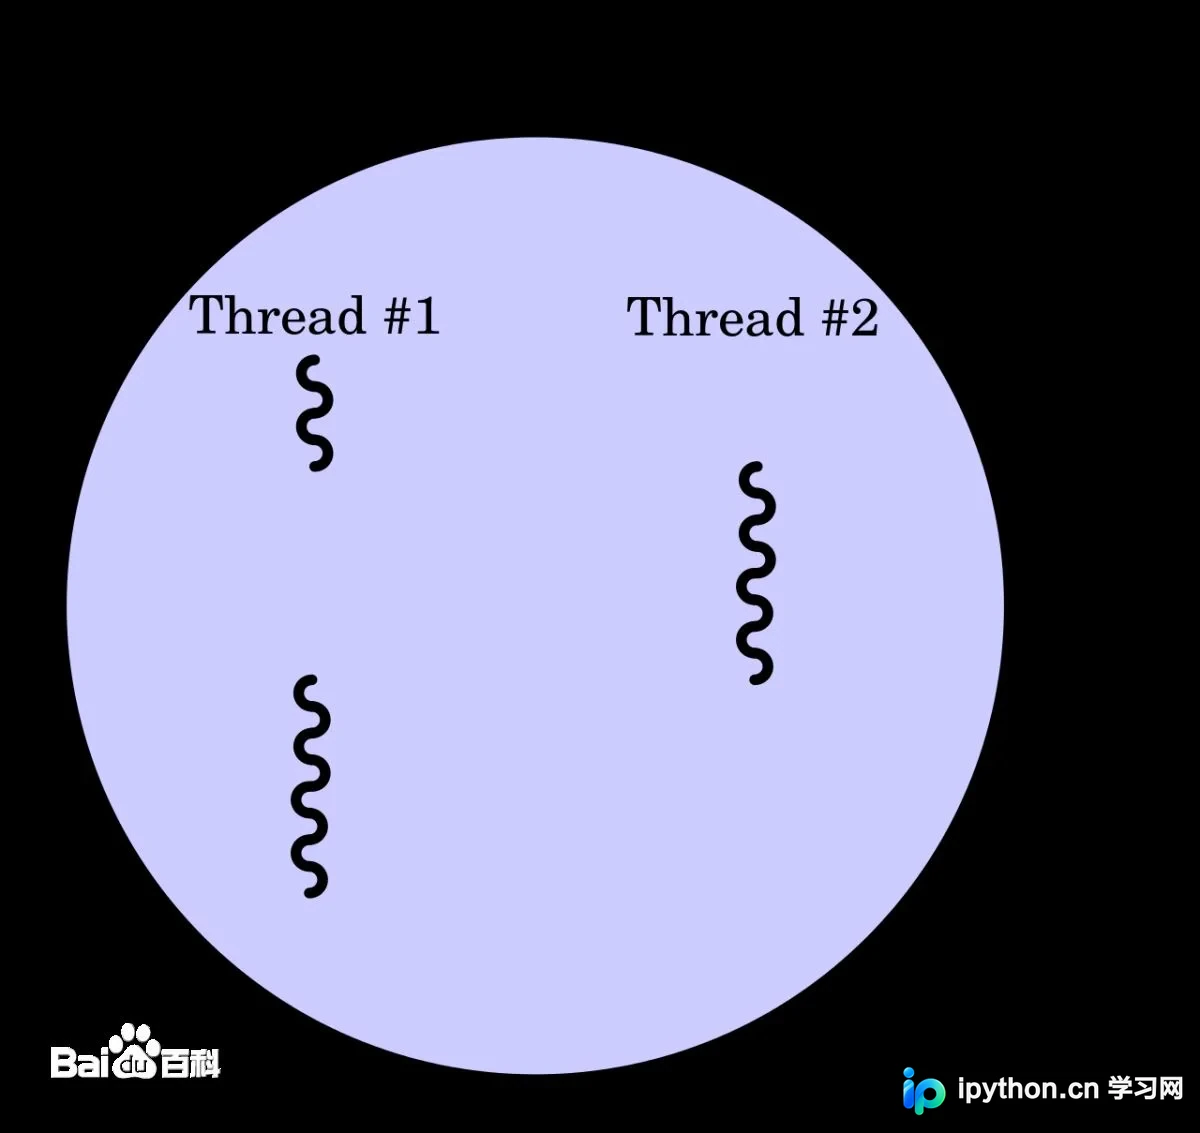
本文深入解析Python多线程原理,并实战演示如何高效抓取英雄联盟英雄及皮肤图片。通过分析异步加载机制与API接口,结合多线程与队列技术,实现高并发数据下载与保存,提供完整代码模板供参考。
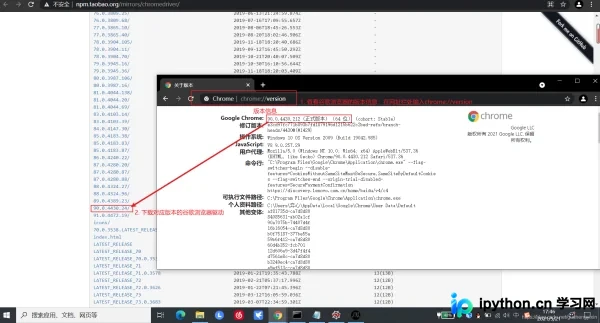
本文详细讲解Python中Selenium库的安装方法及Chrome浏览器驱动的下载与配置步骤。通过版本匹配检查和代码示例,演示如何利用Selenium控制浏览器进行网页数据抓取,帮助开发者快速搭建爬虫环境。
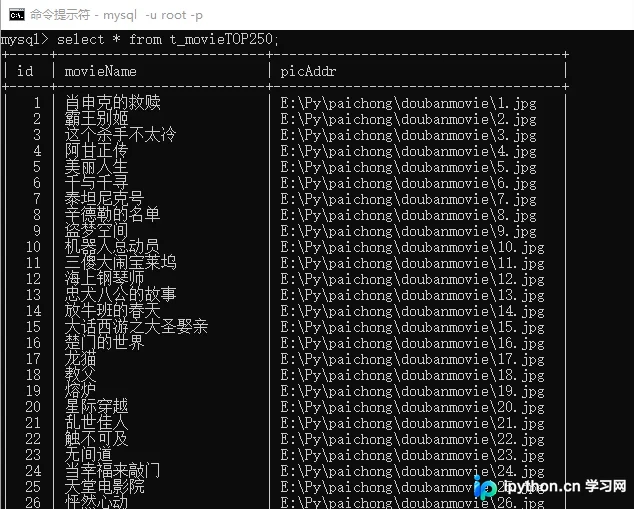
本文详细介绍如何使用Python编写爬虫程序,从豆瓣电影TOP250页面抓取电影名称及图片链接,并将结果存储至MySQL数据库。教程涵盖数据库初始化、正则匹配提取、网页请求处理及数据持久化完整流程,适合Python初学者参考。
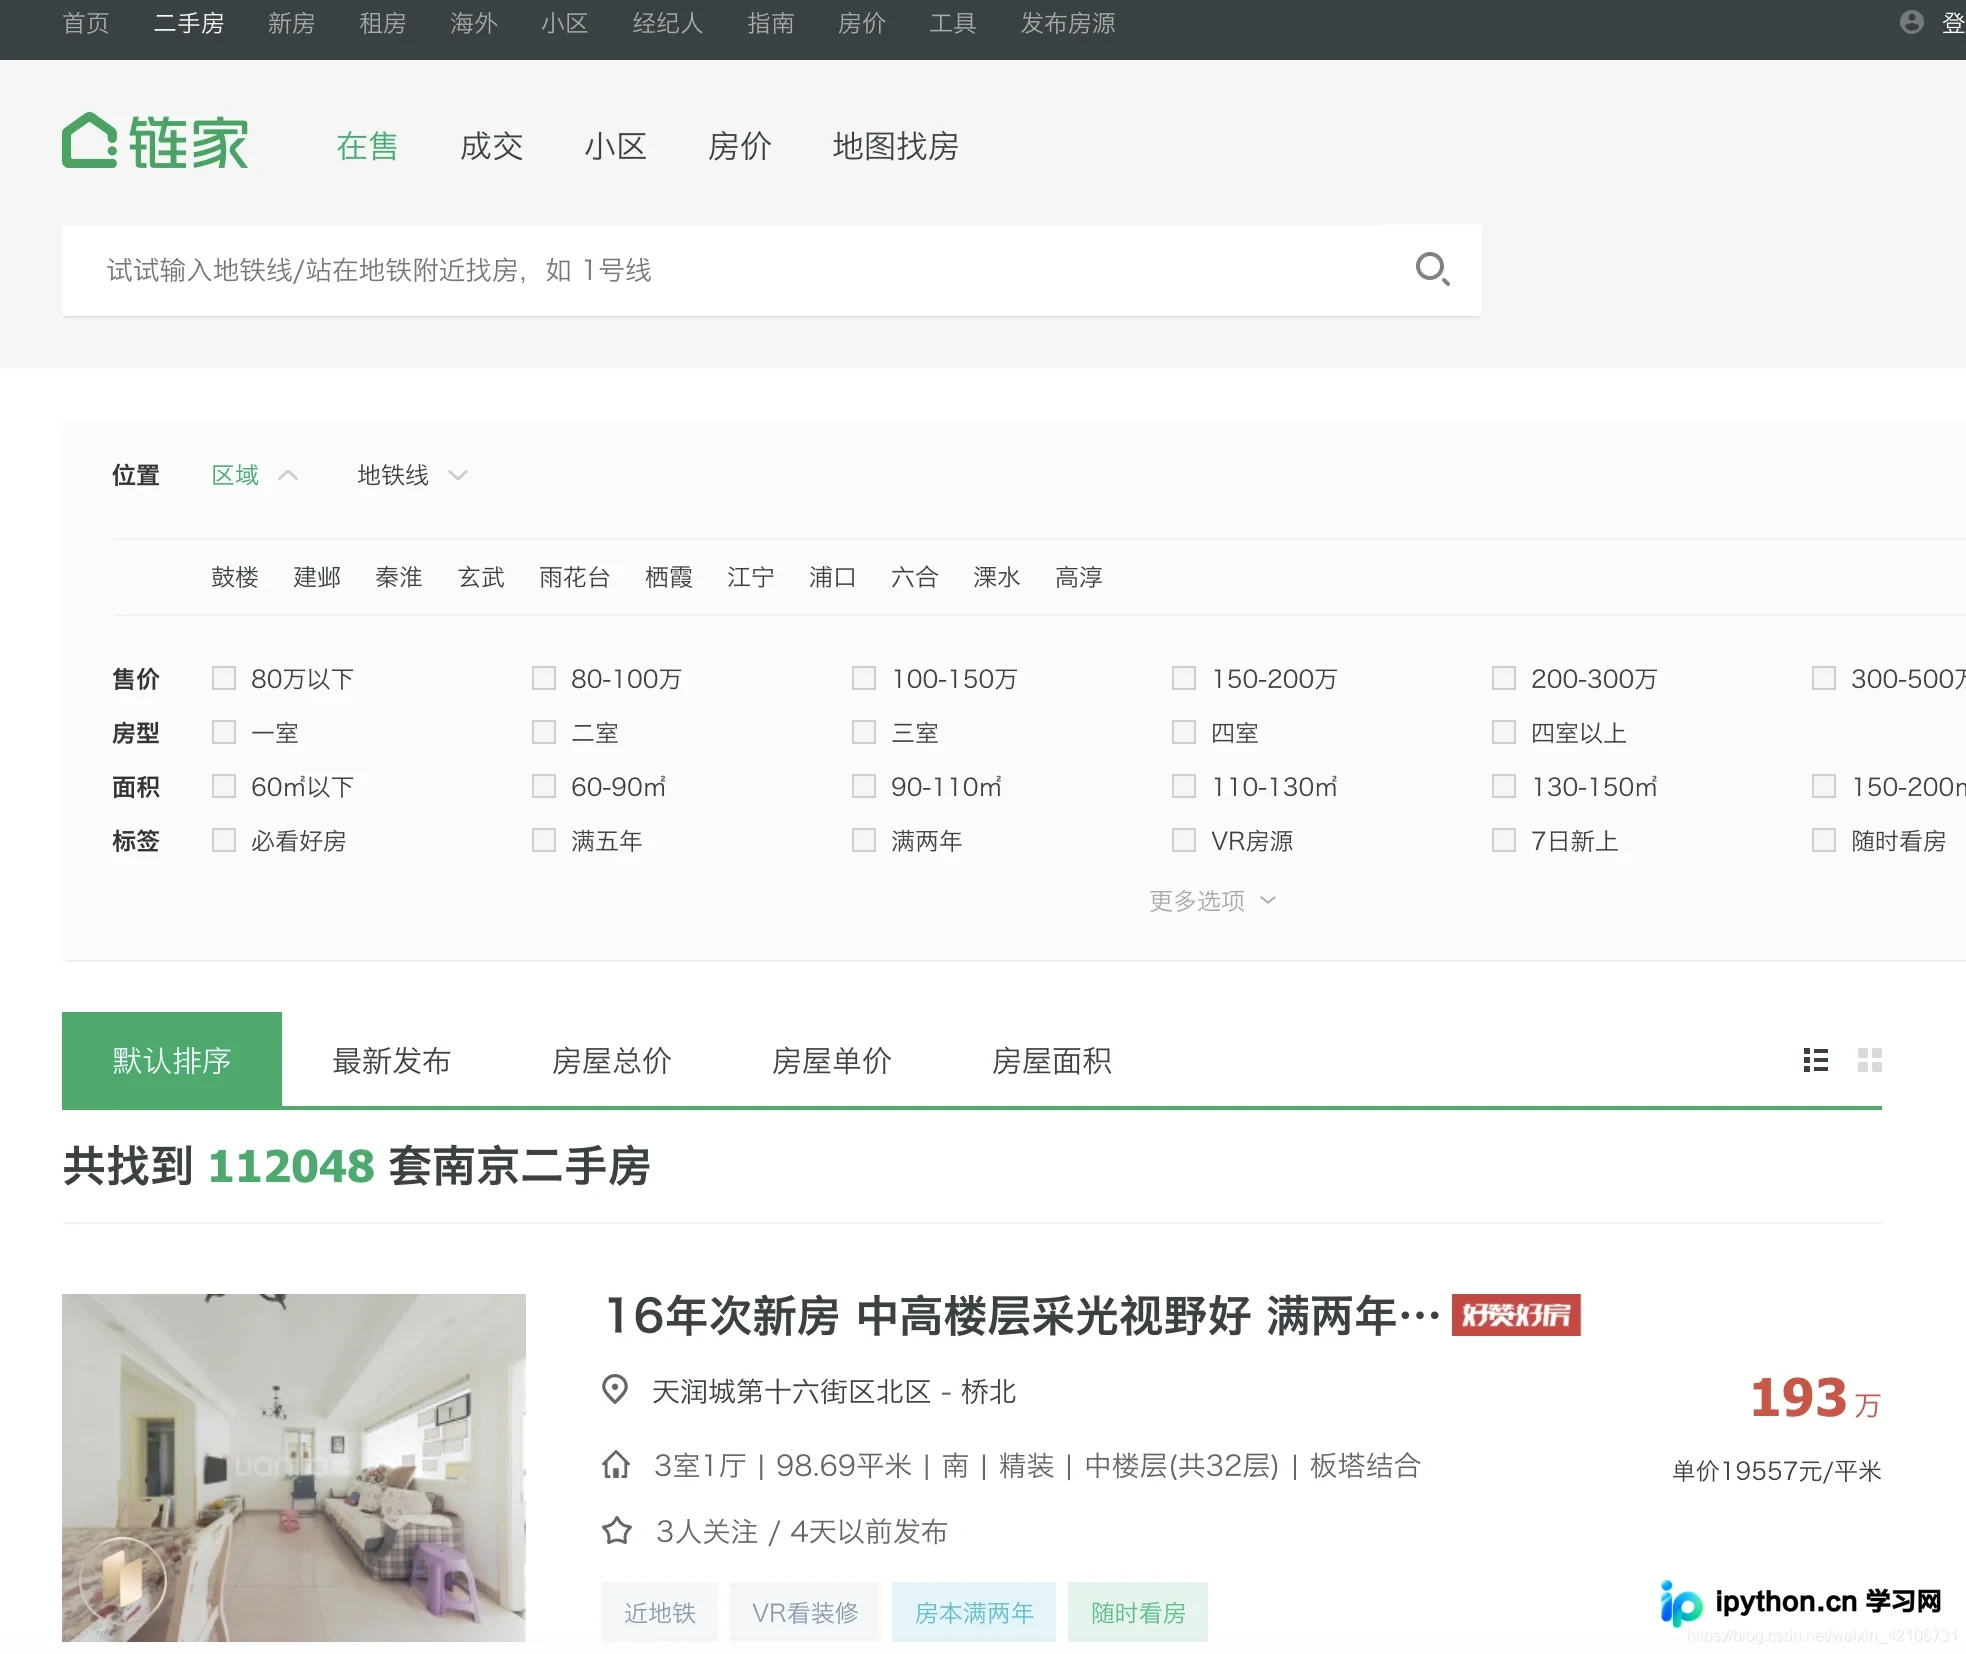
本文详细介绍使用Python爬取链家二手房数据的完整流程。通过Requests获取页面HTML,利用BeautifulSoup解析DOM结构,提取标题、户型、面积、朝向、装修、位置及价格等关键信息。文章涵盖数据定位、HTML获取及解析代码示例,帮助开发者掌握基础爬虫技巧。
本文详细讲解如何使用Python爬取爱奇艺热门电影列表。通过分析目标网页结构,利用requests和BeautifulSoup库解析HTML,提取电影名称与链接。教程涵盖环境配置、代码实现及结果验证,帮助开发者掌握基础爬虫技巧,快速获取影视资源信息。
本文详细介绍Python中requests库获取的response对象的常用属性。涵盖状态码(status_code)、文本内容(text)、二进制数据(content)、编码方式(encoding)及响应头(headers)等关键属性,并通过代码示例对比text与content的区别,帮助开发者高效处理HTTP响应数据。