

Python爬取链家二手房数据实战:从请求到解析

发布时间:2026-10-14| 4人浏览过
本文详细介绍使用Python爬取链家二手房数据的完整流程。通过Requests获取页面HTML,利用BeautifulSoup解析DOM结构,提取标题、户型、面积、朝向、装修、位置及价格等关键信息。文章涵盖数据定位、HTML获取及解析代码示例,帮助开发者掌握基础爬虫技巧。
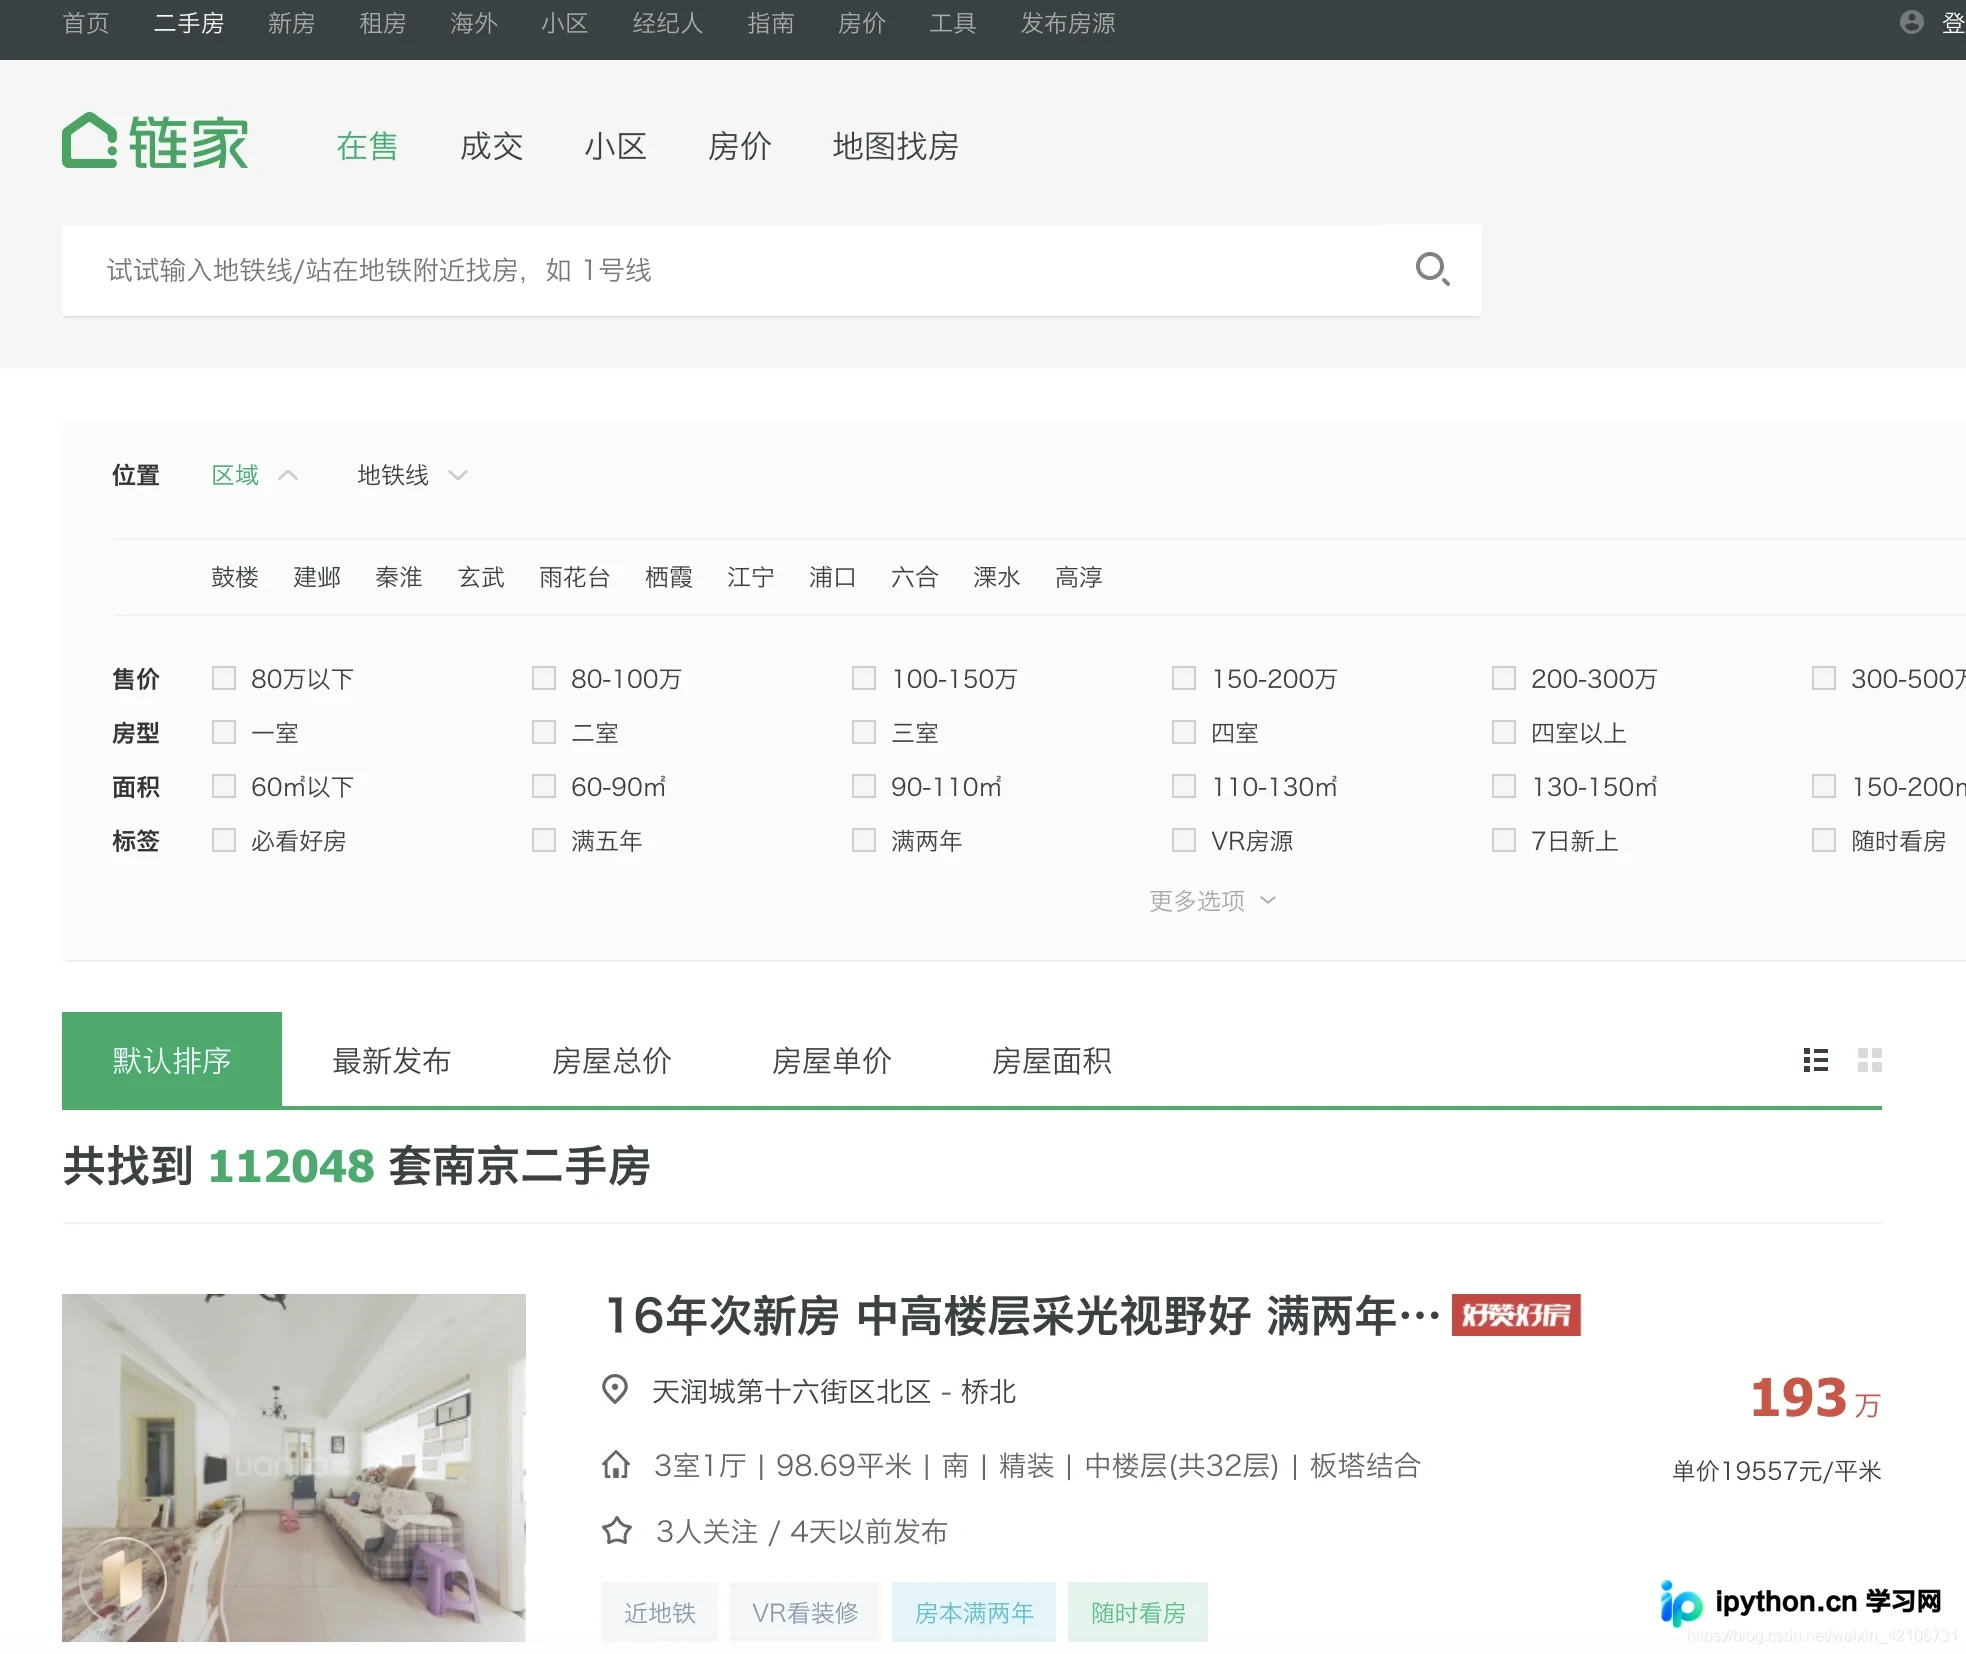
一、查找数据所在位置:
访问链家官方网站,进入二手房板块并选择目标城市。此时页面会显示该城市的房源总数以及具体的房源列表数据。
二、确定数据存放位置:
不同网站的数据存储方式各异,有的嵌入在HTML中,有的通过API接口返回,甚至部分数据经过JS加密。幸运的是,链家房源数据直接存储在HTML中,便于直接抓取。
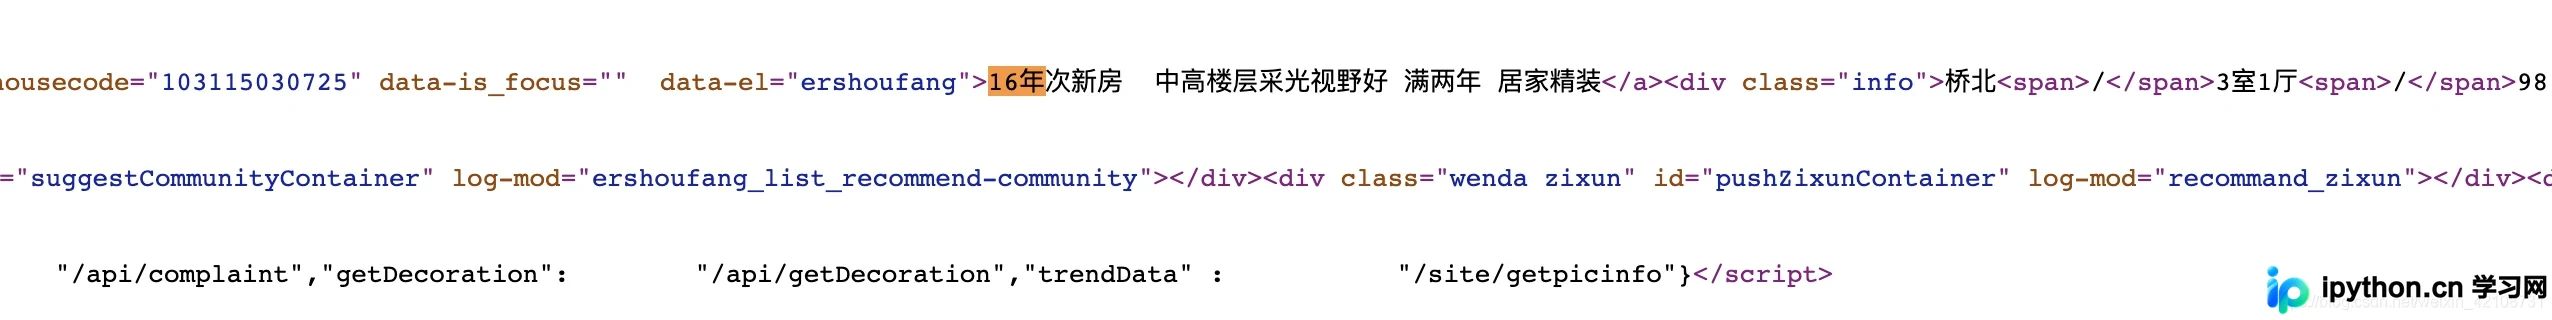
三、获取html数据:
利用requests库向页面发起请求,从而获取每一页的HTML源代码数据。
# 爬取的url,默认爬取的南京的链家房产信息
url = 'https://nj.lianjia.com/ershoufang/pg{}/'.format(page)
# 请求url
resp = requests.get(url, headers=headers, timeout=10)
四、解析html,提取有用数据:
使用BeautifulSoup库对获取的HTML进行解析,并从中提取所需的关键字段数据。
soup = BeautifulSoup(resp.content, 'lxml')
# 筛选全部的li标签
sellListContent = soup.select('.sellListContent li.LOGCLICKDATA')
# 循环遍历
for sell in sellListContent:
    # 标题
    title = sell.select('div.title a')[0].string
    # 先抓取全部的div信息,再针对每一条进行提取
    houseInfo = list(sell.select('div.houseInfo')[0].stripped_strings)
    # 楼盘名字
    loupan = houseInfo[0]
    # 对楼盘的信息进行分割
    info = houseInfo[0].split('|')
    # 房子类型
    house_type = info[1].strip()
    # 面积大小
    area = info[2].strip()
    # 房间朝向
    toward = info[3].strip()
    # 装修类型
    renovation = info[4].strip()
    # 房屋地址
    positionInfo = ''.join(list(sell.select('div.positionInfo')[0].stripped_strings))
    # 房屋总价
    totalPrice = ''.join(list(sell.select('div.totalPrice')[0].stripped_strings))
    # 房屋单价
    unitPrice = list(sell.select('div.unitPrice')[0].stripped_strings)[0]
以上即为本次分享的全部内容。若内容存在不足,欢迎指出并多交流,谢谢!
以上是关于Python爬取链家二手房数据的详细内容,更多相关Python爬虫资料请持续关注本站其他文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









