

Python实现豆瓣电影TOP250数据爬取与MySQL存储教程

发布时间:2026-10-14| 4人浏览过
本文详细介绍如何使用Python编写爬虫程序,从豆瓣电影TOP250页面抓取电影名称及图片链接,并将结果存储至MySQL数据库。教程涵盖数据库初始化、正则匹配提取、网页请求处理及数据持久化完整流程,适合Python初学者参考。
MySQL数据库初始化与连接配置
在启动代码之前,需预先在MySQL环境中建立名为“pachong”的数据库实例。
核心爬虫代码实现
import pymysql
import requests
import re


#获取资源并下载
def resp(listURL):
    #连接数据库
    conn = pymysql.connect(
        host = '127.0.0.1',
        port = 3306,
        user = 'root',
        password = '******',  #数据库密码请根据自身实际密码输入
        database = 'pachong',
        charset = 'utf8'
    )

    #创建数据库游标
    cursor = conn.cursor()

    #创建列表t_movieTOP250(执行sql语句)
    cursor.execute('create table t_movieTOP250(id INT PRIMARY KEY 												auto_increment NOT NULL ,movieName VARCHAR(20) NOT NULL 									,pictrue_address VARCHAR(100))')

    try:
        # 爬取数据
        for urlPath in listURL:
            # 获取网页源代码
            response = requests.get(urlPath)
            html = response.text

            # 正则表达式
            namePat = r'alt="(.*?)" src='
            imgPat = r'src="(.*?)" class='

            # 匹配正则(排名【用数据库中id代替,自动生成及排序】、电影名、电影海报(图片地址))
            res2 = re.compile(namePat)
            res3 = re.compile(imgPat)
            textList2 = res2.findall(html)
            textList3 = res3.findall(html)

            # 遍历列表中元素,并将数据存入数据库
            for i in range(len(textList3)):
                cursor.execute('insert into t_movieTOP250(movieName,pictrue_address) 									VALUES("%s","%s")' % (textList2[i],textList3[i]))

        #从游标中获取结果
        cursor.fetchall()

        #提交结果
        conn.commit()
        print("结果已提交")

    except Exception as e:
        #数据回滚
        conn.rollback()
        print("数据已回滚")

    #关闭数据库
    conn.close()

#top250所有网页网址
def page(url):
    urlList = []
    for i in range(10):
        num = str(25*i)
        pagePat = r'?start=' + num + '&filter='
        urL = url+pagePat
        urlList.append(urL)
    return urlList


if __name__ == '__main__':
    url = r"https://movie.douban.com/top250"
    listURL = page(url)
    resp(listURL)
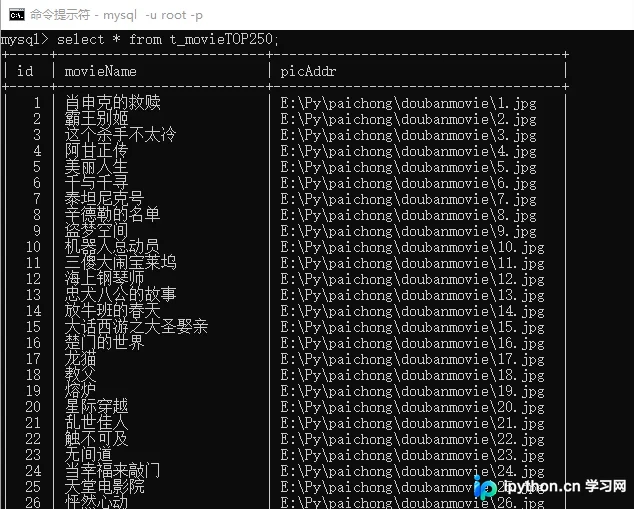
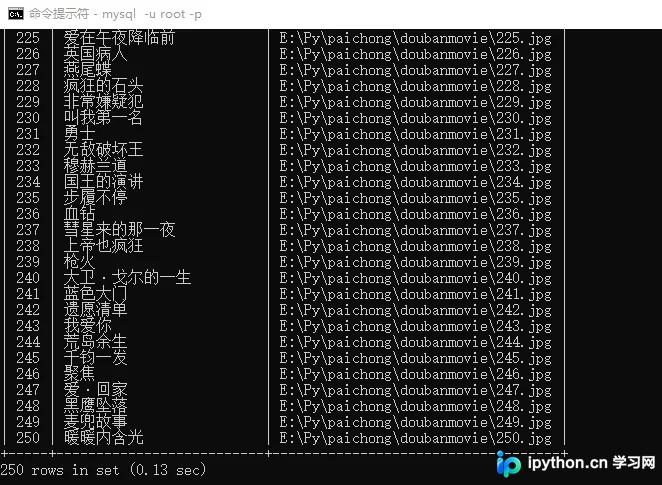
运行结果展示
运行效果如上图所示。
以上即为本次技术分享的全部内容,若有疏漏之处欢迎指正,期待更多交流,感谢阅读!
关于Python抓取豆瓣电影TOP250数据的完整教程已介绍完毕,如需获取更多相关技术资讯,请查阅本站其他文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









