

Pandas DataFrame 行遍历的四种高效实现方案

本文详细解析在 Pandas 中遍历 DataFrame 行的多种方法。重点对比了 iterrows()、itertuples()、apply() 以及 iloc 的性能差异与适用场景。文章指出 itertuples() 通常比 iterrows() 更快,并强调避免在迭代中修改数据的重要性,同时提供自定义 namedtuple 迭代器以进一步提升处理效率。
Pandas DataFrame 行遍历概述
假设存在如下 Pandas DataFrame 数据结构:
import pandas as pd
inp = [{'c1':10, 'c2':100}, {'c1':11,'c2':110}, {'c1':12,'c2':120}]
df = pd.DataFrame(inp)
print df
执行上述代码后的输出结果如下所示:
c1 c2 0 10 100 1 11 110 2 12 120
接下来需要对上述 DataFrame 进行逐行遍历。对于每一行数据,目标是通过列名直接访问对应的元素值(即单元格内容)。具体需求类似于以下代码逻辑:
for row in df.rows:
 print row['c1'], row['c2']
Pandas 是否支持这种操作方式?
我在相关讨论中找到了类似的问题解答,但其中并未直接给出所需答案。相关资料提到:
for date, row in df.T.iteritems():
或者采用以下写法:
for row in df.iterrows():
然而,我对 row 对象的具体含义及其使用方式仍感到困惑。
官方推荐迭代方法对比
推荐的最佳解决方案
若要以符合 Pandas 编程习惯的方式迭代遍历 DataFrame 的行,可以选用以下两种内置方法:
DataFrame.iterrows()
for index, row in df.iterrows():
 print row["c1"], row["c2"]
DataFrame.itertuples()
for row in df.itertuples(index=True, name='Pandas'):
 print getattr(row, "c1"), getattr(row, "c2")
通常情况下,itertuples() 的执行速度优于 iterrows()
但需特别注意,根据官方文档(当前版本为 Pandas 0.19.1)的说明:
- 关于 iterrows:数据的 dtype 可能无法按行准确匹配,因为 iterrows 返回的是每一行的 Series 对象,它不会保留原始的 dtypes(dtypes 仅在 DataFrame 列级别保留)。
- 关于 iterrows:请勿修改行数据
不建议在迭代过程中修改正在遍历的对象。这种做法不能保证在所有情况下都能正常运行。根据数据类型差异,迭代器可能返回副本而非视图,此时进行写入操作将无效。
建议改用 DataFrame.apply() 方法:
new_df = df.apply(lambda x: x * 2) itertuples:列名称可能会被重命名为位置索引名称,如果原列名是无效的 Python 标识符、存在重复或以单下划线开头。当列数量极大(超过 255 列)时,将返回常规元组。
使用 apply 进行行处理
第二种备选方案:apply
你也可以利用 df.apply() 来遍历行,并在函数中访问多个列的数据。
官方文档参考:DataFrame.apply()
def valuation_formula(x, y):
 return x * y * 0.5

df['price'] = df.apply(lambda row: valuation_formula(row['x'], row['y']), axis=1)
其他遍历方案与性能优化
第三种备选方案:iloc
你可以使用 df.iloc 函数实现如下遍历方式:
for i in range(0, len(df)):
 print df.iloc[i]['c1'], df.iloc[i]['c2']
第四种方案:虽然实现稍显繁琐,但效率更高,即将 DataFrame 转换为列表处理
你可以编写一个自定义的 namedtuple 迭代器:
from collections import namedtuple

def myiter(d, cols=None):
 if cols is None:
  v = d.values.tolist()
  cols = d.columns.values.tolist()
 else:
  j = [d.columns.get_loc(c) for c in cols]
  v = d.values[:, j].tolist()

 n = namedtuple('MyTuple', cols)

 for line in iter(v):
  yield n(*line)
该实现等效于 pd.DataFrame.itertuples,但在特定场景下效率更高。
将自定义函数应用于给定的 DataFrame:
list(myiter(df))

[MyTuple(c1=10, c2=100), MyTuple(c1=11, c2=110), MyTuple(c1=12, c2=120)]
或者与 pd.DataFrame.itertuples 进行对比测试:
list(df.itertuples(index=False))

[Pandas(c1=10, c2=100), Pandas(c1=11, c2=110), Pandas(c1=12, c2=120)]
全面的性能测试
我们对所有可用列进行了测试:
def iterfullA(d):
 return list(myiter(d))

def iterfullB(d):
 return list(d.itertuples(index=False))

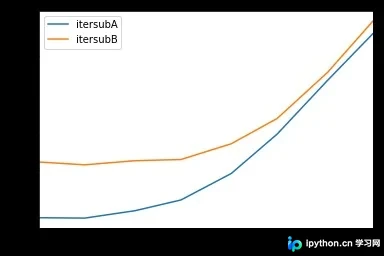
def itersubA(d):
 return list(myiter(d, ['col3', 'col4', 'col5', 'col6', 'col7']))

def itersubB(d):
 return list(d[['col3', 'col4', 'col5', 'col6', 'col7']].itertuples(index=False))

res = pd.DataFrame(
 index=[10, 30, 100, 300, 1000, 3000, 10000, 30000],
 columns='iterfullA iterfullB itersubA itersubB'.split(),
 dtype=float
)

for i in res.index:
 d = pd.DataFrame(np.random.randint(10, size=(i, 10))).add_prefix('col')
 for j in res.columns:
  stmt = '{}(d)'.format(j)
  setp = 'from __main__ import d, {}'.format(j)
  res.at[i, j] = timeit(stmt, setp, number=100)

res.groupby(res.columns.str[4:-1], axis=1).plot(loglog=True);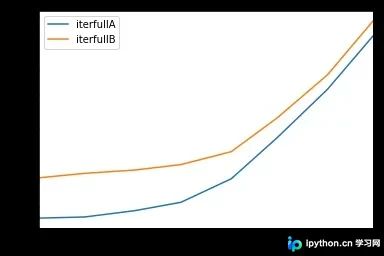
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









