

Python读取大文件处理速度变慢的排查与优化

本文分析Python处理大文件时速度逐渐变慢的现象,排查了GC和Git同步等干扰因素,最终定位到使用in dict.keys()进行键存在性检查导致的性能瓶颈。通过对比测试,推荐使用in dict直接判断或has_key()方法,显著提升处理效率,并解释了Python3中has_key()被移除的背景。
Python大文件处理性能问题背景
背景:
近日同事编写Python代码处理一个约400至500MB的文件,执行一系列逻辑直观的数据处理操作。然而,任务耗时一天仍未完成。我们需要找出导致这一性能问题的根本原因。
解决:
1. 同事在不同处理阶段打印当前时间,在关键代码处插入如下时间记录代码:
print time.strftime('%Y-%m-%d %H:%M:%S',time.localtime(time.time())) 通过观察发现,随着处理进行,单次操作耗时逐渐增加,即程序执行速度越来越慢。
性能瓶颈排查过程
2. 导致速度变慢的原因分析:
1)首先怀疑是垃圾回收(GC)机制的问题。有资料指出Python列表append操作在后期会变慢,尝试通过禁止GC来优化:
使用gc.disable()和gc.enable()控制GC开关。
2)调整GC后问题依旧存在。随后考虑到Git版本控制可能引发的问题,因为append操作可能导致Git不断同步,于是删除.git文件夹,但问题仍未解决。
3)进一步排查发现,极有可能是字典键值检查方式不当。使用in dict.keys()判断key是否存在于dict中,该方式效率极低。参考相关性能对比文章:
① 使用in dict.keys()的效率测试:
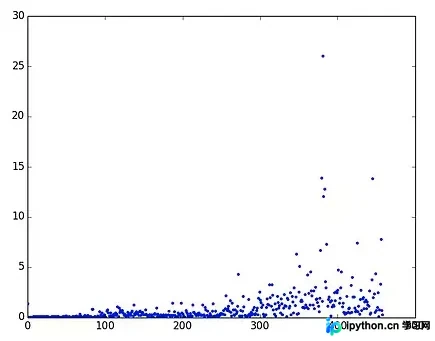
② 使用has_key()的效率测试:
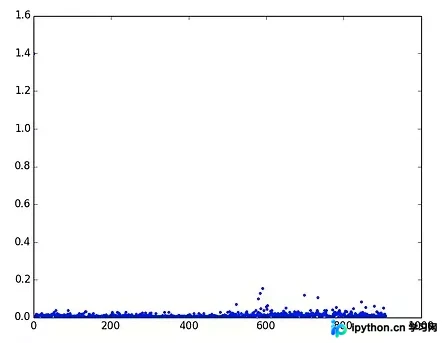
结果显示has_key()效率较为稳定。修改代码后,问题得到解决。
Python字典查找规范与最佳实践
后话:
最初代码确实使用了has_key(),但上传代码时因公司代码审查未通过,提示禁止使用该函数,被迫改为in dict.keys()。经查阅资料得知,Python3中已直接移除has_key()函数,因此公司规范禁止使用。那么禁止后该如何正确判断?Python中的in操作符非常智能,能自动判断key是否存在于字典中。因此,最规范的做法既不是has_key(),也不是in dict.keys(),而是直接使用in dict。判断key在字典中时,切勿使用in dict.keys()!!!
附录:
in、in dict.keys()、has_key()方法实战对比:
>>> a = {'name':"tom", 'age':10, 'Tel':110}
>>> a
{'age': 10, 'Tel': 110, 'name': 'tom'}
>>> print 'age' in a
True
>>> print 'age' in a.keys()
True
>>>
>>> print a.has_key("age")
True
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对本站的支持。
参考资料:
https://www.douban.com/group/topic/44472300/
http://www.it1352.com/225441.html
https://www.jb51.net/article/145424.htm
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









