Python Pandas打印Dataframe时解决省略号显示的完整方法
本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
2026-10-13
6

本文介绍在Python中使用Pandas打印Dataframe时,因行数过多导致中间数据显示省略号的问题。通过调用pandas.set_option()函数,配置display.max_rows为None及调整display.width,即可强制输出完整数据,避免信息截断。
本文介绍如何利用Python pandas库进行数据差分运算。通过df.diff()方法,可实现纵向一阶、横向一阶及多阶(如periods=2)差分计算。文章包含完整代码示例,展示如何处理空值及不同轴向的差分结果,适用于时间序列分析与特征工程场景。
本文介绍如何利用Python的pandas库读取以竖线'|'作为分隔符的文本文件。通过指定sep参数为'|'并设置dtype为'str',可确保所有列数据均按字符串类型处理,适用于20180201.txt等格式文件的快速解析与预处理。
本文介绍使用Python Pandas库将Excel文件转换为CSV格式,并在转换过程中对指定列进行数据处理的方法。通过示例代码展示了如何读取Excel、过滤数据、修改特定列内容(如添加前缀)并保存为CSV文件,适用于需要批量处理Excel数据并生成标准化CSV文件的场景。
本文介绍使用pandas读取CSV文件时,如何通过sep参数指定非默认分隔符。重点解析当字段内容包含制表符等字符时,直接传入位置参数可能导致解析错误,而显式指定sep参数名可有效避免此类问题。
本文介绍在Python中使用Pandas库读取包含中文字符的CSV或文本文件时,如何通过正确设置encoding参数(如'gbk')来避免乱码或解码错误。通过具体代码示例展示读取含中文数据的文件方法,确保数据完整性和兼容性。
本文介绍如何使用pandas将多个DataFrame写入Excel的不同Sheet。重点指出常见错误:误用ExcelFile导致文件保存路径问题,并解析源码揭示其基于xlrd的实现机制。通过正确使用ExcelWriter可避免文件丢失,确保数据持久化。
本文介绍如何使用Python的pandas库实现Excel文件(xlsx)与CSV文件之间的相互转换。通过read_excel和to_csv、read_csv和to_excel等核心函数,可快速完成数据格式迁移,适用于日常数据处理与批量文件转换场景。
在使用pandas保存Excel文件时,直接调用to_excel会覆盖原有文件。本文介绍利用ExcelWriter结合openpyxl引擎,通过load_workbook加载已有工作簿,再写入新Sheet的方法,从而实现在不删除原有Sheet的前提下追加数据。
本文介绍使用pandas向Excel文件写入多个Sheet时的常见陷阱。直接循环调用to_excel会导致后续写入覆盖前次结果,最终文件仅保留最后一次数据。正确做法是利用ExcelWriter对象统一管理写入过程,确保所有Sheet数据完整保存至同一文件中。
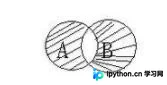
本文介绍在Python中使用pandas库求两个DataFrame不相交部分(对称差集)的方法。核心思路是将两个数据框合并后,利用drop_duplicates函数并设置keep=False参数,直接删除所有重复出现的行,从而保留仅存在于其中一个数据框中的唯一记录。该方法简洁高效,适用于无重复内容的集合运算场景。
本文介绍如何利用Python脚本,结合pandas读取包含图片类别信息的CSV表格,并通过os和shutil库自动创建文件夹及移动图片。该方法适用于需要将大量图片按预设标签(如0-19类)批量整理至独立目录的场景,代码已优化修正,可直接参考使用。