

pandas滚动窗口函数rolling参数详解与实战应用
本文详解pandas中rolling函数的核心参数与用法。重点解析window类型(int与offset)、min_periods、center及closed等关键配置,并通过物流场景示例,展示如何结合groupby实现基于时间的滚动聚合计算,提供高效的数据处理方案。
2026-10-13
6

本文详解pandas中rolling函数的核心参数与用法。重点解析window类型(int与offset)、min_periods、center及closed等关键配置,并通过物流场景示例,展示如何结合groupby实现基于时间的滚动聚合计算,提供高效的数据处理方案。
本文介绍如何使用Pandas库中的apply函数对DataFrame指定列进行批量条件赋值。通过定义自定义函数并结合lambda表达式,实现如数值大于等于阈值赋1、否则赋0的逻辑,帮助开发者高效处理数据清洗与特征工程中的条件转换任务。
本文详细介绍如何使用Python的Pandas库绘制移动平均线。通过读取数据文件,利用rolling_mean函数计算指定周期的移动平均值,并结合Matplotlib进行可视化展示。文章包含完整代码示例及运行方法,适合希望掌握金融数据分析或时间序列处理的用户参考。
本文介绍如何在Python Pandas中使用fillna方法结合ffill参数实现DataFrame的向下填充,以及使用bfill进行向上填充。通过构建包含姓名、日期和房产数量的示例数据,演示如何将稀疏数据转换为连续时间序列,并处理缺失值,适用于需要基于最近已知值进行数据补全的场景。
本文介绍利用pandas库中的loc索引器为DataFrame添加新列的具体方法。通过设定筛选条件并赋值,可实现基于现有数据的列生成。若新列名与已有列名重复,则直接修改原列数据。该方法操作简便,是数据处理中的基础且高效技巧。
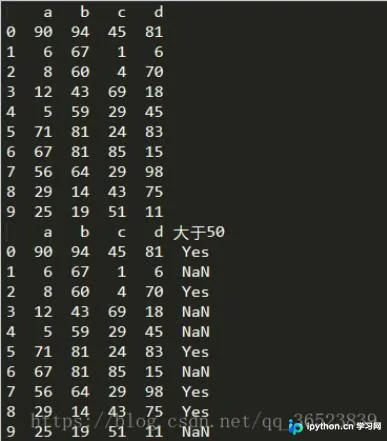
本文介绍如何在pandas中利用apply函数结合多列数据生成新列。通过定义接收多个参数的自定义函数,并设置axis=1逐行处理,实现复杂逻辑计算。示例展示了如何基于diff和shift生成的相邻行数据,计算绝对值最小值,为复杂数据变换提供参考。
本文详解在pandas多重索引(MultiIndex)中筛选指定行的方法。针对有序索引,演示如何利用loc结合元组与slice(None)进行高效切片;针对无序索引,解析UnsortedIndexError报错原因,并介绍通过sort_index排序后正确筛选的流程,帮助开发者避开索引操作的常见陷阱。
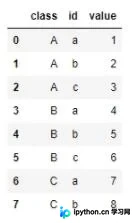
本文介绍在Pandas中处理因多聚合函数生成的多层索引问题。当使用groupby进行复杂聚合时,生成的Column Level具有层次结构,虽利于阅读但不便编程访问。文章详细演示了两种降级方法:一是直接去除外层索引以简化结构,二是将多层列名合并为单层字符串,从而提升代码定位效率。
本文详细介绍Pandas中多重索引(MultiIndex)的创建方法、层级值获取及基本索引操作。通过具体代码示例,演示如何利用get_level_values提取索引信息,以及使用reindex进行数据对齐时NaN值的处理逻辑,帮助开发者掌握复杂索引结构下的数据操作技巧。
本文详细介绍Pandas中GroupBy对象的几种核心索引与迭代方法。通过GroupBy.iter()可遍历分组,返回组名与子DataFrame;groups属性展示组名及对应索引列表;indices返回类似但为数组形式;get_group()用于提取特定分组数据。结合示例代码,帮助开发者高效处理分组数据。
本文介绍如何利用pandas库中的sort_index方法对DataFrame进行索引排序。通过创建示例数据框并调用该函数,展示如何按索引值升序排列数据,适用于需要依据特定索引顺序处理数据的场景。
针对pandas透视表对中文排序支持不佳的问题,本文介绍一种通过数字映射实现自定义排序的方法。核心思路是将需要特殊排序的中文列转换为对应的数字序列,生成透视表后,再将索引或列名中的数字替换回中文,从而获得符合预期顺序的透视表结果。