Pandas批量数据处理指南:map、apply与applymap的高效用法
本文深入解析Pandas中map、apply和applymap三个核心函数的用法与区别。通过实际案例演示如何将Series或DataFrame中的数据批量映射到函数、字典或Series中,并对比传统遍历与list暂存方法的性能。实验表明,使用内置映射函数处理数据可提升500倍以上的速度,是高效数据清洗与转换的关键工具。
2026-10-14
6

本文深入解析Pandas中map、apply和applymap三个核心函数的用法与区别。通过实际案例演示如何将Series或DataFrame中的数据批量映射到函数、字典或Series中,并对比传统遍历与list暂存方法的性能。实验表明,使用内置映射函数处理数据可提升500倍以上的速度,是高效数据清洗与转换的关键工具。
本文详解Pandas读取超过65536行Excel文件报错的原因,指出xlrd引擎的行数限制,并提供使用openpyxl引擎的解决方案。同时包含利用xlrd结合requests进行接口测试并写入Excel的完整代码示例及注意事项。
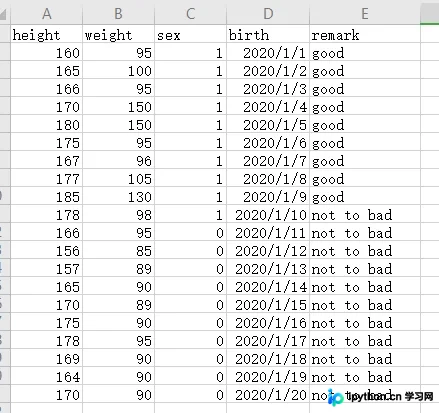
本文详细介绍Python中Pandas库的核心用法,涵盖DataFrame与Series数据结构、CSV及Excel文件的读写操作。通过实例演示如何创建数据表、筛选截取数据、处理缺失值与重复项,以及分组统计与合并技巧,帮助初学者快速掌握数据分析基础。
本文详细介绍如何利用Python从PDF文件中提取表格数据,并将其转换为适合分析的CSV格式。内容涵盖从原始数据导入、一维数据重塑、百分比符号去除到数据类型转换的全过程,通过具体代码示例展示如何清洗和导出最终数据,帮助数据科学家高效处理非结构化文档中的表格信息。
本文详细介绍在 Windows 10 系统中使用 Python 3 连接 Hive 数据仓库的完整流程。重点讲解通过本地安装 impyla 及相关依赖库(如 thrift-sasl)解决兼容性问题,并提供基于 Impyla 和 Pandas 读取数据的代码示例,帮助开发者快速实现大数据探索与分析。
本文详细解析Pandas中replace()函数的多种用法,涵盖全表替换、指定列替换、字典与列表形式替换以及正则表达式匹配。重点讲解inplace参数的影响及str.replace在部分字符替换中的应用,帮助开发者高效完成数据清洗任务。
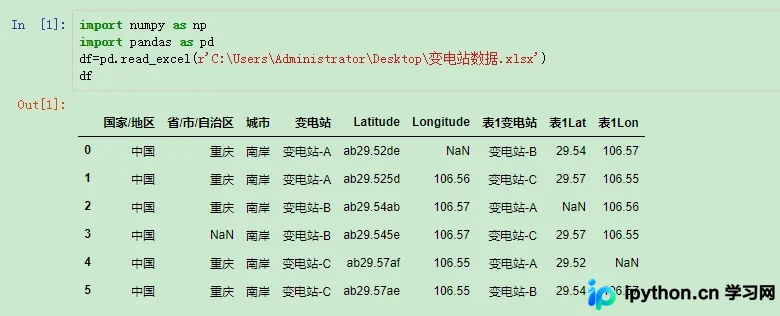
本文详细介绍如何使用Python通过pymysql库连接MySQL数据库。内容涵盖环境安装、连接参数配置、利用pandas read_sql及游标cursor两种方式读取数据,以及插入、更新、删除等事务处理与结果获取方法,帮助开发者快速实现数据库交互。
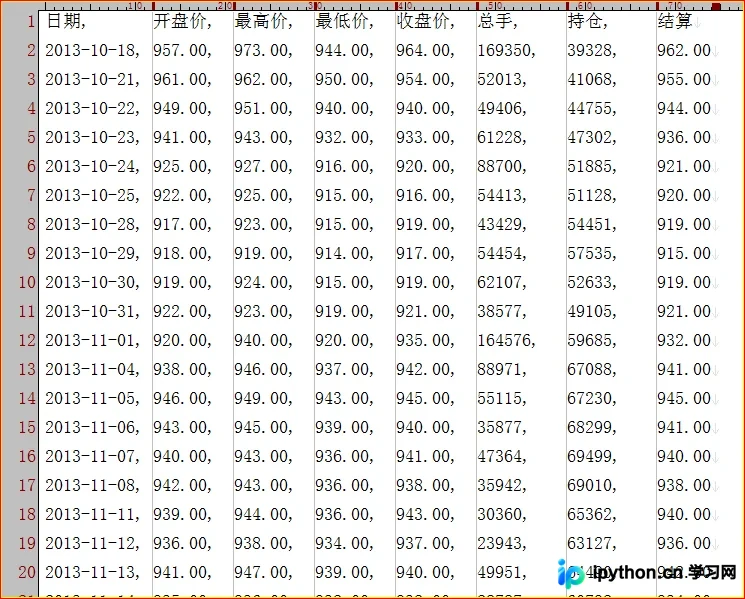
本文介绍如何使用Python的pandas库读取CSV文件并合并两个股票数据集。通过示例代码展示如何将螺纹钢与铁矿石数据按日期关联,实现类似SQL left-join的效果,为后续使用matplotlib绘制历史相关性图表奠定基础。
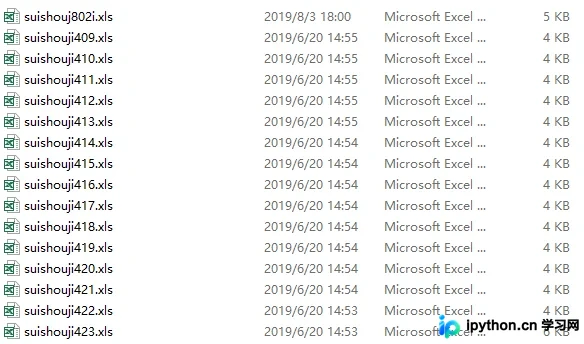
本文介绍利用Python和Pandas库批量合并多个Excel文件(包括xls和CSV格式)的方法。通过遍历目录获取文件列表,逐行读取为DataFrame并加入列表,最后使用pd.concat进行拼接,最终导出为单个CSV文件,解决手工复制效率低下的问题。
本文通过实际案例展示如何利用Python的Pandas库高效处理多张Excel文件。针对90个品牌销售数据,通过计算销售额、按品牌汇总及排序,快速筛选出销售额前五的品牌。相比传统Excel操作,该方法大幅提升了数据处理效率,适合非程序员及数据分析师使用。
本文深入解析Python Pandas中Merge函数的核心原理,重点讲解多对一(m vs 1)数据合并场景。通过对比Excel VLOOKUP,详细演示如何指定Key、处理重复值,并解析left/right/inner/outer等how参数的具体行为。结合真实服务器软件管理案例,展示从读取数据、执行合并、处理后缀列到条件筛选及导出Excel的完整操作流程。
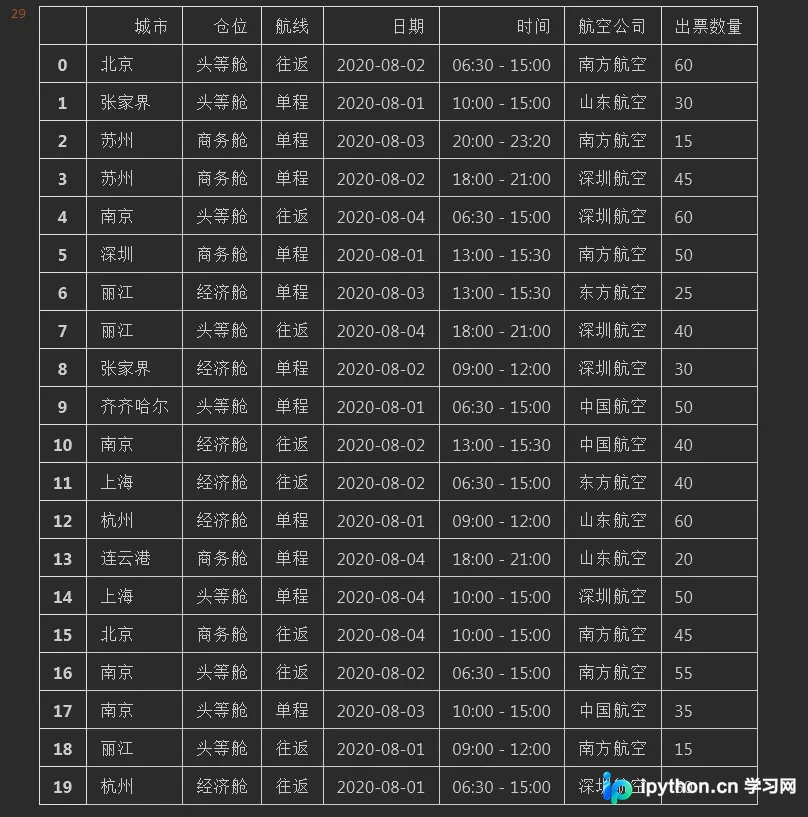
本文解析如何利用Python Pandas中的CategoricalDtype实现中文列的自定义排序。通过定义Category类型并指定categories列表顺序,可解决默认UTF-8编码排序不满足需求的问题。结合pivot_table透视表,灵活展示按特定逻辑(如舱位等级)排序的数据,提升数据清洗与展示效率。