

解决Pandas读取超过65536行Excel文件报错及数据写入示例

本文详解Pandas读取超过65536行Excel文件报错的原因,指出xlrd引擎的行数限制,并提供使用openpyxl引擎的解决方案。同时包含利用xlrd结合requests进行接口测试并写入Excel的完整代码示例及注意事项。
问题场景与分析
场景
在处理天猫订单数据合并任务时,由于6.18大促期间数据量巨大,需要将多个月份的数据进行整合,操作过程中遇到了报错。
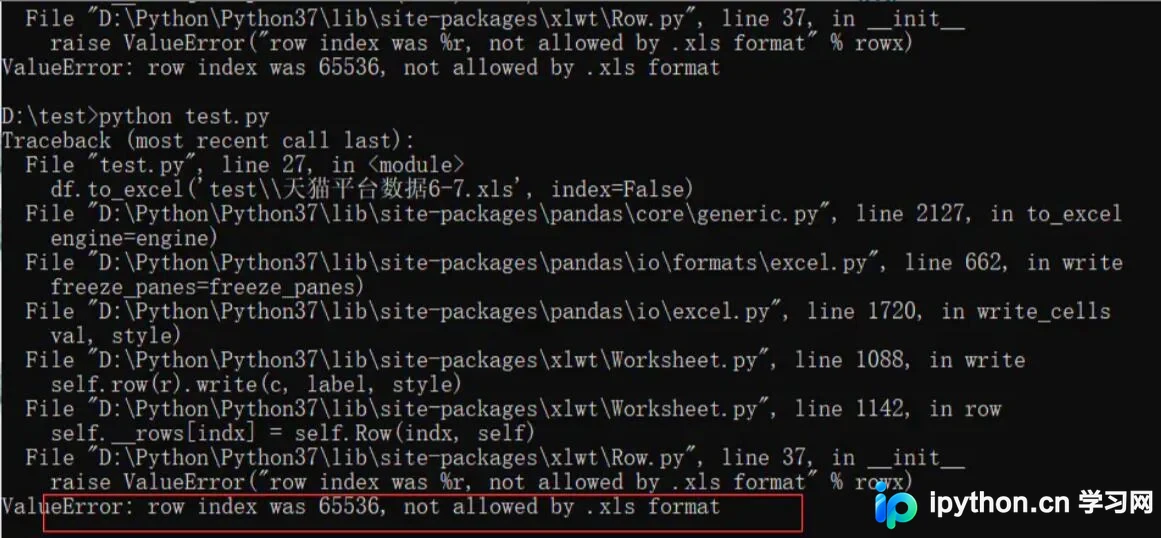
问题分析
Excel文件格式经历过一次重大变更。在Excel 2007版本之前,使用的是扩展名为.xls的二进制格式,该格式最大仅支持65,536行和256列。自Excel 2007起,默认采用基于XML的.xlsx格式,支持行数提升至1,048,576行,列数提升至16,384列。需特别注意,若将.xlsx文件另存为.xls格式,超出65536行和256列的数据将被丢弃。
Pandas读取Excel文件默认使用的引擎是xlrd。尽管xlrd兼容.xls和.xlsx两种格式,但其源码(xlrd/sheet.py)中硬编码限制了读取行数必须小于65536,列数必须小于256。
if self.biff_version >= 80:
  self.utter_max_rows = 65536
else:
  self.utter_max_rows = 16384
self.utter_max_cols = 256
因此,即使文件本身是.xlsx格式,若使用xlrd引擎,依然无法读取超过65536行的Excel文件(源码中还有一个针对Excel 95时代.xls格式的最大行数限制16384)。
解决方案
解决办法
推荐使用openpyxl库,它是专门用于操作.xlsx格式的Python库,其对最大行列数的支持与.xlsx文件定义的标准一致。
首先安装openpyxl:
pip install openpyxl
在Pandas的read_excel方法中,通过指定engine参数为openpyxl,即可正常读取文件。
import os
import pandas as pd

# 将文件读取出来放一个列表里面

pwd = '1' # 获取文件目录

# 新建列表,存放文件名
file_list = []

# 新建列表存放每个文件数据(依次读取多个相同结构的Excel文件并创建DataFrame)
dfs = []

for root,dirs,files in os.walk(pwd): # 第一个为起始路径,第二个为起始路径下的文件夹,第三个是起始路径下的文件。
  for file in files:
    file_path = os.path.join(root, file)
    file_list.append(file_path) # 使用os.path.join(dirpath, name)得到全路径
    df = pd.read_excel(file_path) # 导入xlsx文件,将excel转换成DataFrame
    dfs.append(df)

# 将多个DataFrame合并为一个
df = pd.concat(dfs)

# 数据输出,写入excel文件,不包含索引数据
# 数据写入 Excel,需要首先安装一个 engine,由 engine 负责将数据写入 Excel,pandas 使用 openpyx 或 xlsxwriter 作为写入引擎。
df.to_excel('test\\1.xlsx', index=False,engine='openpyxl') # 导出 Excel,一般不需要索引,将 index 参数设为 False
Excel数据读取与接口测试写入示例
补充知识:python使用xlrd读取excel数据作为requests的请求参数,并把返回的数据写入excel中
实现功能:
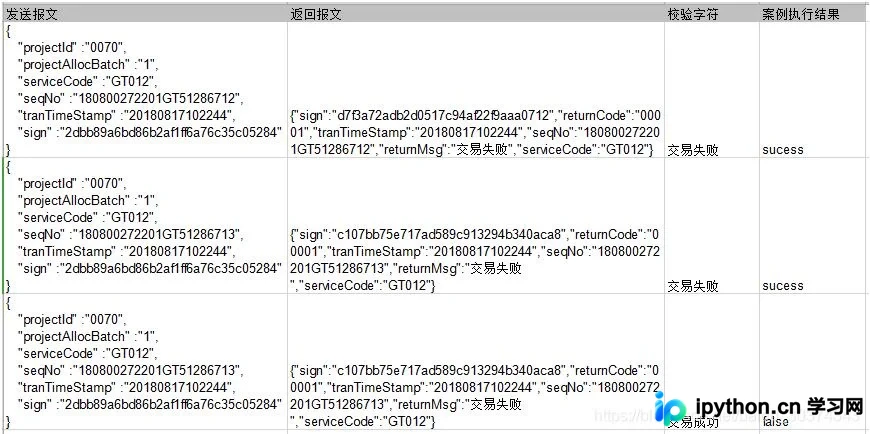
从Excel第一列读取数据作为POST请求的JSON格式参数;将POST接口返回的结果写入Excel第二列,并与Excel中的预期结果进行比对。若一致,则在“案例执行结果”列标记为成功,否则标记为失败。
每一行的数据均不同,脚本支持循环调用处理。
# !/usr/bin/env python
# -*- coding:utf-8 -*-
#import xlwt #这个专门用于写入excel的库没有用到
import xlrd
from xlutils.copy import copy
import requests
import json
old_excel = xlrd.open_workbook('excel.xls')
sheet = old_excel.sheets()[0]
url = 'http://10.1.1.32:1380/service/allocFk2'
headers = {'Content-Type': 'application/json'}
i = 0
new_excel = copy(old_excel)
for row in sheet.get_rows():
  data = row[0].value
  response = requests.post(url=url, headers=headers, data=data)
  text = response.text
  #使用json.loads可以把Unicode类型,即json类型转换成dict类型
  text = json.loads(text)["returnMsg"] #屏蔽这行代码即可把返回的完整数据写入文件中
  ws = new_excel.get_sheet(0)
  ws.write(i,1,text)
  new_excel.save('excel.xls')
  old_excel = xlrd.open_workbook('excel.xls')
  new_excel = copy(old_excel)
  i = i+1
执行前的Excel格式:
| 发送报文 | 返回报文 | 校验字符 | 案例执行结果 |
| { "projectId" :"0070", "projectAllocBatch" :"1", "serviceCode" :"GT012", "seqNo" :"180800272201GT51286712", "tranTimeStamp" :"20180817102244", "sign" :"2dbb89a6bd86b2af1ff6a76c35c05284" } | 交易失败 | ||
| { "projectId" :"0070", "projectAllocBatch" :"1", "serviceCode" :"GT012", "seqNo" :"180800272201GT51286713", "tranTimeStamp" :"20180817102244", "sign" :"2dbb89a6bd86b2af1ff6a76c35c05284" } | 交易失败 | ||
| { "projectId" :"0070", "projectAllocBatch" :"1", "serviceCode" :"GT012", "seqNo" :"180800272201GT51286713", "tranTimeStamp" :"20180817102244", "sign" :"2dbb89a6bd86b2af1ff6a76c35c05284" } | 交易成功 |
执行后的结果:
调试过程中遇到的问题:
1、在for循环末尾未添加以下两行代码:
old_excel = xlrd.open_workbook('excel.xls')
new_excel = copy(old_excel)
若不重新获取并复制工作簿,new_excel将始终指向初始获取的对象,导致只有最后一次循环的写入结果生效,因为之前的写入均被初始的old_excel覆盖。因此,每次执行写入操作后,必须重新执行copy操作,以确保new_excel引用的是最新状态。
2、执行脚本前务必关闭Excel文件,否则程序会报错。
以上这篇解决使用Pandas 读取超过65536行的Excel文件问题就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









