

Python Pandas Merge函数原理与实战:多对一数据合并详解

本文深入解析Python Pandas中Merge函数的核心原理,重点讲解多对一(m vs 1)数据合并场景。通过对比Excel VLOOKUP,详细演示如何指定Key、处理重复值,并解析left/right/inner/outer等how参数的具体行为。结合真实服务器软件管理案例,展示从读取数据、执行合并、处理后缀列到条件筛选及导出Excel的完整操作流程。
Merge函数的基本用法与场景分类
Merge函数的基本用法
从功能逻辑上看,Pandas中的Merge函数类似于Excel中的VLOOKUP函数。当需要将两个表格的数据进行合并时,必须指定两个表中具有相同含义的列作为连接键(Key),系统依据该Key进行匹配,并将目标表中对应的值(Values)合并到结果集中。
在Pandas中,Merge操作主要涵盖三种场景:一对一(1 vs 1)、多对一(m vs 1)以及多对多(m vs m)。在实际业务应用中,最为常见的是多对一场景。该场景的特征是:参与合并的两个表中,其中一个表的Key列包含重复值,而另一个表的Key列值保持唯一。
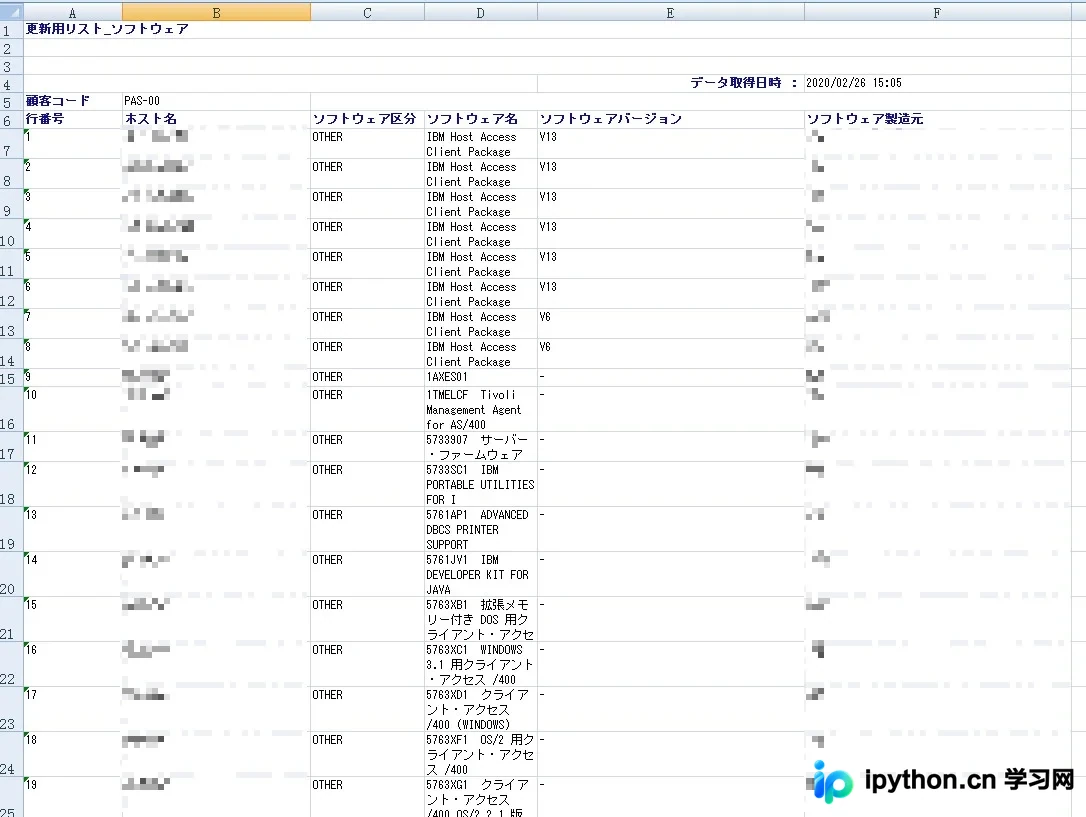
理解这一场景可参考生产环境中的服务器管理案例。一台服务器上通常安装了多种软件,若使用Excel表格记录,每条软件信息占一行,而服务器名称相同。因此,同一服务器名会在表格中多次出现,形成重复记录。
具体而言,服务器上安装的软件数量决定了服务器名重复出现的次数,即最终生成的行数。若另一张表需要读取该服务器上安装的所有软件信息,则需以服务器名作为Key进行匹配,而软件的具体信息作为Value值。在此过程中,被读取并写入的目标表,其Key列必须保持唯一性。
下文将展示一个真实的多对一(m vs 1)合并案例。出于数据安全考虑,文中对截图中的服务器名称进行了遮挡处理,敬请谅解。
数据表1:作为查询的基础总表,其中服务器名(Hostname)这一列的信息存在重复值。
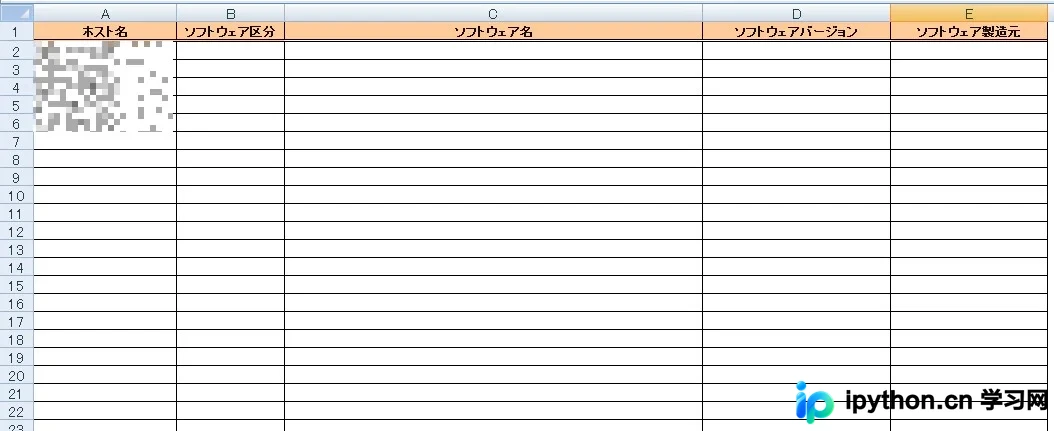
数据表2:该表以表1的Key(即hostname)为匹配依据,匹配成功后,按照表2的列名读取相应信息并写入表2。同样,因服务器名称涉及敏感信息,此处已进行马赛克处理,望谅解。
Python Pandas Merge实战代码演示
代码演示部分
第一步:读取表1和表2的内容,将其转换为DataFrame对象并赋值给相应变量。
#%%

import pandas as pd

#读取表1
df01 = pd.read_excel("./datas/new_all_datas.xlsx",
           header=5)
df01.head()

#%%

#读取表2
df02 = pd.read_excel("./datas/new_software_InputSheet.xlsx")
df02

#%%
第二步:利用Merge函数合并两个DataFrame。参数on用于指定作为匹配依据的Key列;参数how用于指定合并方式,包括left、right、inner、outer等。此处使用left表示以左侧表(即表1)为主表进行合并,保留左表的所有记录。
#%%
#ホスト名作为key来匹配两个表,相当于vlookup函数
#how=left代表以left左表为主,这里则代表表二为左表
df03 = pd.merge(df02,df01,on="ホスト名",how="left")
df03
合并结果如示例所示。由于表1和表2中存在名称相同的列,Pandas会自动添加后缀(如_x、_y)以区分来自不同表的同名列,从而生成多列。
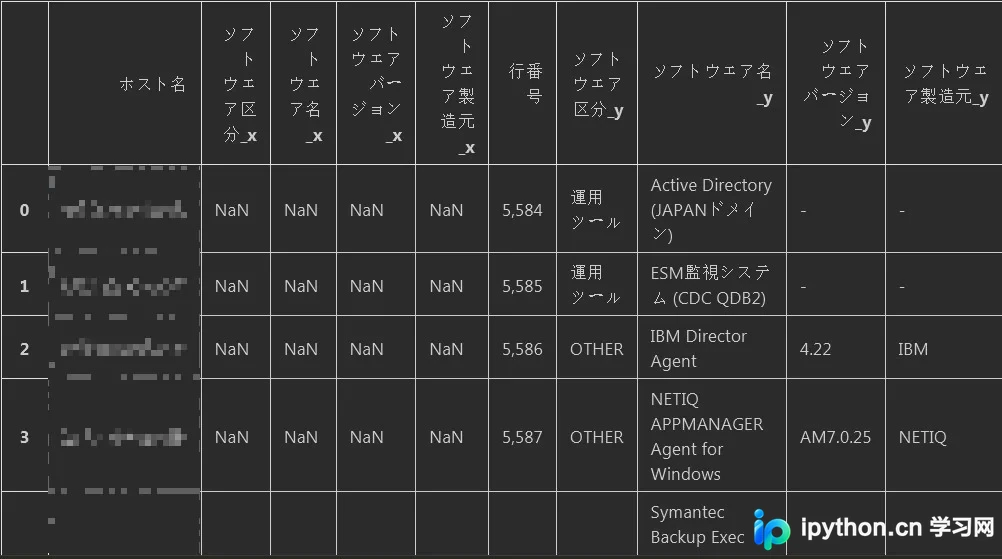
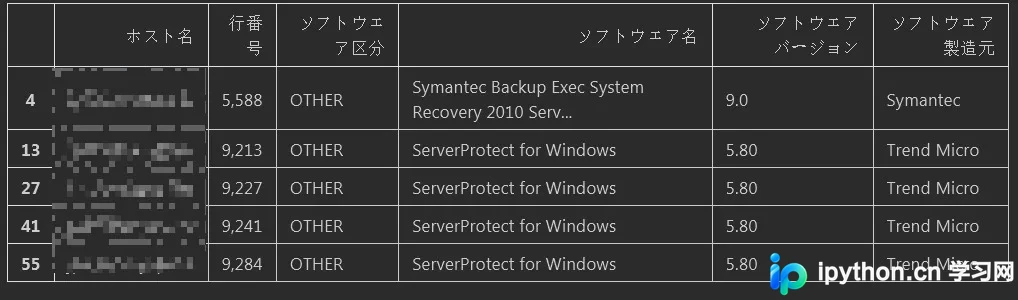
第三步:去除无用列,并根据特定条件查询所需数据。本例的需求是:根据服务器名,筛选出软件名为“Trend Micro”或软件制造商为“Symantec”的所有行。
#%%
#因为表中有相同的列名因此自动后缀被加上了_y
#下面代表筛选查询范围,以及指定查询值
df03 = df03.loc[:,["ホスト名","行番号","ソフトウェア区分_y","ソフトウェア名_y","ソフトウェアバージョン_y","ソフトウェア製造元_y"]]
df04 = df03[(df03["ソフトウェア名_y"]=="Trend Micro") | (df03["ソフトウェア製造元_y"]=="Symantec")]

#重新把列名设定换一下然后输出
df04.columns = ["ホスト名","行番号","ソフトウェア区分","ソフトウェア名","ソフトウェアバージョン","ソフトウェア製造元"]
df04
查询结果如下所示。
第四步:将处理后的数据导出至Excel文件。
#%%

with pd.ExcelWriter("./datas/output_mergedatas.xlsx") as writer:
  df04.to_excel(writer,index=False)
  print("Done!!")
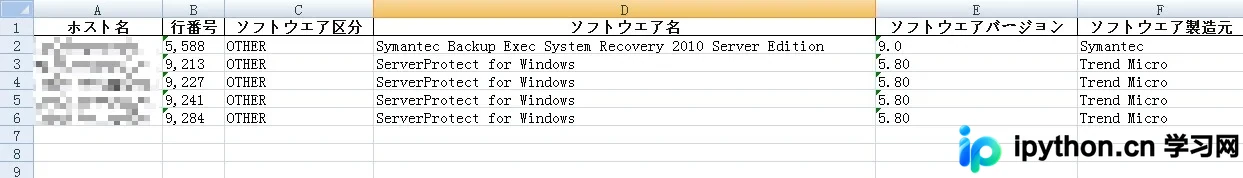
导出结果如示例所示。当然,处理后的数据也可以直接写入原数据表2中。此处为了保持原始数据表的完整性,未做修改,而是将结果作为新的Excel文件导出。
数据清洗技巧与总结
在日常业务中,若遇到类似的数据合并场景,建议尝试使用Merge函数。此外,还可结合loc切片操作以及后续介绍的pivot和pivot_table透视表功能,实现对数据更丰富、更深入的清洗与分析。
总体而言,习惯使用Pandas后,会发现其相比Excel中的函数及宏命令,具备更高的灵活性和更强大的数据处理能力。
以上就是本文的全部内容,希望对大家的学习有所帮助,也欢迎大家继续支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









