

Python Pandas中extract与contains方法实战解析
本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
2026-10-14
6

本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
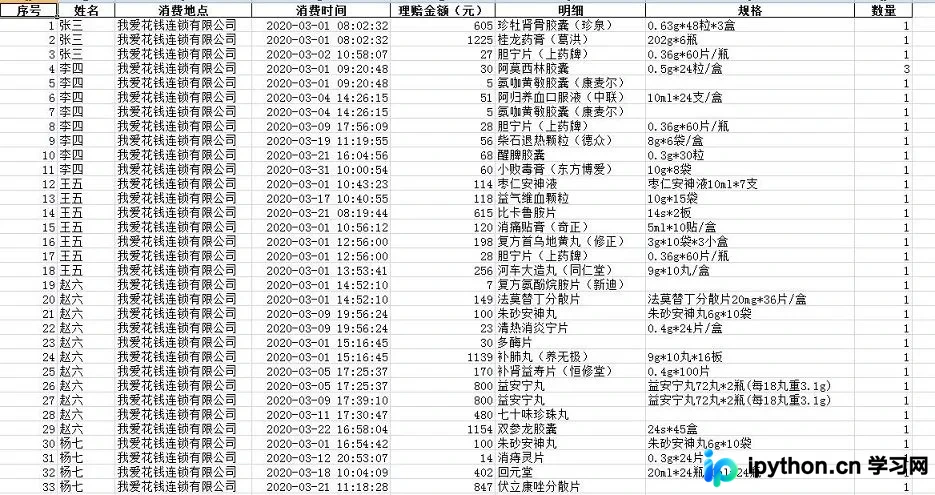
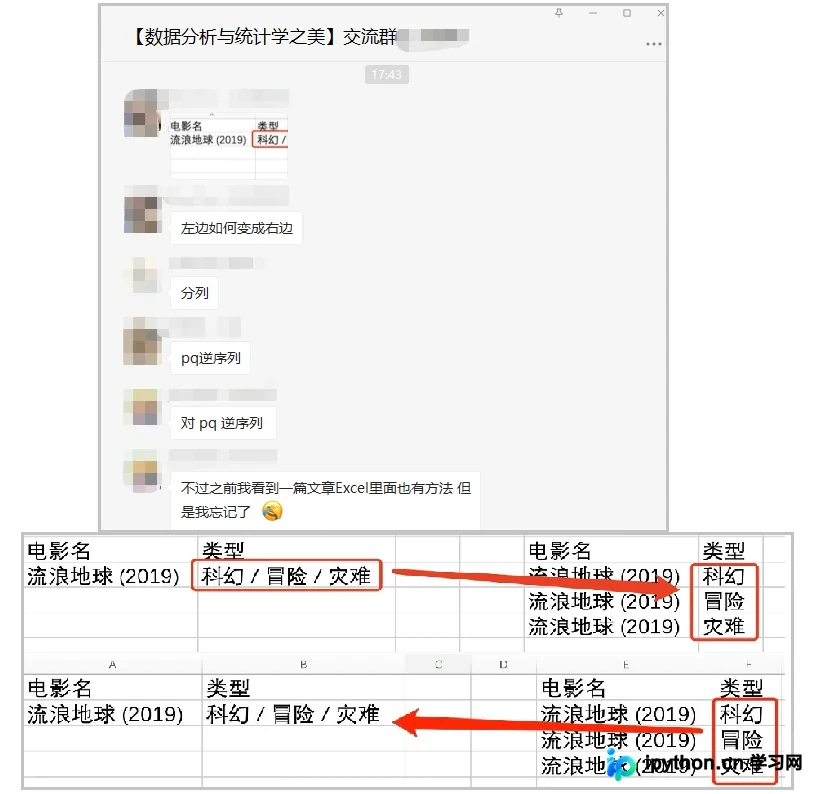
本文介绍在Python Pandas中处理数据结构的两种常见操作:一行拆多行和多行并一行。通过Pandas.melt与str.split组合,以及新增的explode方法,分别实现拆分逻辑;利用groupby聚合函数完成合并。文章提供完整代码示例与关键参数说明,帮助开发者高效解决数据重塑问题。
本文介绍如何利用Python的Pandas库高效筛选Excel数据。通过详解loc函数的标签索引与布尔数组用法,结合isin判断集合成员及str.contains匹配字符串,实现按条件或特定值提取行。同时演示如何选取特定列并保留DataFrame类型,帮助数据分析人员快速处理特征数据。
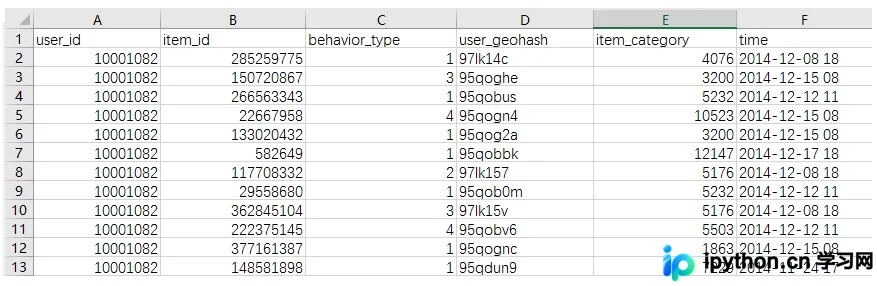
本文介绍pandas中常用的参数设置方法,包括通过pd.set_option()控制最大显示行数、列数及列宽,利用chop_threshold隐藏小数值,以及浮点数格式化和精度调整。同时讲解如何使用option_context进行临时参数修改,帮助开发者灵活优化数据展示效果。
本文通过分析Python中pandas与numpy处理数据时遇到的浮点数舍入异常,揭示了np.round函数遵循“向偶数舍入”的IEEE标准机制。针对0.5这类中间值导致的偏差,文章提供了基于小数位判断的修正算法,确保数据处理的准确性。
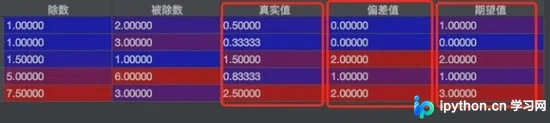
本文整理了13个Pandas高频使用技巧,涵盖计算变量缺失率、获取分组最大值行、多列合并、特定字符串行删除、组内排序、类型筛选、字符串转数值、内存占用优化、最大类别筛选、字符串分割、列表转DataFrame、多函数聚合及字典分组等场景,帮助开发者提升数据处理效率。
本文详解如何在Python中使用多线程加速pandas的apply操作。通过对比多线程与多进程,介绍利用multiprocessing.Pool进行数据分割与并行执行的方法,包含进程初始化、共享变量设置及完整代码示例,帮助提升数据处理效率。
本文详细介绍Python中读写CSV文件的两种主流方法。首先讲解使用内置csv库进行基础读写操作,包括列名解析与数据写入;随后介绍利用pandas库处理大规模数据的更高效方案,涵盖读取、列重命名及数据导出等高级功能。通过具体代码示例,帮助开发者掌握不同场景下的最佳实践。
本文介绍了8种最常用的Python工具,涵盖开发、自动化测试、数据科学与机器学习领域。包括内置的IDLE、机器学习的Scikit-learn、深度学习的Theano、自动化的Selenium与Test Complete,以及数据处理的Beautiful Soup、Pandas和线性规划工具PuLP。这些工具能显著提升开发效率与数据处理能力。
本文介绍在Python数据分析中,如何处理不规范的时间序列数据。通过Pandas库将包含斜杠的时间字符串替换为横杠,截取至秒级,并利用pd.to_datetime转换为Timestamp格式,最终设置时间列为索引,为后续分析奠定基础。
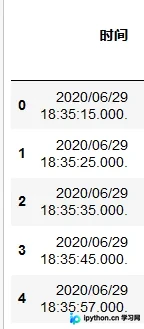
本文系统讲解Pandas库中数据清洗与转换的核心指令。涵盖缺失值检测与处理,包括使用dropna过滤、fillna填充及thresh参数控制;详解数据去重方法duplicated与drop_duplicates;介绍replace替换、rename重命名及get_dummies生成One-hot编码的技巧,助力高效数据预处理。
本文详细介绍Python中如何使用内置csv模块高效读写CSV文件。内容涵盖基础读写、使用命名元组和字典简化字段访问、处理特殊分隔符及编码,以及手动类型转换和错误处理机制,最后推荐Pandas用于高级数据分析。