Python StatsModels统计回归模型数据准备与预处理实战
本文详解Python中利用StatsModels进行统计回归分析前的数据准备工作。内容涵盖从CSV、Excel及TXT文件读取数据,使用pandas进行数据拆分合并,以及缺失值、重复值和异常值的预处理方法,并附带完整代码示例。
2026-10-14
6

本文详解Python中利用StatsModels进行统计回归分析前的数据准备工作。内容涵盖从CSV、Excel及TXT文件读取数据,使用pandas进行数据拆分合并,以及缺失值、重复值和异常值的预处理方法,并附带完整代码示例。
本文深入解析Python Pandas库中的时间处理功能,涵盖Timestamp、TimeDeltas、Time spans及Date offsets四大核心类型。通过具体代码示例,详细演示如何创建DatetimeIndex、PeriodIndex,利用date_range生成时间序列,以及处理时区、频率转换和重新取样等高级操作,帮助开发者高效处理复杂的时间数据。
本文总结了pandas中创建DataFrame的三种主要方式:通过列表或数组、通过字典参数以及直接读取Excel和CSV文件。文章详细讲解了各方法的代码实现与参数设置,并指出实际工作中直接读取数据文件是最高效且常用的做法,适合初学者快速掌握数据框构建技巧。
本文深入解析Python Pandas库中loc和iloc两个核心索引函数的区别。loc基于标签(Label)进行数据选取,支持切片包含右边界;iloc基于整数位置(Position)进行索引,遵循左闭右开原则。通过具体代码示例对比两者在行列选取时的不同表现,帮助开发者准确掌握数据筛选技巧。
本文详解Pandas中DataFrame的数据删除操作,重点讲解drop和del两种方法。通过默认索引和自定义索引两种场景,演示单行、多行及连续列的删除代码与结果,帮助开发者掌握高效的数据清洗技巧。
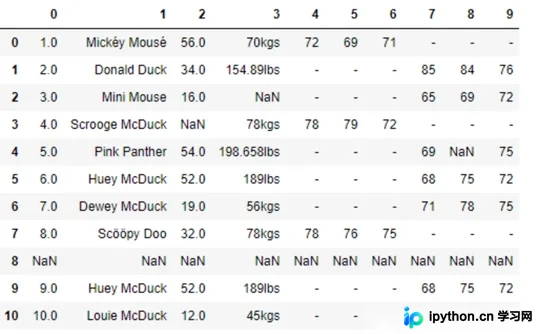
本文详细讲解利用pandas进行会员数据清洗的完整流程。内容涵盖完整性检查(缺失值均值/众数填充、空行删除)、全面性处理(单位统一换算)、合法性校验(非ASCII字符过滤)及唯一性保障(字段拆分与重复记录移除)。通过具体代码示例,展示如何高效清理服装店会员数据,确保数据质量。
本文详解如何使用Python进行数据相关性分析并批量绘制散点图。通过结合Pandas、Matplotlib和Seabon库,演示如何读取CSV数据,计算Pearson相关系数,并在生成的散点图中自动标注相关数值。代码示例展示了从数据预处理到图像保存的完整流程,帮助开发者快速实现可视化结果输出。
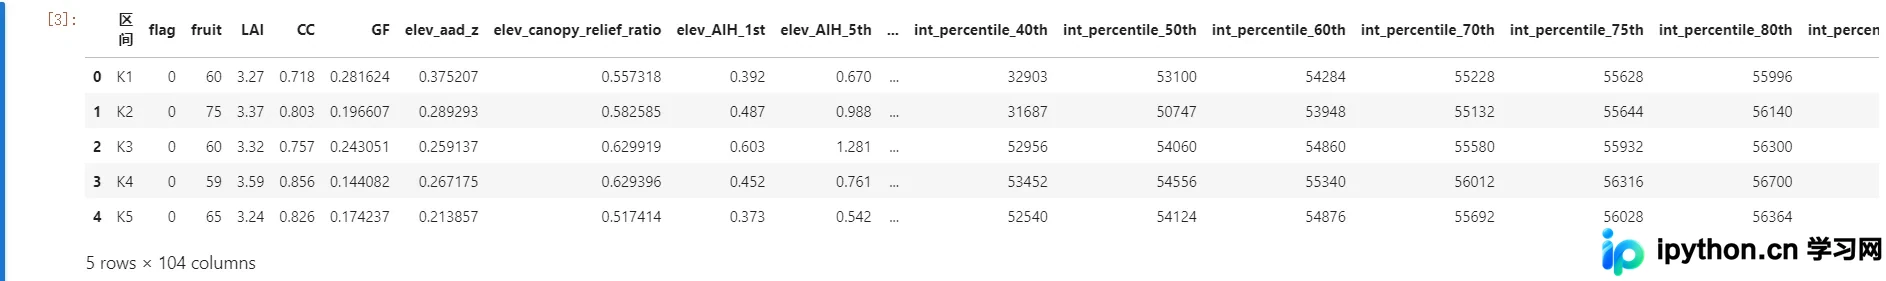
本文详细介绍在Python pandas中如何处理数据重复问题。通过sample函数进行加权采样,使用append方法合并数据集,最后利用drop_duplicates根据特定列(如id)去除重复项,实现数据的清洗与更新。
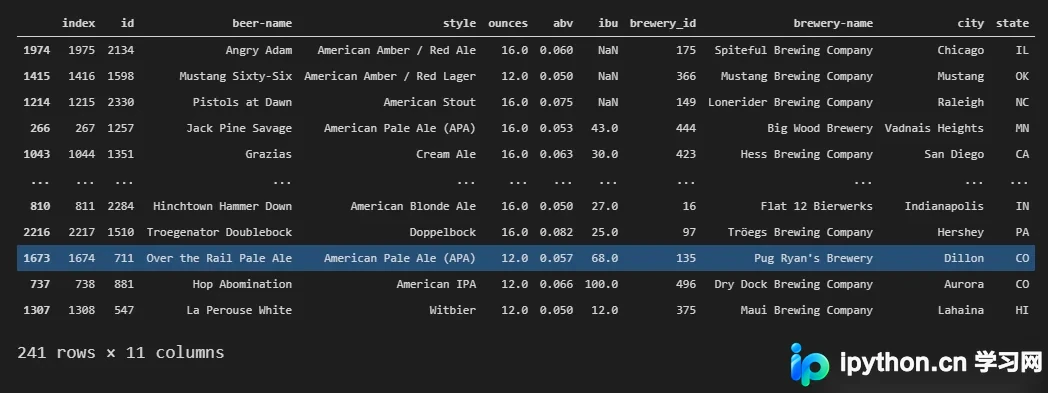
本文详细介绍在pandas中处理重复数据的完整流程。通过sample函数进行加权抽样,利用append方法合并数据集并更新特定列值,最后使用drop_duplicates根据指定列(如id)去除重复项。文章涵盖sample和append的参数说明及代码示例,帮助开发者掌握数据清洗中的去重技巧。
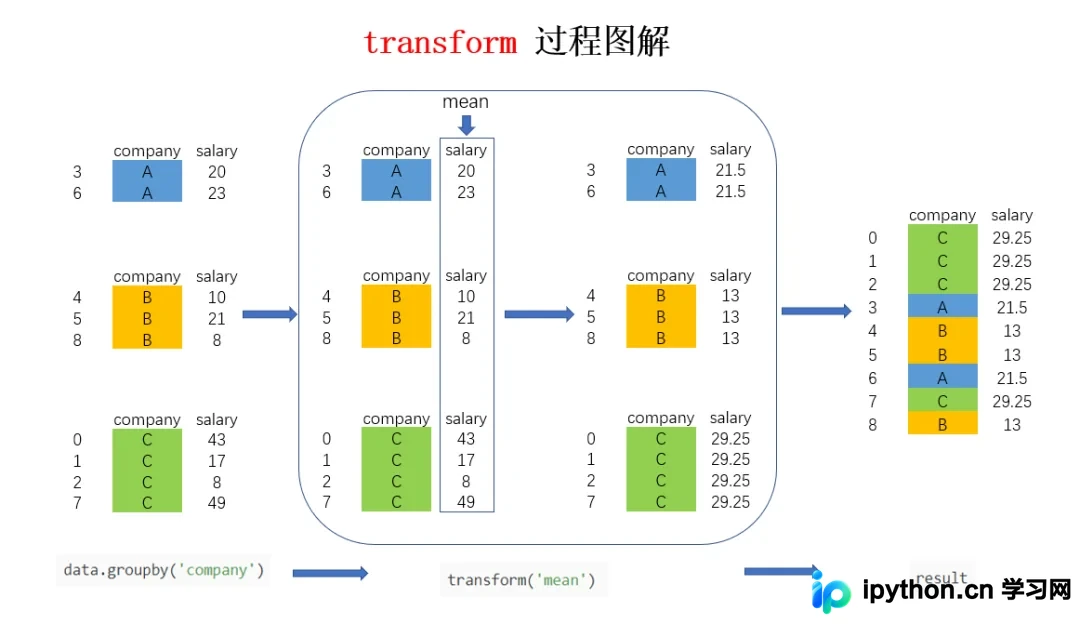
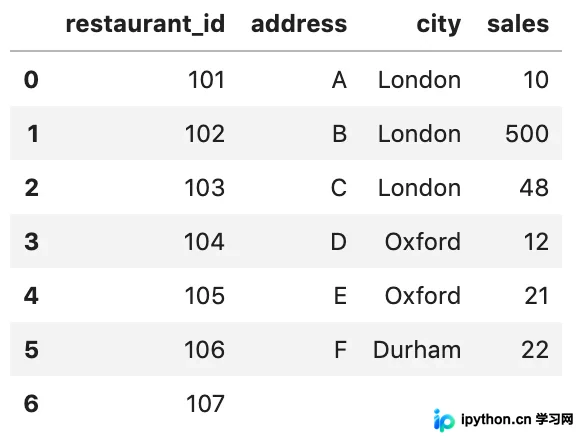
本文详解Pandas中groupby与transform的结合用法。通过餐厅销售数据示例,对比两种计算组内百分比的方案:方案一使用apply或sum聚合后merge合并,步骤繁琐;方案二利用transform直接返回与原数据等长的新列,代码更简洁。文章重点解析transform在分组后保持索引一致性的特性,帮助开发者高效处理分组统计问题。
本文介绍如何在Python中结合使用Pandas和openpyxl库,实现高效的数据处理与Excel电子表格样式定制。内容涵盖DataFrame与工作簿的双向转换方法,以及如何通过openpyxl为Pandas处理后的数据添加字体、颜色和对齐等自定义样式,满足复杂报表需求。
本文深入解析Pandas库中transform函数的核心机制,阐述其如何在保持数据形状不变的前提下进行统计变换。通过Series、DataFrame及GroupBy分组场景下的具体代码示例,对比transform与agg的差异,演示对数化、标准化及多列配置等实战技巧,帮助开发者高效处理明细数据。