

Pandas中transform()与groupby()结合使用的详细解析

本文详解Pandas中groupby与transform的结合用法。通过餐厅销售数据示例,对比两种计算组内百分比的方案:方案一使用apply或sum聚合后merge合并,步骤繁琐;方案二利用transform直接返回与原数据等长的新列,代码更简洁。文章重点解析transform在分组后保持索引一致性的特性,帮助开发者高效处理分组统计问题。
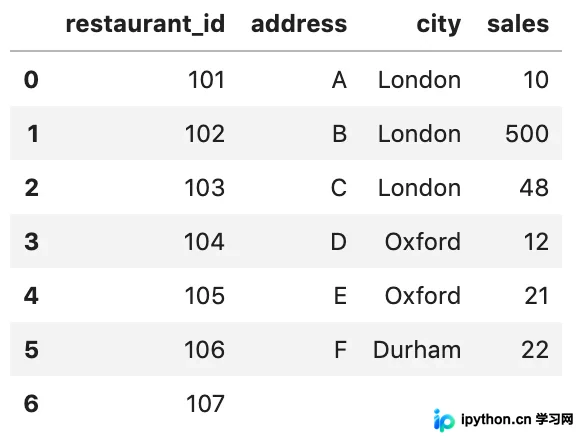
首先,假设我们拥有如下餐厅数据集:
import pandas as pd

df = pd.DataFrame({
  'restaurant_id': [101,102,103,104,105,106,107],
  'address': ['A','B','C','D', 'E', 'F', 'G'],
  'city': ['London','London','London','Oxford','Oxford', 'Durham', 'Durham'],
  'sales': [10,500,48,12,21,22,14]
})
若需计算每家餐厅在其所在城市销售额中的占比,预期输出结果应包含原始数据及新增的占比列。
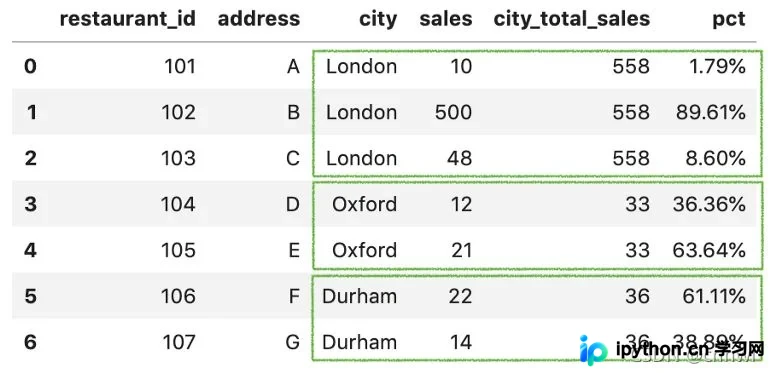
与原始数据集相比,结果中增加了两列:一是该城市所有餐厅的销售总额,二是各餐厅在该城市销售额中的百分比。实现此目标主要有两种方案:
方案一(步骤较多):
1、利用 groupby('city') 按城市进行分组,针对每个组选取销售额列 ['sales'],随后应用 apply(sum) 或 sum() 函数计算各城市的销售总额。
接着,将新列重命名为 city_total_sales,并执行索引重置操作(务必包含 reset_index(),因为 groupby('city') 生成的索引为城市名称,而我们需要将城市作为普通数据列保留)。
city_sales = df.groupby('city')['sales']
             .sum().rename('city_total_sales').reset_index()
此时获得的 city_sales 数据结构如下:
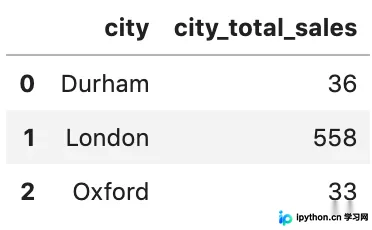
2、利用 merge() 函数将 city_sales 合并回原始数据,生成的 df_new 结果如下:
df_new = pd.merge(df, city_sales, how='left')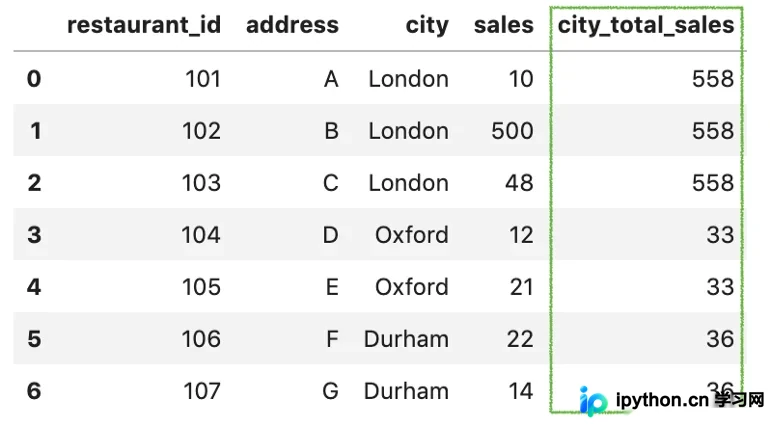 3、最后,计算百分比并格式化为两位小数,最终结果如下:
df_new['pct'] = df_new['sales'] / df_new['city_total_sales']
df_new['pct'] = df_new['pct'].apply(lambda x: format(x, '.2%'))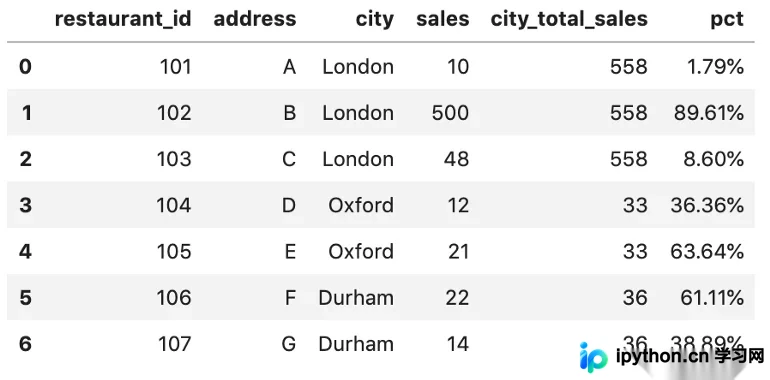
方案二(更为便捷):
1、
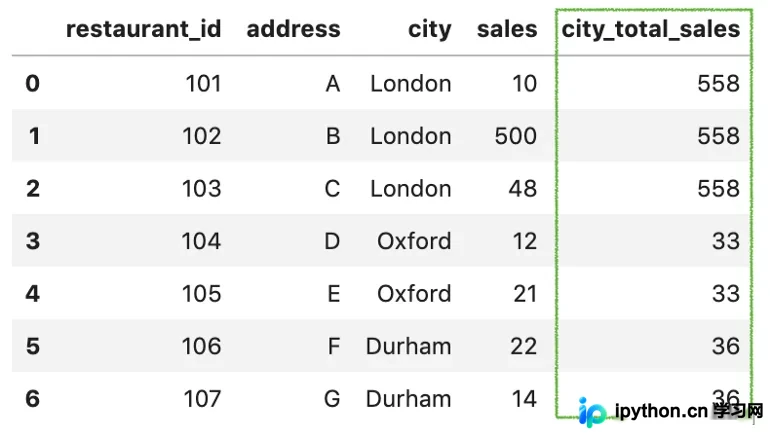
transform() 函数在执行转换操作后,会保持与原始数据集相同的数据行数。因此,先使用 groupby() 进行分组,再调用 transform(sum),将返回与原列长度一致的新列,具体结果如下图所示:
df['city_total_sales'] = df.groupby('city')['sales']
                           .transform('sum')
上述代码的逻辑为:数据按城市分组后,选取销售额列,对每组销售额求和,并返回一个与原DataFrame行数相同的新列。
2、
后续步骤与方案一完全相同。
df['pct'] = df['sales'] / df['city_total_sales']
df['pct'] = df['pct'].apply(lambda x: format(x, '.2%'))
总结:对比可见,对 DataFrame 进行分组 groupby() 后,若使用 apply() 或直接调用统计函数,生成的新列长度等于分组后的组数;而若使用 transform(),生成的新列长度则与原 DataFrame 的列数(行数)保持一致。
至此,关于Pandas中transform()结合groupby()用法的示例详解已介绍完毕。如需了解更多Pandas groupby()相关内容,欢迎查阅本站往期文章或继续浏览后续教程,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









