

Python自动化:批量合并Excel同名Sheet的完整实现

本文详解如何利用Python的os与pandas模块,自动化合并同一文件夹下多个Excel文件中同名Sheet的数据。通过遍历文件、读取数据、提取Sheet名并拼接内容,最终生成包含所有同名Sheet数据的新Excel文件,适用于日常办公数据整理场景。
大家好,我是老Amy。很久没有分享办公自动化的相关内容了,原因主要有三点:
- 工作繁忙,需应对领导安排的任务;
- 精力有限,难以兼顾大家的具体办公需求;
- 工作繁忙,处于持续休息状态。
不过,一位朋友的求助打破了我的“停滞状态”,其具体需求如下:
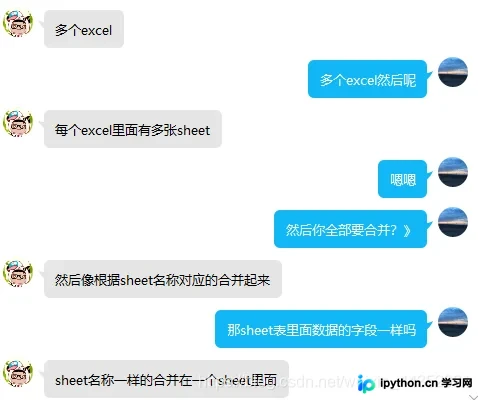
抱着不断尝试的心态,我开始思考:“该如何实现这一需求?”
不必慌张,我们先从数据本身入手进行分析。
数据特征分析如下:
数据存储路径 C:\Users\logic\Desktop\mytest\file_dir
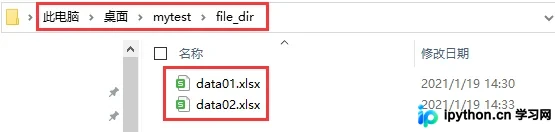
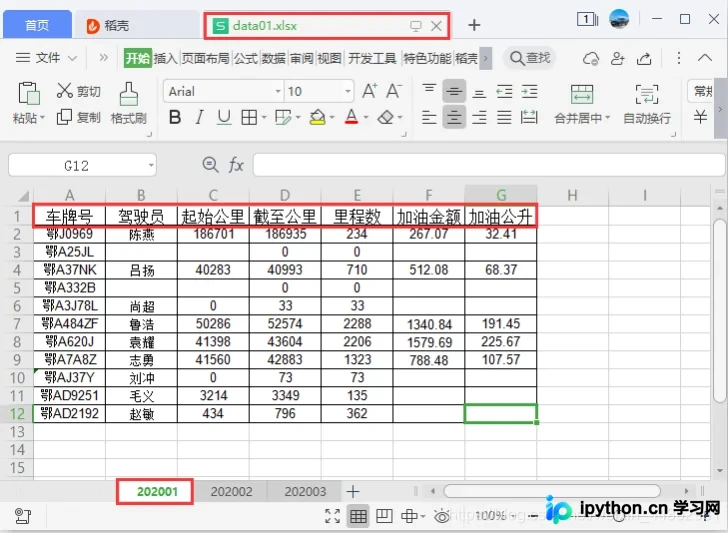
文件 data01.xlsx 的数据内容如下:
文件 data02.xlsx 的数据内容如下:
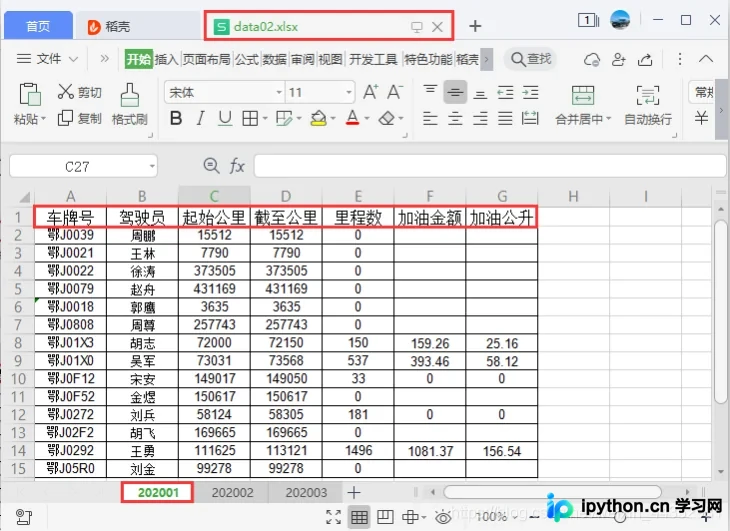
根据上述信息,我们可以得出以下结论:
- 所有 xlsx 格式的工作簿均位于同一个文件夹内。
- 需要将 data01.xlsx 与 data02.xlsx 中名称相同的 Sheet 进行合并,例如将两个文件中的“202001”Sheet合并,其他Sheet同理处理。
要实现数据合并,首先需读取每个工作簿中所有工作表的数据,具体流程如下:
- 获取文件夹内所有工作簿的文件名;
- 将文件名拼接为绝对路径;
- 读取所有表格的数据;
- 将读取的数据保存至空列表中。
为了通过代码完成上述步骤,我们需要使用Python内置的os模块,该模块用于与操作系统交互,以获取文件夹下的所有工作簿名,代码如下:
import os # 导入模块

# 列出 C:\Users\logic\Desktop\mytest\file_dir 下所有文件名
file_name_li = os.listdir(r"C:\Users\logic\Desktop\mytest\file_dir")
file_name_li

---------------------------------------------------------------------
['data01.xlsx', 'data02.xlsx']
仅凭文件名无法在系统中定位文件,因此需要更精确的地址——绝对路径,接下来需拼接每个文件的绝对路径。代码如下:
# 遍历出每个文件名
for file_name in file_name_li:
  # 将文件夹绝对路径 与 文件名进行拼接
  file_path_li = os.path.join(r"C:\Users\logic\Desktop\mytest\file_dir",file_name)
  print(file_path_li)

--------------------------------------------------------------------
C:\Users\logic\Desktop\mytest\file_dir\data01.xlsx
C:\Users\logic\Desktop\mytest\file_dir\data02.xlsx
获取文件绝对路径后,即可读取文件数据,这里需要用到pandas库。请注意,pandas并非Python内置模块,需预先安装。使用pandas的read_excel()方法读取数据时,由于需要读取工作簿下的所有工作表,必须将sheet_name参数设置为None,否则默认仅读取第一个工作表。代码如下:
# 遍历出每个文件名
for file_name in file_name_li:
  # 将文件夹绝对路径 与 文件名进行拼接
  file_path_li = os.path.join(r"C:\Users\logic\Desktop\mytest\file_dir",file_name)
  # 读取 excel 表格数据
  all_data = pd.read_excel(file_path_li,sheet_name=None)
  print(all_data)

--------------------------------------------------------------------
OrderedDict([('202001',     车牌号 驾驶员   起始公里  截至公里  里程数   加油金额  加油公升
0  鄂J0969  陈燕 186701.0 186935  234  267.07  32.41
1  鄂A25JL NaN    NaN    0   0   NaN   NaN
2  鄂A37NK  吕扬  40283.0  40993  710  512.08  68.37
3  鄂A332B NaN    NaN    0   0   NaN   NaN
4  鄂A3J78L  尚超    0.0   33  33   NaN   NaN
5  鄂A484ZF  鲁浩  50286.0  52574 2288 1340.84 191.45
6  鄂A620J  袁耀  41398.0  43604 2206 1579.69 225.67
7  鄂A7A8Z  志勇  41560.0  42883 1323  788.48 107.57
8  鄂AJ37Y  刘冲    0.0   73  73   NaN   NaN
9  鄂AD9251  毛义  3214.0  3349  135   NaN   NaN
10 鄂AD2192  赵敏   434.0   796  362   NaN   NaN),...], ...)
从打印结果(此处取第一个示例)可以看出,其类型为OrderedDict。虽然整体结构看似复杂,但拆解后其本质为Dict。因此,我们可以通过键“202001”直接获取对应的数据值,例如:
# 遍历出每个文件名
for file_name in file_name_li:
  # 将文件夹绝对路径 与 文件名进行拼接
  file_path_li = os.path.join(r"C:\Users\logic\Desktop\mytest\file_dir",file_name)
  # 读取 excel 表格数据
  all_data = pd.read_excel(file_path_li,sheet_name=None)
  print(all_data["202001"])

---------------------------------------------------------------------
车牌号 驾驶员   起始公里  截至公里  里程数   加油金额  加油公升
0  鄂J0969  陈燕 186701.0 186935  234  267.07  32.41
1  鄂A25JL NaN    NaN    0   0   NaN   NaN
2  鄂A37NK  吕扬  40283.0  40993  710  512.08  68.37
3  鄂A332B NaN    NaN    0   0   NaN   NaN
4  鄂A3J78L  尚超    0.0   33  33   NaN   NaN
5  鄂A484ZF  鲁浩  50286.0  52574 2288 1340.84 191.45
6  鄂A620J  袁耀  41398.0  43604 2206 1579.69 225.67
7  鄂A7A8Z  志勇  41560.0  42883 1323  788.48 107.57
8  鄂AJ37Y  刘冲    0.0   73  73   NaN   NaN
9  鄂AD9251  毛义  3214.0  3349  135   NaN   NaN
10 鄂AD2192  赵敏   434.0   796  362   NaN   NaN

车牌号 驾驶员  起始公里  截至公里  里程数   加油金额  加油公升
0  鄂J0039 周鹏  15512  15512   0   NaN   NaN
1  鄂J0021 王林  7790  7790   0   NaN   NaN
2  鄂J0022 徐涛 373505 373505   0   NaN   NaN
3  鄂J0079 赵舟 431169 431169   0   NaN   NaN
4  鄂J0018  郭鹰  3635  3635   0   NaN   NaN
5  鄂J0808 周尊 257743 257743   0   NaN   NaN
6  鄂J01X3 胡志  72000  72150  150  159.26  25.16
7  鄂J01X0 吴军  73031  73568  537  393.46  58.12
8  鄂J0F12 宋安 149017 149050  33   0.00  0.00
9  鄂J0F52 金煜 150617 150617   0   NaN   NaN
10  鄂J0272 刘兵  58124  58305  181   0.00  0.00
11  鄂J02F2 胡飞 169665 169665   0   NaN   NaN
12  鄂J0292 王勇 111625 113121 1496 1081.37 156.54
13  鄂J05R0 刘金  99278  99278   0   NaN   NaN
从打印结果可见,通过“202001”可以获取两个工作簿中名为“202001”的数据。原因在于循环遍历,因此现在需将数据统一添加到一个列表中。此外,还需保存工作表名至集合中(用于去重),以便后续通过工作表名获取数据。
# 定义文件名集合
all_file_name = set()
# 定义数据列表
all_data_li = []

# 遍历出每个文件名
for file_name in file_name_li:
  # 将文件夹绝对路径 与 文件名进行拼接
  file_path_li = os.path.join(r"C:\Users\logic\Desktop\mytest\file_dir",file_name)
  # 读取 excel 表格数据
  all_data = pd.read_excel(file_path_li,sheet_name=None)
  # 将数据添加到数据列表中
  all_data_li.append(all_data)
  # 将工作表名添加到文件夹集合中
  for name in all_data:
    all_file_name.add(name)

print(all_data_li)
print(all_file_name)
具备上述基础后,即可实现关键步骤:提取名称相同的工作表数据进行拼接,并保存至新的工作表中。
接下来需思考:如何使用pandas向一个工作簿中添加多个工作表?这需要用到pd.ExcelWriter。代码如下:
# 创建工作簿
writer = pd.ExcelWriter("all_data.xlsx")

# 遍历每个工作表名
for sheet_name in all_file_name:
  data_li = []
  # 遍历数据
  for data in all_data_li:
    # 获取同名数据并添加到data_li中
    n_rows = data_li.append(data[sheet_name])
  # 将同名数据进行拼接
  group_data = pd.concat(data_li)
  # 保存到writer工作簿中,并指定工作表名为sheet_name
  group_data.to_excel(writer,sheet_name=sheet_name)

# 千万莫忘记,保存工作簿
writer.save()
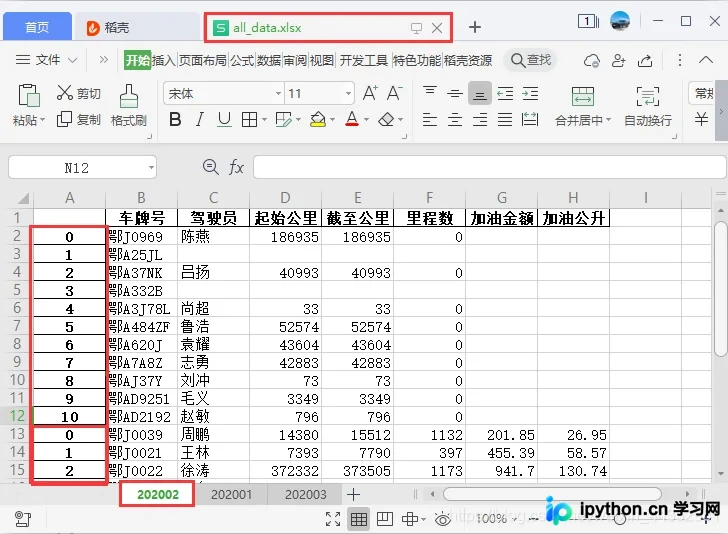
至此,实现完毕。
以上即为Python合并多个Excel中同名Sheet的详细内容,更多Python合并Excel Sheet的相关资料请关注本站其他相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









