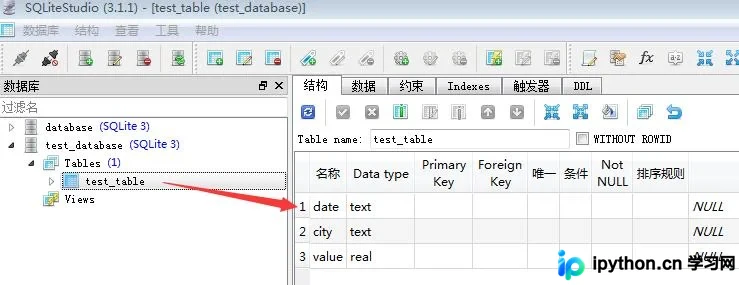
Python处理SQLite数据库文件的完整指南
本文详细介绍如何使用Python标准库sqlite3创建和操作SQLite数据库,并通过pandas库高效读取数据。涵盖从建立连接、建表插入数据到使用read_sql_query获取DataFrame的完整流程,解决大数据量处理效率问题,附带可视化工具推荐。
2026-10-13
6

本文详细介绍如何使用Python标准库sqlite3创建和操作SQLite数据库,并通过pandas库高效读取数据。涵盖从建立连接、建表插入数据到使用read_sql_query获取DataFrame的完整流程,解决大数据量处理效率问题,附带可视化工具推荐。
本文介绍如何在本地环境中使用Python高效处理大数据。重点讲解Pandas中Series、DataFrame的初始化、行列增删、数据合并(concat、merge)及分组聚合(GroupBy)操作,并简述NumPy数组基础。涵盖从CSV读取、结构更新到条件过滤的完整流程,适合需要在本地快速处理亿级数据聚合的场景。
本文介绍在Python pandas中如何排除DataFrame中的特定行。虽然pandas提供了[[wp:a0]]方法用于筛选包含特定值的行,但缺乏直接排除的API。文章通过示例演示了将列值转为列表、移除不需要的元素后再次使用[[wp:a5]]来实现反向筛选的技巧,帮助开发者解决复杂的数据过滤需求。
本文详细解析 Python 中 Pandas DataFrame 的核心操作。涵盖从字典和多维数组创建 DataFrame 的方法,重点讲解列与行的索引技巧,特别是 iloc 与 loc 的区别及赋值警告处理。同时演示如何新增多列数据及删除指定的行与列,提供实用的代码示例与避坑指南。
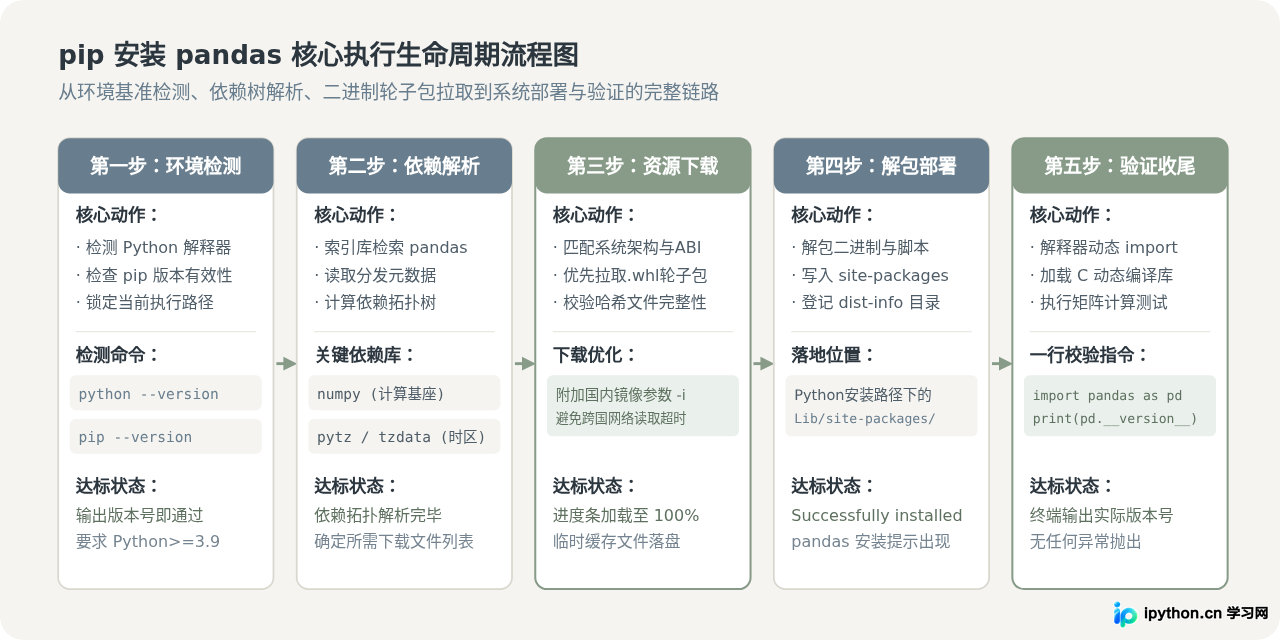
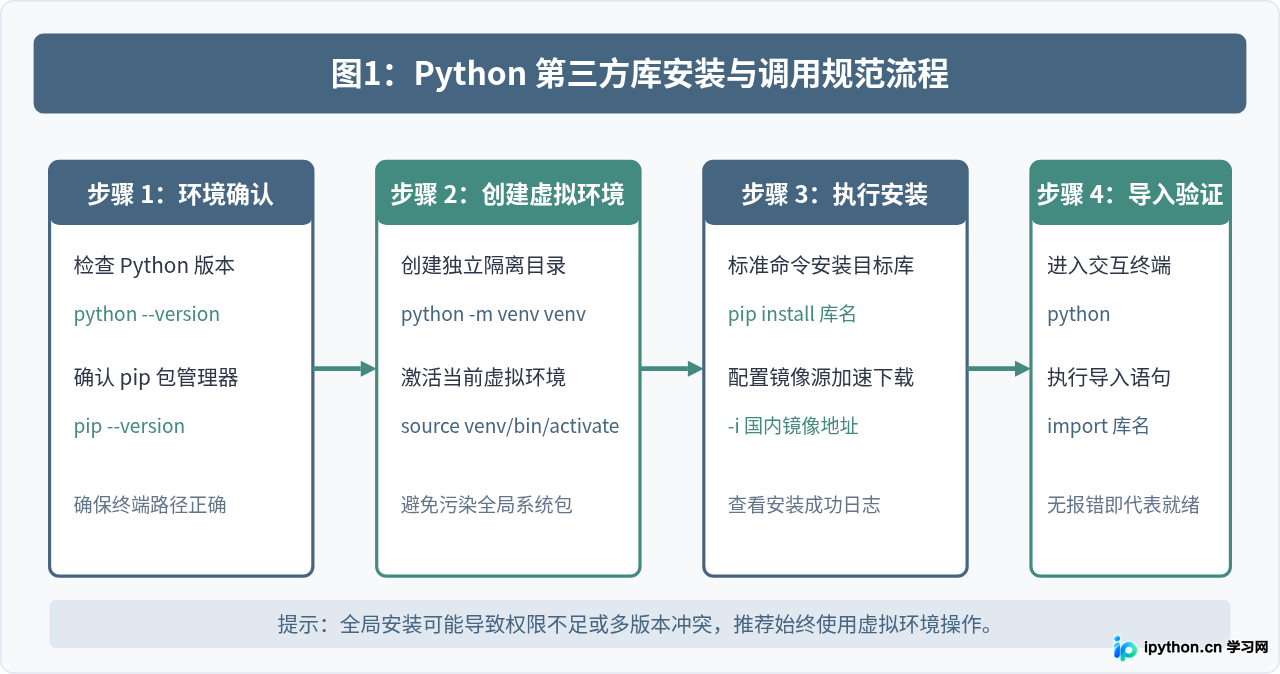
面向中文初学者的Python安装pandas实战指南,详细讲解使用pip安装数据分析核心库pandas的完整步骤、国内高速镜像加速配置、三级验证机制以及多版本冲突与权限异常等高频故障的排查解决方案。
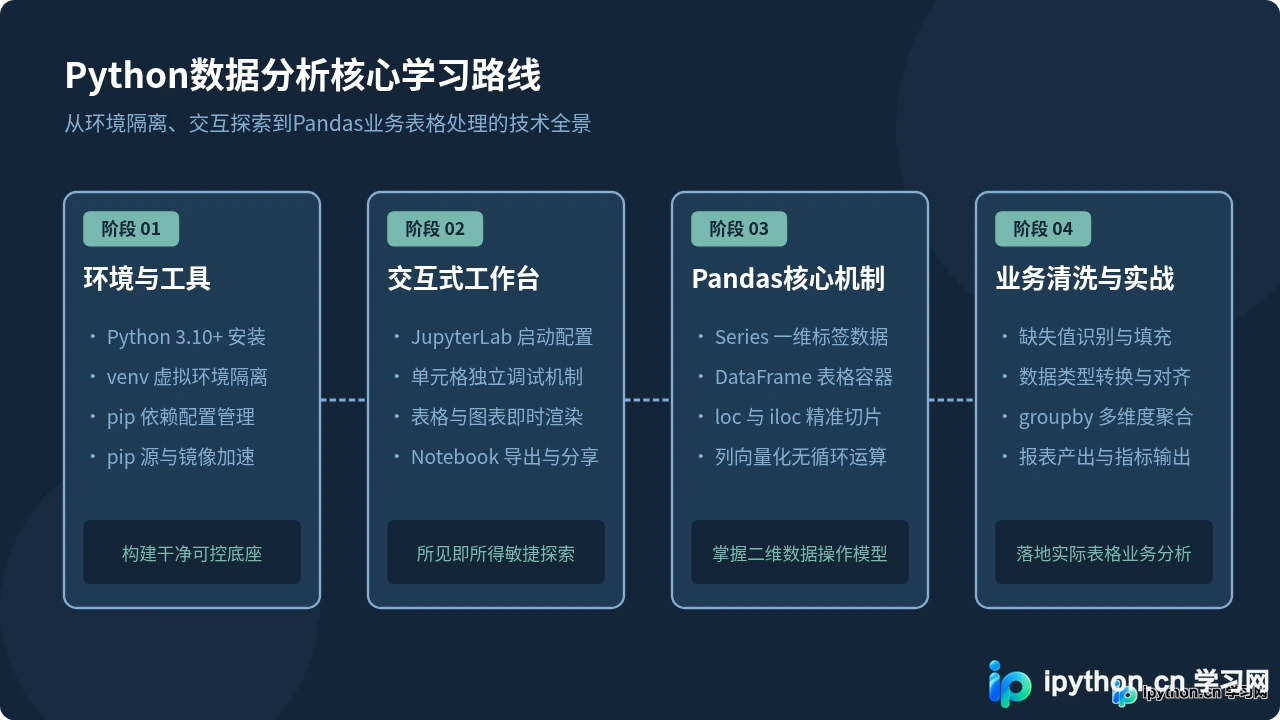
面向新手的Python数据分析实用学习路线,梳理从Python虚拟环境配置、Jupyter交互工具使用,到Pandas核心数据结构、数据清洗与聚合统计实战的完整路径。
本文为Python初学者系统介绍十个最常用且实用的第三方库,涵盖网络请求、数据分析、数值计算、可视化、办公自动化、图像处理及开发调试,提供明确安装指南与代码示例。
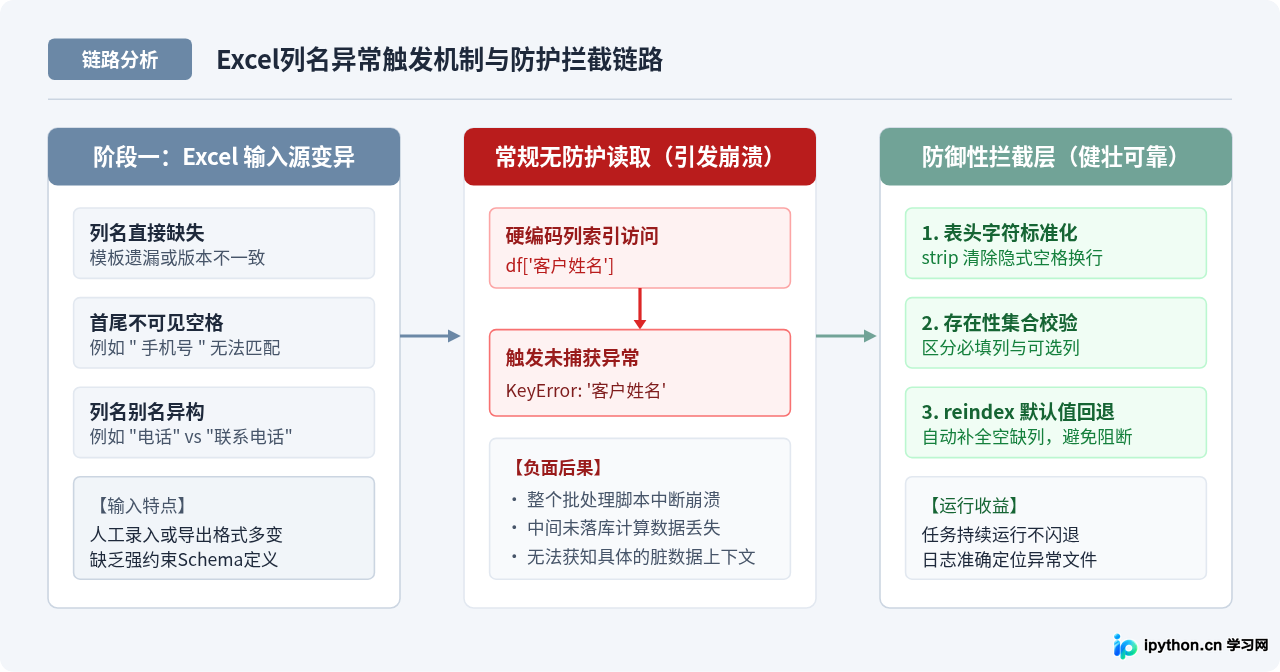
针对Python读取Excel时因指定列名不存在、首尾空格或表头变异导致程序抛出KeyError崩溃的问题,深入剖析触发根因,提供列名标准化、集合预检、reindex默认值补齐及生产级容错封装方案。
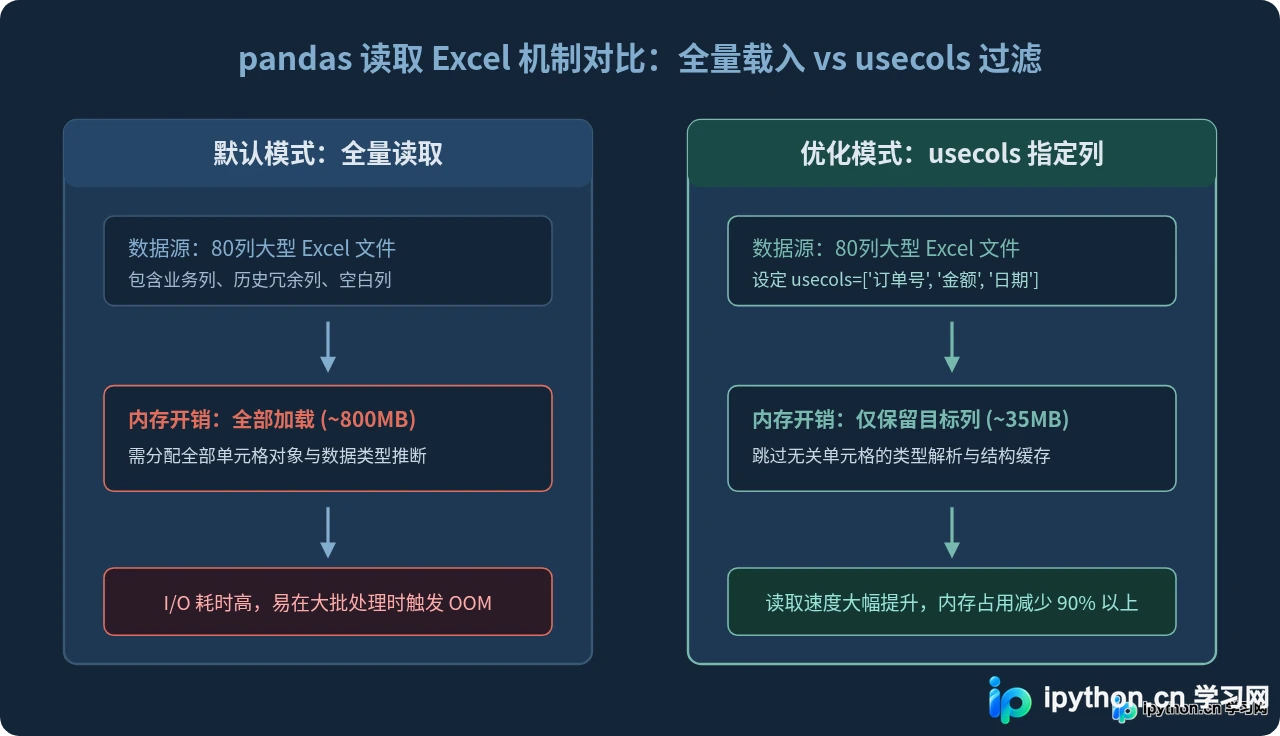
详细讲解Python pandas库中read_excel函数的usecols参数用法。涵盖按列名、整数索引、Excel字母范围及Callable函数等四种指定列读取方式,配合原理对比、操作步骤与常见避坑指南,助您高效处理大型Excel表格并降低内存消耗。
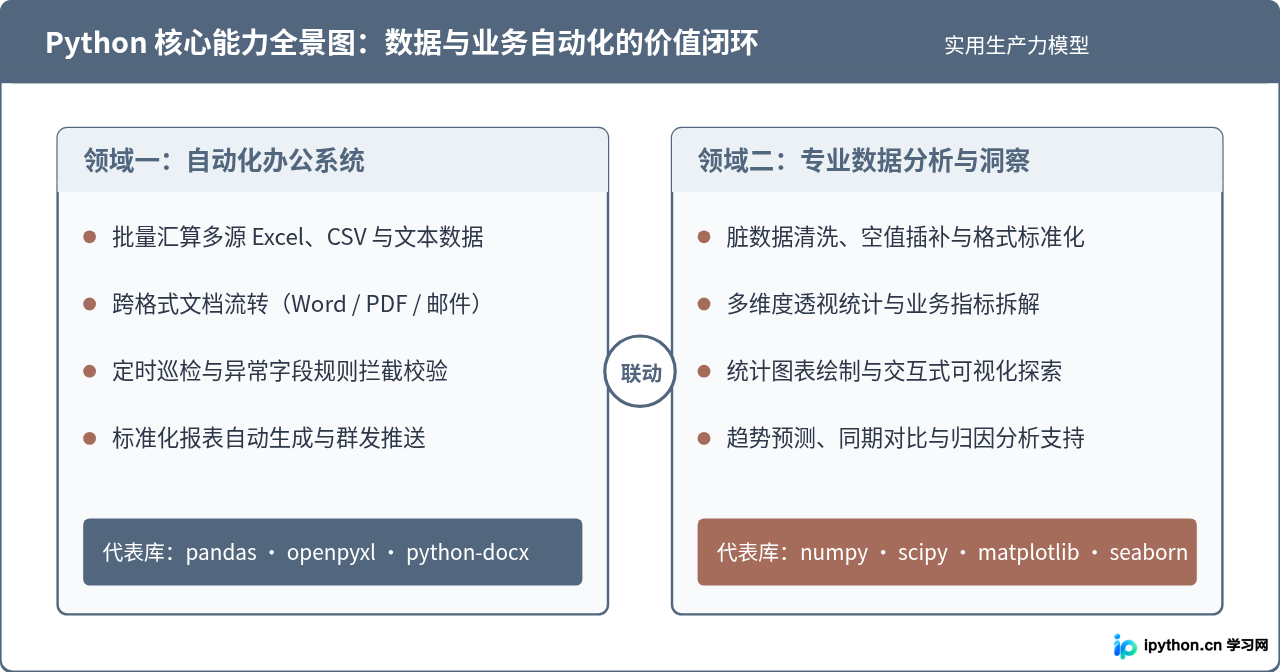
深入解析Python在日常业务中的实际应用场景,重点围绕数据分析全流程与办公自动化落地,提供具体代码范例、避坑指南及选型决策。
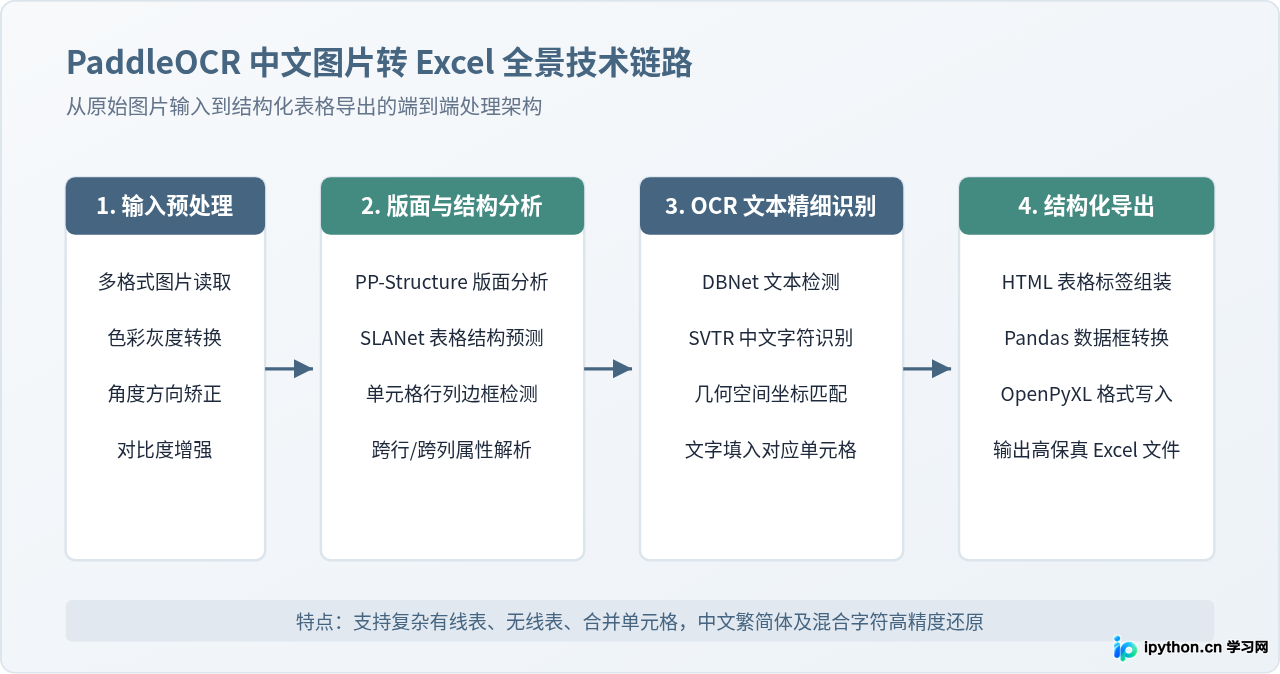
本教程详细讲解如何使用Python调用PaddleOCR及PP-Structure表格识别模块,将中文图片中的表格高精度提取并转换为结构化Excel文件的完整操作步骤、代码实现与调优方法。
详细讲解在Python中读取CSV文件并根据单条件、多条件以及数值范围筛选特定数据的实用方法,涵盖内置csv模块与pandas库的对比与最佳实践。