

Windows/Mac/Linux下使用pip安装pandas库
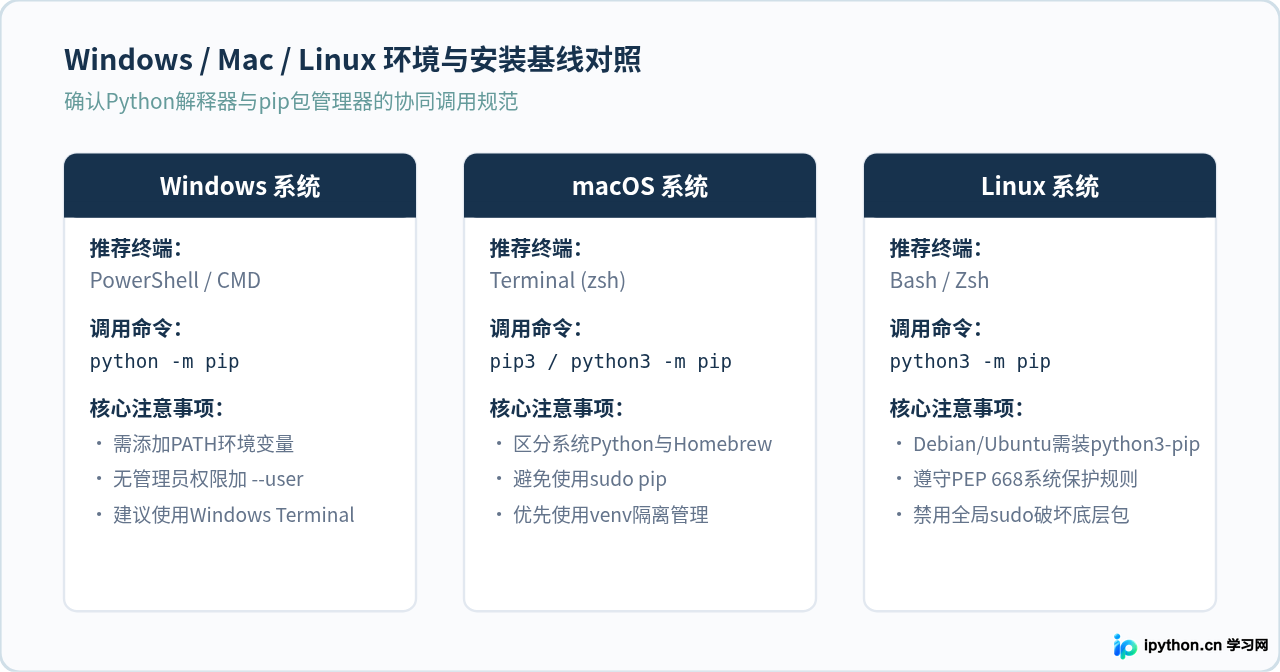
本文详细介绍在Windows、macOS和Linux操作系统下使用pip安装pandas数据分析库的完整方法,涵盖环境检查、虚拟环境隔离、镜像源加速与常见报错排查。
2026-10-10
6

本文详细介绍在Windows、macOS和Linux操作系统下使用pip安装pandas数据分析库的完整方法,涵盖环境检查、虚拟环境隔离、镜像源加速与常见报错排查。
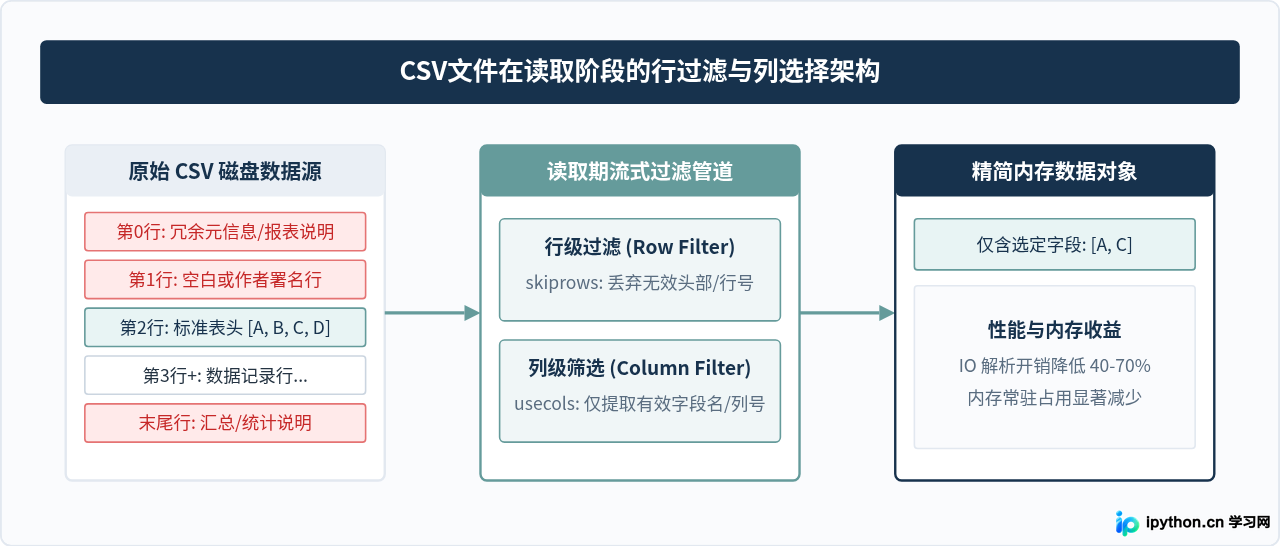
详细讲解在Python中读取CSV文件时如何跳过指定行以及如何只提取特定列。包含Pandas库skiprows与usecols参数的完整用法、Python原生csv模块的流式处理方法、注意事项与选型对比。
针对Excel中混杂时间戳、年月日字符串及简写日期导致的精度丢失与解析报错问题,本文提供一套基于Pandas的全字符串读取与自定义转换方案。通过强制指定字符类型读取,结合容错函数与异常捕获机制,可一键将不规则日期统一清洗为“XX月XX日”并安全导出,实现零数据丢失的高效清洗流程。
本文详细讲解Python进度条库tqdm的安装配置、核心参数定制、嵌套循环控制、手动进度更新以及Pandas框架集成方法。通过标准化示例演示如何在脚本、循环及数据清洗流程中直观反馈执行状态,并提供调试建议与性能注意事项,帮助开发者快速提升任务监控效率。
本文详解如何使用Python实现高频办公场景的自动化。通过pandas合并清洗Excel数据、openpyxl生成格式化报表、python-docx批量填充Word合同,结合smtplib自动发送邮件。文章提供完整代码示例与环境准备步骤,指导如何配置定时任务、添加日志记录与异常处理,帮助职场人将重复性工作压缩至分钟级,提升数据处理准确率与整体工作效率。
面对包含大量缺失值与重复记录的原始表格,直接使用固定数值填充或盲目去重极易扭曲业务结论。本文演示如何通过 Pandas 全面评估数据质量,针对分类变量、数值指标与时序记录采用中位数、众数、分组均值及前后向填充等精准策略,并结合业务字段封装自动化清洗流程,在保障数据结构完整的前提下高效完成数据标准化。
本文汇总15个高频Python自动化办公脚本,覆盖文件批量整理、表格数据转换、PDF内容提取及图片格式缩放等场景。提供从环境配置到完整代码的运行方案,替代手动重复操作,帮助职场人员快速提升日常数据处理效率。
针对Python列表重复元素处理需求,本文梳理三种高效去重方案。通过set()实现极速无序去重,利用dict.fromkeys()在Python 3.7环境中保持原顺序,并结合pandas库处理含复杂条件的海量数据。附带性能参考指标与选型建议,帮助开发者根据实际业务场景快速落地代码。
针对企业报表中常遇到的.xls与.xlsx混用、表头偏移及多余序号列等问题,本文提供基于Python、Pandas与openpyxl/xlrd的自动化合并方案。通过封装通用读取函数支持动态跳行跳列,利用索引映射实现姓名精准匹配,并按业务需求将新字段定点插入指定位置。全程无需人工复制粘贴,大幅降低数据清洗成本。
本文详细演示如何在Python桌面端应用中实现文件浏览器的核心模块,涵盖目录智能分层遍历、文件列表过滤加载,以及针对.docx、.doc和.xlsx格式的文本级内容预览。通过策略模式分发与多维度降级处理,确保多格式文档安全读取与结构化展示,附带完整可运行代码与性能优化建议。
数据质量直接决定分析结论的可靠性。本文系统梳理Python数据分析中12项核心清洗技术,覆盖缺失值处理、重复值过滤、类型转换、异常值拦截、量纲标准化、表结构合并、时空字段解析及分类编码等高频场景。结合Pandas与scikit-learn提供可运行代码与完成状态验证方法,助您快速搭建标准化数据预处理流水线。
本文系统梳理 Python Pandas 库的结构化数据处理全流程,涵盖 DataFrame 构建、CSV 读写与探查、位置/标签/布尔索引、GroupBy 分组聚合、多表连接与透视表、时间序列解析,以及分块读取与类型转换等性能优化方案。结合可运行代码与预期输出对照,帮助开发者快速掌握数据清洗、转换与分析的核心操作。