解决pandas.DataFrame.fillna填充NaN失败的问题
在使用pandas DataFrame的fillna方法时,若未设置inplace=True,填充操作不会修改原数据框,导致看似填充失败。本文通过对比直接打印结果与修改原数据两种方式,详细解析inplace参数的作用,确保数据变更持久保存。
2026-10-14
6

在使用pandas DataFrame的fillna方法时,若未设置inplace=True,填充操作不会修改原数据框,导致看似填充失败。本文通过对比直接打印结果与修改原数据两种方式,详细解析inplace参数的作用,确保数据变更持久保存。
本文详细解析pandas中loc与iloc在数据选取上的核心差异,loc基于标签索引支持按条件筛选,而iloc基于位置索引。通过具体代码示例展示如何选取指定行列及多条件组合取值,帮助开发者高效处理DataFrame数据。
本文介绍如何在 pandas 中创建一个空的 DataFrame 并预先定义列名。通过构建包含基础字段、动态列表及特定标识的列名数组,并将其传递给 DataFrame 构造函数,即可实现快速初始化。该方法适用于需要预设数据结构后续填充数据的场景。
本文介绍在 Python 中使用 Numpy 查找数组中 np.nan 值的方法。通过 numpy.isnan 函数定位 NaN 元素及其索引,并针对 Pandas 读取数据时可能出现的 TypeError 问题,推荐使用 pandas.isnull 进行空值判断,确保数据处理流程的稳定性。
本文介绍如何使用 pandas 按行读取 CSV 文件,并演示如何处理数据中的 NaN 值。通过 fillna 方法将 NaN 替换为特定标记,再结合 while 循环从列表中移除该标记,实现数据的清洗与格式化输出。
本文介绍在Python Pandas中处理缺失值的方法。通过创建包含NaN的DataFrame,利用merge进行左连接后,使用fillna(0)函数将所有NaN值替换为0。代码示例展示了从数据合并到缺失值填充的完整流程,适用于数据预处理场景。
本文介绍如何使用Python的pandas库将Excel文件转换为HTML格式。通过读取Excel文件并调用to_html()方法,可以生成包含表格数据的HTML代码。示例代码展示了完整的转换过程,包括文件读取、解析及写入HTML文件的操作,适用于需要快速将表格数据嵌入网页的场景。
本文介绍如何利用Python中已有的pandas库,无需安装额外插件,即可实现Excel文件到TXT文件的转换。通过示例代码展示了具体的转换逻辑及后续的数据清洗步骤,包括去除行首数字和空格以及去重处理,为数据处理提供便捷方案。
本文详解Python处理CSV、Excel、TXT及DAT文件的方法。涵盖csv库与pandas读取写入技巧,对比xlrd与pandas在Excel处理上的差异,演示TXT逐行读取与DAT格式转换。通过代码示例解析数据提取、列表转换及自动化参数化应用,帮助开发者高效处理各类数据文件。
本文介绍如何使用Python的Pandas库结合SQLAlchemy和cx_Oracle驱动,从Oracle数据库中获取数据并转换为DataFrame对象。通过具体代码示例,展示了数据库连接、SQL查询执行及数据加载的全过程,为数据处理提供实用参考。
本文介绍了在Python中使用Pandas读取MySQL数据库数据并转换为DataFrame的两种主要方法。第一种方式基于SQLAlchemy引擎,适用于Pandas 1.9及后续版本,通过配置连接参数建立引擎后执行SQL查询;第二种方式利用MySQLdb直接连接数据库进行数据获取。文章提供了具体的代码示例和注意事项,帮助开发者根据项目需求选择合适的技术方案。
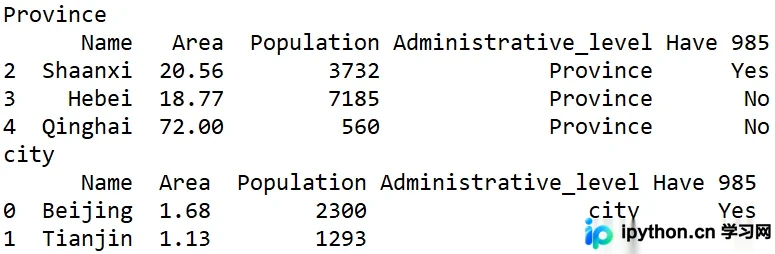
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。