

Python pandas groupby分组功能实战:单列与多列聚合示例

发布时间:2026-10-13| 3人浏览过
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
在pandas库的DataFrame数据结构中,支持依据特定属性的相同值进行聚合分组操作。用户可以选择单个属性作为分组依据,也可以指定多个属性组合进行分组。
具体代码实现如下所示:
import pandas as pd
A=pd.DataFrame([['Beijing',1.68,2300,'city','Yes'],['Tianjin',1.13,1293,'city','Yes'],['Shaanxi',20.56,3732,'Province','Yes'],['Hebei',18.77,7185,'Province','No'],['Qinghai',72,560,'Province','No']],columns=['Name','Area','Population','Administrative_level','Have 985'])
for name,group in A.groupby('Administrative_level'):
  print(name)
  print(group)
for name,group in A.groupby(['Administrative_level','Have 985']):
  print(name)
  print(group)
首先构建一个示例DataFrame,其数据结构如表所示。
| Name | Area | Population | Administrative_level | Have 985 |
| Beijing | 1.68 | 2300 | city | Yes |
| Tianjin | 1.13 | 1293 | city | Yes |
| Shaanxi | 20.56 | 3732 | Province | Yes |
| Hebei | 18.77 | 7185 | Province | No |
| Qinghai | 72 | 560 | Province | No |
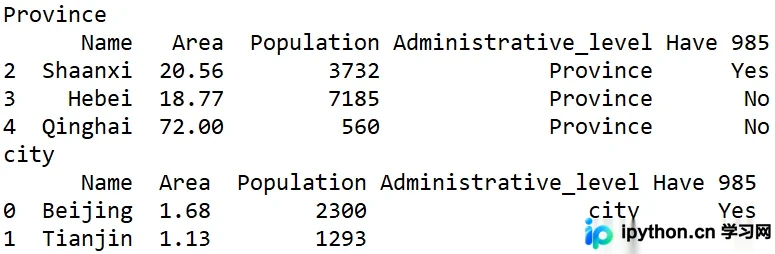
接下来分别执行两种分组策略:首先仅依据“行政级别”这一单一属性进行划分;随后依据“行政级别”与“是否有985高校”这两个属性组合进行划分。具体的分组结果如下展示:
总结
以上内容为Python中groupby分组功能的实例代码介绍,旨在提供实用参考。若读者有任何疑问,欢迎留言咨询,作者将及时回复。感谢对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









