10个Python数据处理核心技巧:从入门到精通
本文介绍10个Python中pandas库的高效使用技巧,涵盖数据读取、类型选择、深拷贝、映射转换、apply性能优化、值计数、缺失值处理、ID筛选、分箱及CSV导出等核心场景,帮助开发者提升数据处理效率。
2026-10-13
6

本文介绍10个Python中pandas库的高效使用技巧,涵盖数据读取、类型选择、深拷贝、映射转换、apply性能优化、值计数、缺失值处理、ID筛选、分箱及CSV导出等核心场景,帮助开发者提升数据处理效率。
本文介绍如何使用Python的Pandas库从数据集中提取特定时间段内的记录。通过示例展示了将字符串时间转换为datetime类型,并利用布尔索引进行范围过滤的具体步骤。文章包含完整的代码实现及输出结果分析,适用于需要处理时间序列数据的场景。
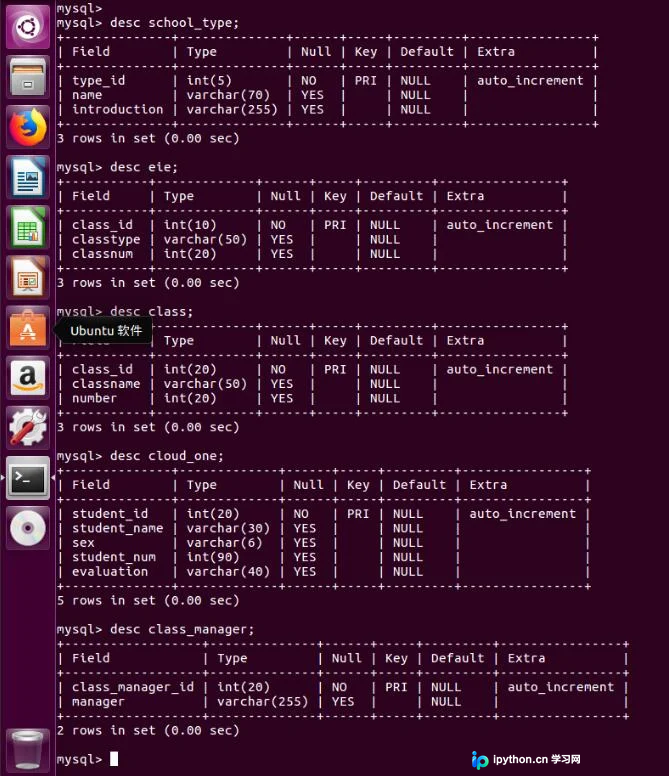
本文分享基于Python和MySQL的学生信息查询系统代码,涵盖登录验证、学院类型查询及学生信息增删改查功能。文中建议使用pandas的DataFrame结构优化数据显示,并提供相关数据库参考,适合初学者学习管理系统开发。
本文详细介绍利用pandas进行数据集端到端处理的流程,涵盖从基本信息查看、统计分析及直方图绘制,到数据集拆分、分类特征转换及缺失值填充等关键步骤。通过具体代码示例,帮助读者掌握数据清洗与预处理的核心技巧。
本文介绍利用Python读取包含多个Sheet的Excel文件并合并数据的方法。通过xlrd获取工作表列表,结合pandas逐表读取并忽略指定行,最终使用dropna清理缺失值。该方法适用于需要整合分散在多个工作表中数据的场景,代码示例展示了核心处理逻辑。
本文介绍使用Python和pandas库将ARFF格式文件转换为CSV文件的完整代码示例。通过读取ARFF文件内容,按逗号分割数据并存入DataFrame,最终保存为CSV格式,适用于简单的数据格式转换需求。
本文介绍了在Python中使用pandas库进行数据处理的技巧,重点讲解了cumsum函数的用法。该函数用于计算轴向元素的累积加和,并返回由中间结果组成的数组。通过具体示例,展示了如何对不同维度的数据进行累积求和操作,帮助读者快速掌握这一常用功能。
本文介绍如何在Python中利用texttable库为Pandas DataFrame格式化输出添加表格边框。通过设置列对齐方式(左、中、右)和数据类型(文本、整数等),并使用header=False参数避免首行被误识别为标题,从而实现美观的表格展示。
本文详细介绍如何在Pandas中通过提取的索引获取原始DataFrame的行数据。重点讲解将索引转换为列表后,利用iloc函数进行数据块提取的操作步骤。该方法适用于需要基于特定条件(如缺失值处理)筛选数据并进行后续替换或分析的场景,帮助开发者高效完成数据预处理任务。
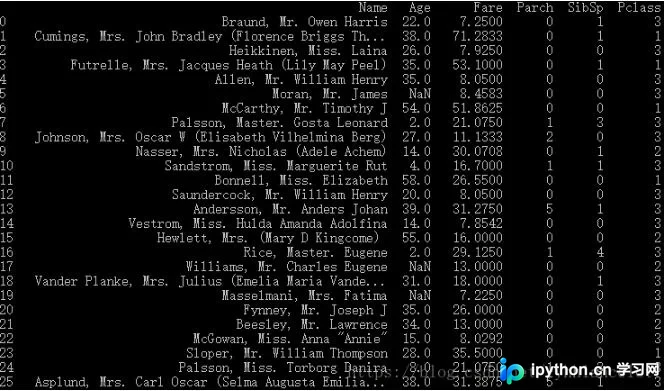
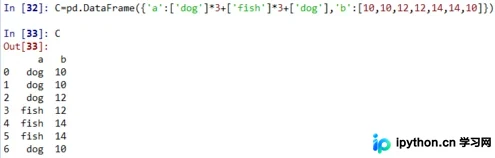
本文介绍如何在Pandas中利用duplicated方法统计并筛选包含重复值的列,通过keep参数控制保留逻辑。同时提供五种NumPy数组去重方案,包括利用unique、bincount及排序比较等技巧,帮助开发者高效处理数据中的重复项。
本文介绍如何在Pandas中利用字典映射方法,将DataFrame某一列的字符串值高效转换为数字。通过定义映射字典并调用map函数,即可实现类型转换,适用于分类变量编码等场景。
本文介绍在 pandas 中处理重复数据的方法。通过示例展示如何创建 DataFrame,使用 duplicated() 检测重复项,并利用 drop_duplicates() 移除重复行。重点解析 subset 参数指定特定列,以及 keep 参数('first', 'last', False)控制保留策略,帮助开发者高效清理数据。