

Python Pandas 写入 Excel 文件完整指南:单表与多工作簿操作
本文详细介绍如何使用 Python Pandas 将数据写入 Excel 文件。涵盖两种核心场景:使用 to_excel() 直接保存单个 DataFrame,以及利用 ExcelWriter 配合循环将多个数据写入同一工作簿的不同 Sheet。同时提供 xlrd、xlwt 和 openpyxl 库的安装建议,解决常见依赖问题。
2026-10-13
6

本文详细介绍如何使用 Python Pandas 将数据写入 Excel 文件。涵盖两种核心场景:使用 to_excel() 直接保存单个 DataFrame,以及利用 ExcelWriter 配合循环将多个数据写入同一工作簿的不同 Sheet。同时提供 xlrd、xlwt 和 openpyxl 库的安装建议,解决常见依赖问题。
本文详解pandas库中value_counts()函数的使用方法。涵盖Series单个列的频次统计、默认降序与升序排列、normalize参数计算占比,以及DataFrame多列批量统计。重点解析ascending和normalize参数的具体应用及空值处理机制,帮助开发者高效进行数据分布分析。
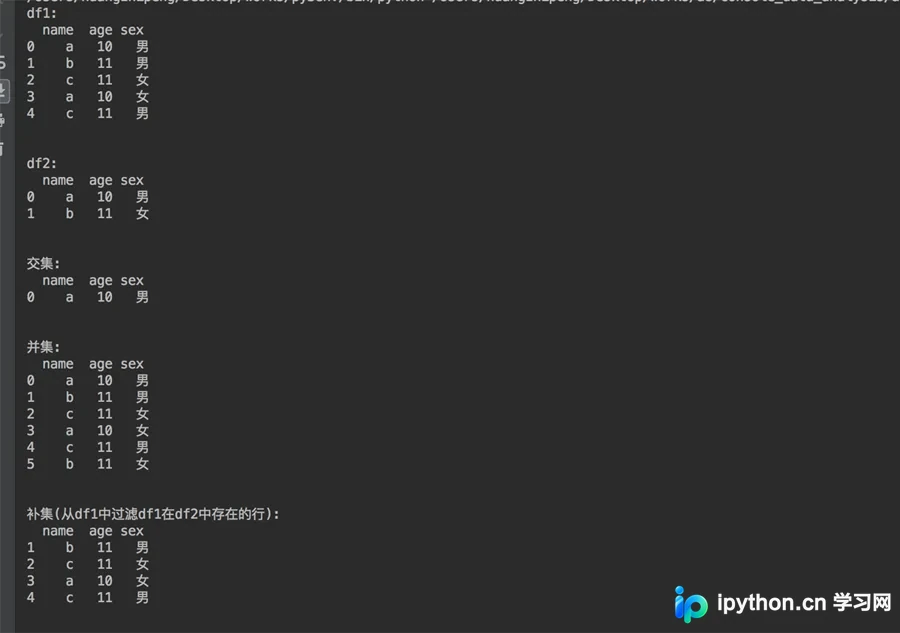
本文介绍在 columns 相同的 DataFrame 中进行集合运算的方法。利用 pd.merge 配合 on 参数可获取交集,设置 how='outer' 获取并集。对于补集(从 df1 中剔除 df2 存在的行),通过 append 合并后使用 drop_duplicates 保留唯一值实现。
本文详细介绍 pandas.cut 函数的核心用途与参数配置。通过解析 bins 的三种形式、right 边界控制、labels 标签映射及 retbins 返回值等关键参数,结合年龄分组实战案例,展示如何实现数据离散化、自定义区间分割及结果可视化,帮助开发者高效处理连续数据的分类问题。
本文系统梳理Python数据挖掘的核心知识体系,涵盖Pandas分组与索引操作、Numpy数组计算与广播机制、Matplotlib与Seaborn可视化技巧,以及最小二乘、梯度下降、决策树等常用算法原理。通过scikit-learn库进行模型实战,帮助初学者掌握从数据预处理到机器学习建模的完整流程。
本文详细介绍Python中pandas库创建DataFrame的多种方法,包括从字典和列表构建数据框、指定列名与顺序、修改列名以及生成随机整数数据。同时演示如何使用时间序列作为索引,并简要提及类SQL操作功能,帮助开发者快速掌握DataFrame的基础构建技巧。
本文系统讲解pandas中DataFrame数据选取的三种层次:行列、区域及单元格。详细解析df[]、df.loc[]、df.iloc[]、df.ix[]、df.at[]及df.iat[]的语法特性与适用场景,通过代码示例展示整数切片、标签索引、布尔数组及Callable对象的使用差异,帮助开发者精准掌握数据定位技巧。
本文介绍在Pandas中处理DataFrame数据的四种删除场景:按列名删除、按索引删除行、基于数值条件筛选以及基于字符串内容的过滤。通过模拟股票交易数据,演示drop方法及布尔索引的使用,帮助开发者掌握灵活的数据清洗技巧。
本文详细介绍pandas中Series数据结构的创建方式,包括通过列表、字典及指定索引生成Series。重点解析元素访问、布尔过滤、标量运算及数学函数应用,并深入讲解Series基于索引的自动对齐机制。同时涵盖Series与索引的命名属性设置,帮助开发者掌握基础数据处理技能。
本文系统整理了24个Python性能优化技巧,涵盖代码计时、查找与循环加速、函数优化、标准库与高阶函数应用、NumPy向量化、Pandas及Dask数据处理,以及多线程多进程并行计算。通过对比低速与高速实现方案,帮助开发者显著提升代码执行效率。
本文介绍如何利用Python的Pandas库,从读取的Dataframe中筛选出满足特定条件的数据行。通过示例展示如何读取包含问号的数据,并过滤掉无效值,实现数据清洗与预处理。
本文介绍pandas 0.23.4版本中DataFrame的行列索引方法。详细解析loc、iloc及已弃用的ix三种方式,涵盖单行/多行、单列/多列及行列同时索引的用法。通过Series与DataFrame返回类型的对比,结合代码示例说明切片范围的闭开区间差异,帮助开发者准确掌握数据筛选技巧。