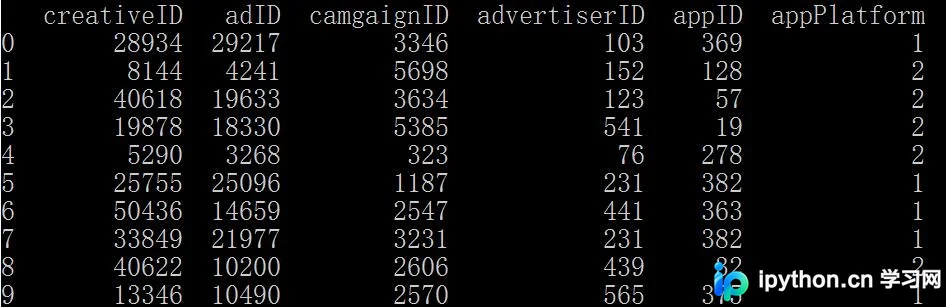
Python使用Pandas读写MySQL数据库的完整指南
本文详解如何在Python中利用Pandas库高效读写MySQL数据库。通过结合pymysql和SQLAlchemy,实现从数据库读取数据生成DataFrame,以及将DataFrame写入数据库表的操作。包含完整的连接配置、查询及写入代码示例,适用于大数据处理场景。
2026-10-15
6

本文详解如何在Python中利用Pandas库高效读写MySQL数据库。通过结合pymysql和SQLAlchemy,实现从数据库读取数据生成DataFrame,以及将DataFrame写入数据库表的操作。包含完整的连接配置、查询及写入代码示例,适用于大数据处理场景。
本文介绍如何使用 Python 读取以空格为分隔符的数据文件,如 Boston 房价预测数据集。通过 pandas 的 read_csv 函数设置 delim_whitespace 参数实现解析,并探讨 header 和 names 参数的用法。此外,提供一个自定义 DealData 类,封装文件加载、折半查找及保存功能,供参考。
本文深入解析Pandas中merge()函数的核心用法,涵盖inner、outer、left、right四种连接模式。详细讲解how、on、left_on、right_on、suffixes等关键参数的配置方法,并通过具体代码示例演示如何处理多列匹配、索引连接及重复列后缀处理,帮助开发者高效实现数据集合并。
本文详解Pandas中提取单个单元格值的两种方法。使用iloc返回DataFrame对象,而values属性返回嵌套列表。通过示例展示如何结合索引与values[0][0]获取纯数值,并解决将Series写入Excel时的类型报错问题,提供实用的代码参考。
本文介绍如何使用Python的Pandas库对CSV文件进行行列删除操作。通过read_csv读取数据,利用drop函数指定axis参数删除指定列或行,并设置inplace参数控制是否修改原数据。最后通过to_csv保存结果,支持指定编码和索引显示。
本文详细介绍在Pandas中创建Category类型数据的两种主要方法。首先讲解如何直接指定预设类别创建分类数据,其次演示如何利用分箱机制(结合max、mean、min)动态生成Category类型。通过具体代码示例,展示如何处理空值、NaN及多字段数据分类,帮助开发者高效进行数据预处理与分类管理。
本文介绍在 pandas 中颠倒 DataFrame 列顺序的两种常用方法。第一种适用于列数较少的情况,通过手动指定列名列表实现;第二种利用 pandas 内置切片功能,适合处理列数较多的数据,操作更为简便高效。
本文详解使用pandas读取txt、csv、excel及pkl文件的具体命令。重点解析read_csv与read_table在处理非标准分隔符txt文件时的差异,通过sep参数解决列解析错误。同时提供线上部署模型时读取excel和pkl文件的完整Python代码示例,涵盖路径适配与测试流程。
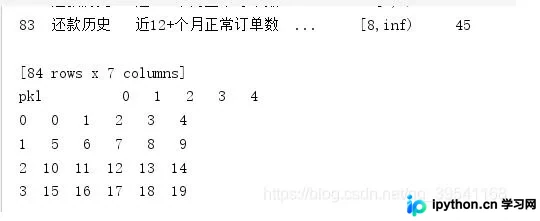
本文介绍使用Python的pandas、xlrd和openpyxl库合并Excel文件中指定Sheet的方法。重点解决合并后出现的列顺序错乱及自动生成Unnamed:0列的问题,通过设置header=None、index_col=0和index=False等参数实现数据正确合并与保存。
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
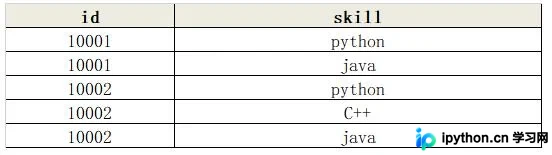
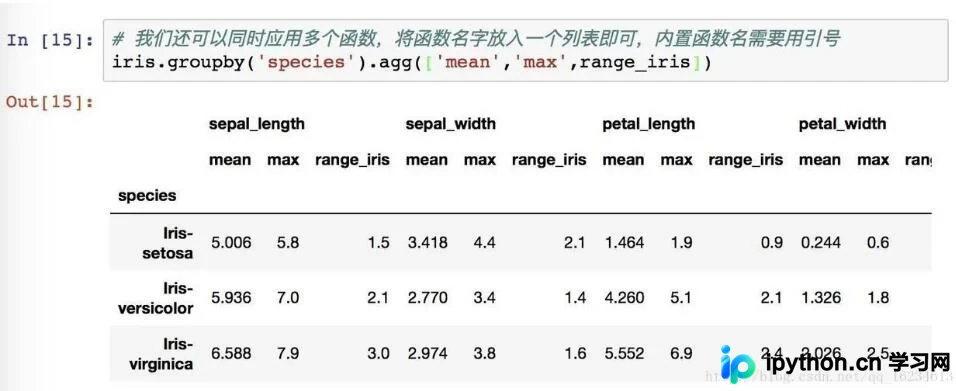
本文详细解析Pandas中groupby后的agg、apply和transform三个方法的核心区别。agg针对单列返回标量,apply接收整个DataFrame并支持复杂逻辑,transform则保持原索引进行广播。通过具体代码实例说明如何在不同场景下选择合适的方法,并解决groupby索引冗余等常见问题。
本文介绍在Pandas中处理混合类型数据及过滤特定值的方法。通过示例展示如何处理read_csv读取时的类型警告,利用str.isdigit()筛选纯数字列,以及使用isin()和逻辑与操作符剔除包含特定数值或多条件组合的异常数据行。