

Pandas处理混合类型数据与过滤特定值的方法

本文介绍在Pandas中处理混合类型数据及过滤特定值的方法。通过示例展示如何处理read_csv读取时的类型警告,利用str.isdigit()筛选纯数字列,以及使用isin()和逻辑与操作符剔除包含特定数值或多条件组合的异常数据行。
在常规数据处理过程中,指标字段常混入非数值内容,这会直接干扰后续的计算与分析流程。
| name | height |
| Hang | 180 |
| Ben | 145 |
| Cho | notknow |
| XIn | 189 |
例如,使用read_csv读取文件时,若列中包含非数字字符,该列会被识别为object类型,无法直接进行数学运算,进而引发如unsupported operand type(s) for +: 'float' and 'str'的类型错误。
为解决此问题,需执行数据预处理以清除指标值中的非数字成分。以下以2012_FederalElectionCommission_Database数据集为例进行说明。
初次读取数据时,系统会提示Columns (6) have mixed types,这表明第6列指标值中混杂了字符串格式的数据。
fec = pd.read_csv('P00000001-ALL.csv')
D:\SOFTWARE\Anaconda\lib\site-packages\IPython\core\interactiveshell.py:2717: DtypeWarning: Columns (6) have mixed types. Specify dtype option on import or set low_memory=False.
 interactivity=interactivity, compiler=compiler, result=result)
#先使用str打开数据
fec = pd.read_csv('P00000001-ALL.csv',dtype={'contbr_zip':str})

#然后使用str函数isdigit()判断单元格是否全为数字

fec_isnum=fec.iloc[:,6].str.isdigit()

#得到使用bool索引把全为数字的表格cleaned

cleaned = fec[fec_isnum].copy()
补充:pandas如何去掉、过滤数据集中的某些值或者某些行?
在数据分析与清理环节,经常需要移除数据集中的异常值。具体操作可参考以下示例。
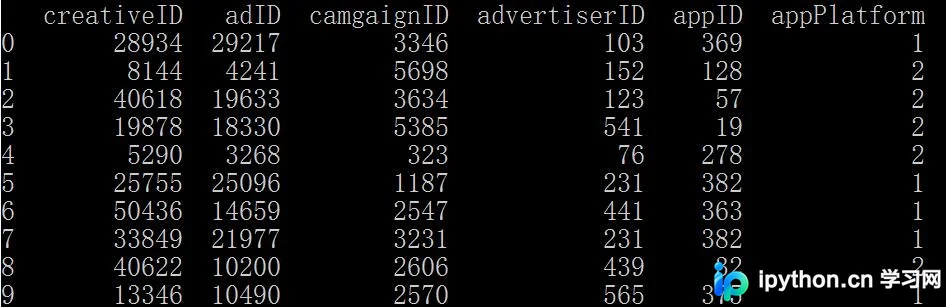
0.导入我们需要使用的包
import pandas as pdpandas是常用的数据分析与处理库。若使用anaconda环境,该包已预装;若是纯净版python,需通过pip自行安装。
1.去掉某些具体值
针对数据集df,若需删除属性appPlatform(最后一列)中取值为2的样本。
实现方法非常简单。
import pandas as pd
df[(True-df['appPlatform'].isin([2]))]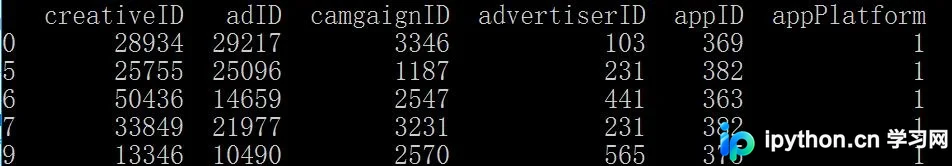
若需移除多个值,只需在isin([])列表中添加对应值。例如,针对appID属性,若要移除appID=278和appID=382的样本。
df[(True-df['appID'].isin([278,382]))]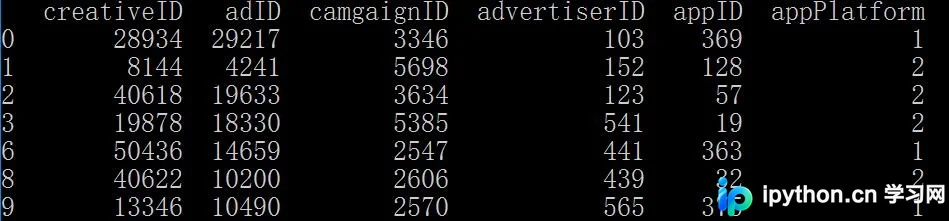
此外,有时需同时考虑多列情况。例如,需过滤掉appPlatform=2且appID=278或appID=382的样本。
df[(True-df['appID'].isin([278,382]))&(True-df['appPlatform'].isin([2]))]此处逻辑由两部分组成:第一部分是appID等于278和382,第二部分是appPlatform等于2。两者通过逻辑与(&)关系结合。
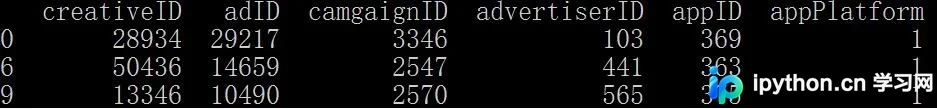
2.过滤掉某个范围的值
前述操作针对具体值,下面介绍如何过滤特定范围的值。
对于数据集df,若需过滤掉creativeID(第一列)中ID值大于10000的样本。
df[df['creativeID']<=10000]
若需考虑多列,方法与前述相同,将各条件进行逻辑与(&)运算即可。注意每个条件需用括号()包裹。
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









