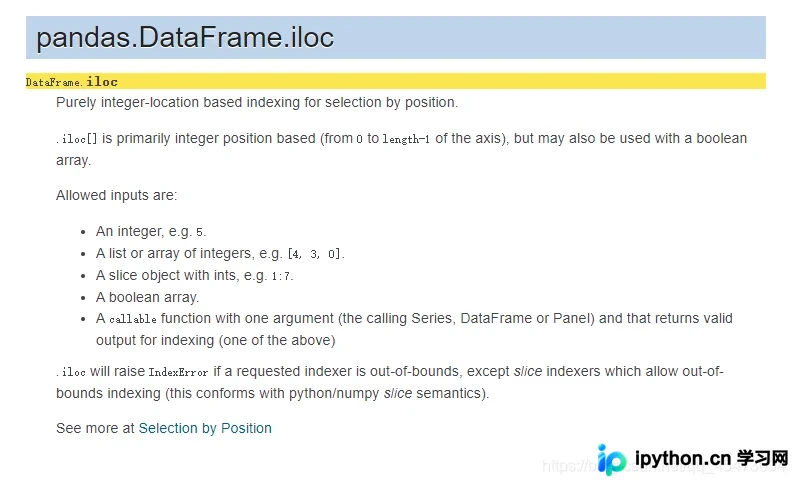
pandas.DataFrame.iloc索引方法详解:五种用法与实战示例
本文详细解析pandas中DataFrame.iloc方法的五种索引方式,包括整数索引、列表索引、切片索引、布尔数组索引及可调用函数索引。通过具体代码示例演示如何精准提取行、列及子集数据,帮助开发者掌握高效的数据筛选技巧。
2026-10-15
6

本文详细解析pandas中DataFrame.iloc方法的五种索引方式,包括整数索引、列表索引、切片索引、布尔数组索引及可调用函数索引。通过具体代码示例演示如何精准提取行、列及子集数据,帮助开发者掌握高效的数据筛选技巧。
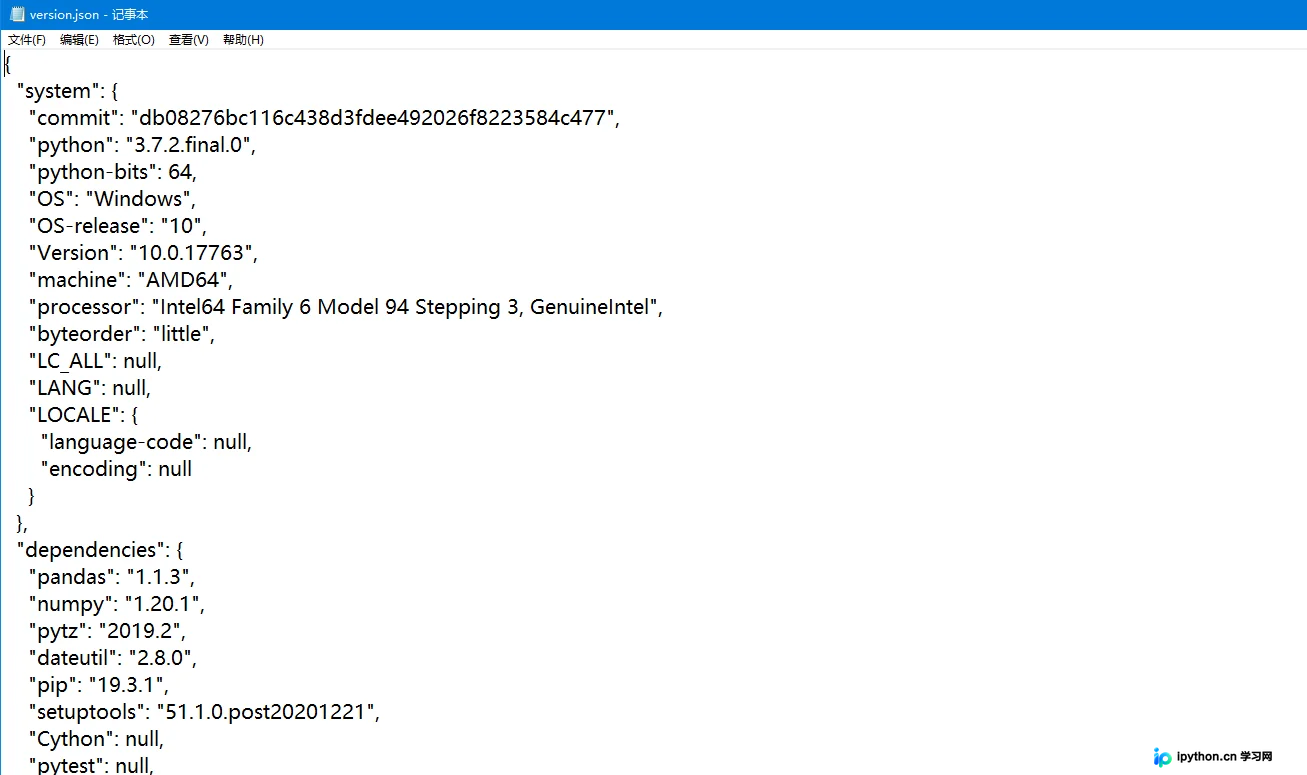
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
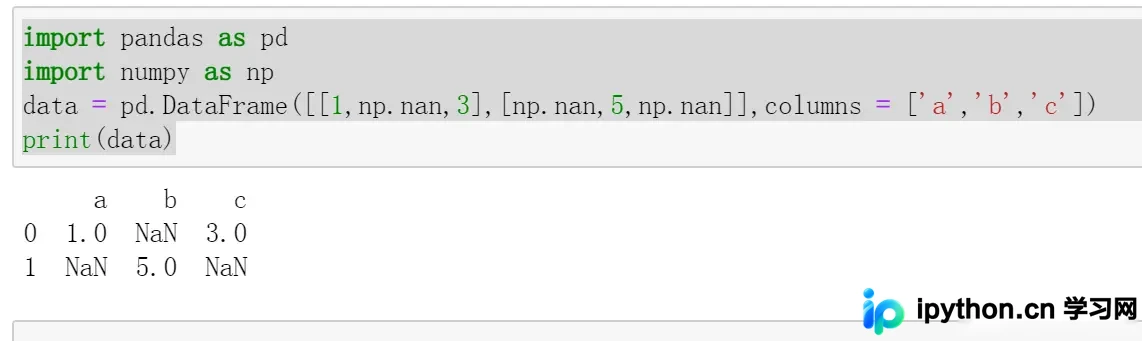
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵,isnull().any()如何识别含缺失值的列,以及isnull().sum()如何统计每列缺失值数量。结合代码示例与结果分析,帮助开发者快速掌握缺失值检测技巧。
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
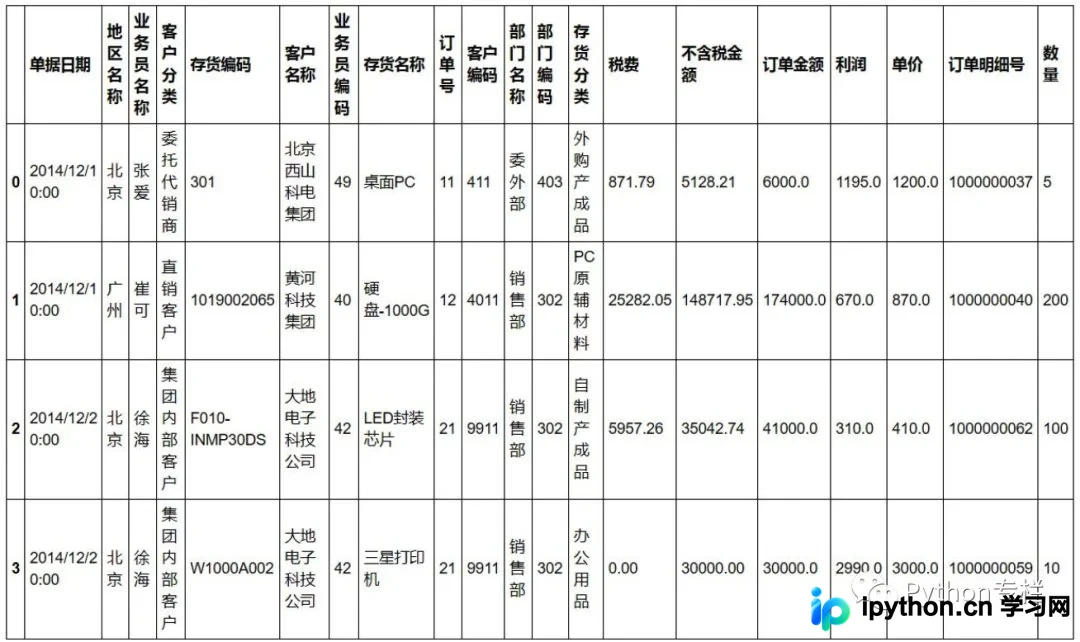
本文介绍如何利用Python Pandas库实现Excel文件的批量拆分与合并。首先演示如何将单个大型Excel按行数等分为多个子文件,并保存至指定目录;接着展示如何遍历文件夹读取多个小Excel,通过添加来源列并使用pd.concat进行合并,最终输出包含来源标记的完整大文件。
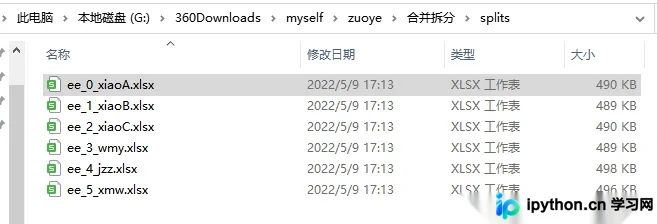
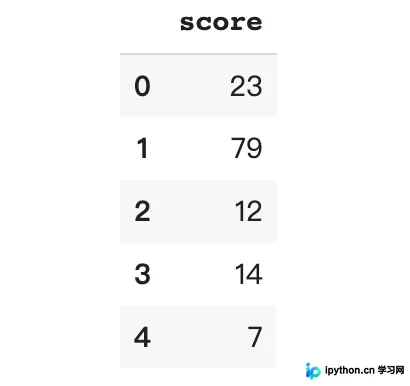
本文详细总结Pandas中对数值变量进行分箱(离散化)的四种常用方法。通过合成学生成绩数据,演示如何使用between结合loc、pd.cut、pd.qcut以及value_counts实现不同场景下的分箱需求,包括固定区间划分、等频分箱及基于统计量的分组,并对比各方法的参数设置与结果差异。
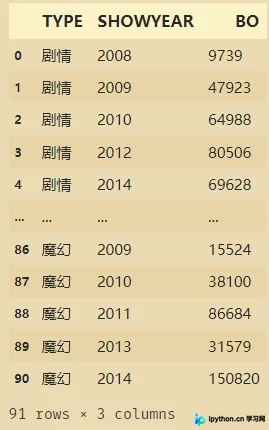
本文记录使用 Python pyecharts 库绘制 Boxplot 箱线图的完整过程。内容涵盖从 Excel 读取数据、利用 pandas 进行分组聚合与转置处理,到构建 y_data 列表并调用 pyecharts 的 Boxplot 类生成交互式图表。文中提供了详细代码示例,包括数据清洗、循环提取及最终渲染步骤,适用于需要展示电影票房等数据统计分布的场景。
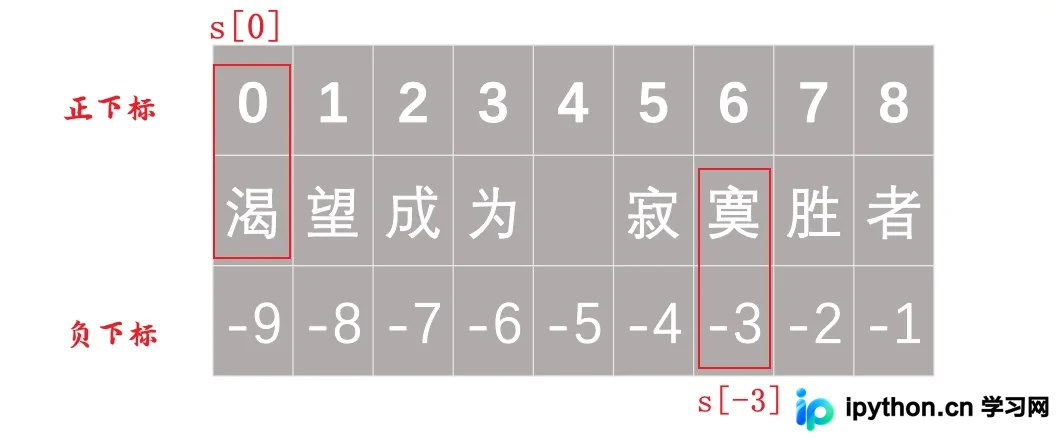
本文详细解析Python Pandas库中iloc与loc两种切片方法的实现机制。文章首先阐述含正负号下标的切片规则,随后对比iloc基于整数位置与loc基于标签索引的核心区别。通过具体代码示例,演示如何利用两者提取指定行、列、全表数据,以及基于条件的行筛选操作,帮助开发者准确掌握数据选取技巧。
本文详细介绍pandas中实现数据合并的四种核心方法:concat、merge、join和append。重点解析concat函数的axis、join、ignore_index等参数,merge的on、how、suffixes配置,以及join与merge在连接轴和数量上的差异,配合代码示例帮助快速掌握数据合并技巧。
本文详细介绍Python中Pandas库对Dataframe进行条件筛选与遍历的常用方法。涵盖单条件、多条件(逻辑与或)及取反筛选,以及iteritems、iterrows和itertuples三种遍历方式,帮助开发者高效处理数据。
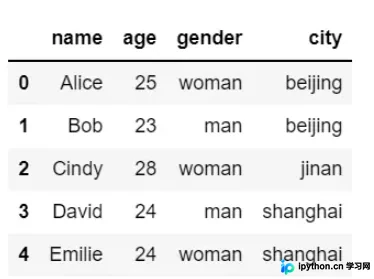
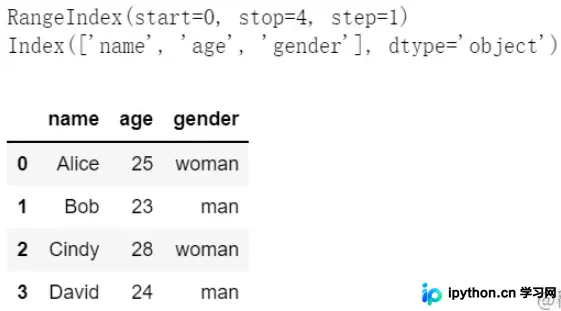
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作。涵盖通过 index 和 columns 获取索引,利用 []、loc、iloc、at、iat 进行元素查询;使用 rename 修改行列索引,通过指定位置赋值修改元素值;以及利用 drop 方法按标签或轴删除行与列,并解析各方法的参数与注意事项。
本文详解Python中处理缺失值的两种核心策略:删除与填充。通过演示isnull/isna检测空值,使用dropna按行或阈值删除含NaN数据,以及利用fillna结合均值进行数据补全,帮助开发者掌握Pandas中缺失值处理的关键函数与参数设置。