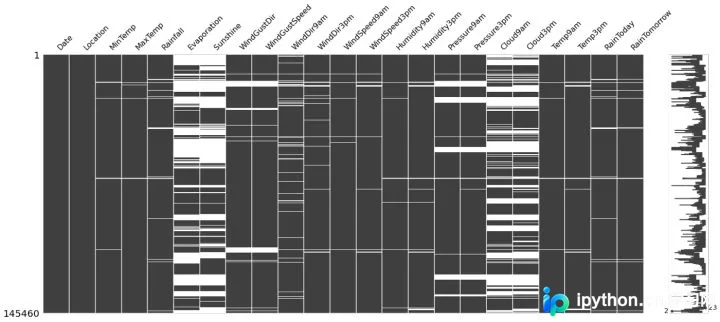
Python数据清洗实战:从缺失值到数据泄漏的完整处理流程
本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
2026-10-15
6

本文详细介绍利用Python进行数据清洗的核心步骤。涵盖缺失值的分析与填补策略、基于IQR的异常值识别与裁剪、字符型数据不一致性的手动修正,以及无效数据的逻辑校验。重点强调在预处理前必须拆分数据集以规避数据泄漏,并推荐使用sklearn Pipeline简化流程,确保模型评估的独立性。
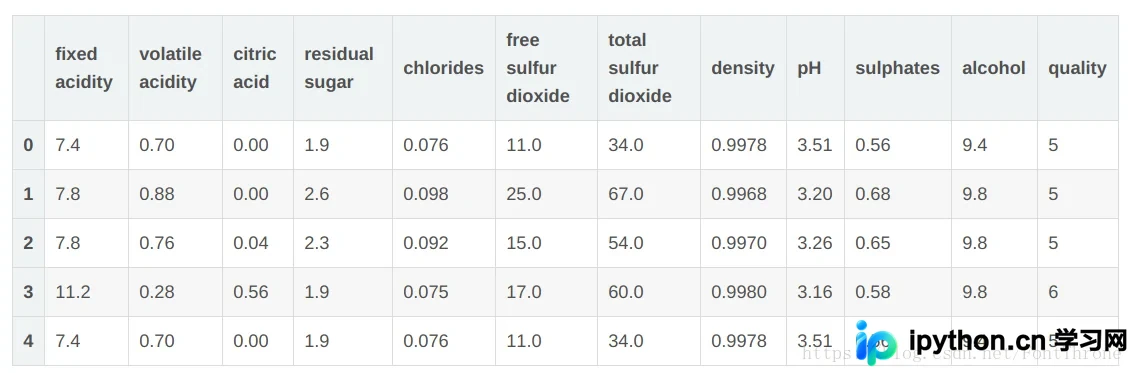
本文介绍如何使用Python实现灰色关联分析,通过改写现有算法使其支持对整个数据矩阵进行批量计算,形式类似Pandas中的相关性计算。文章提供基于UCI红酒质量数据集的完整代码,包括数据下载、无量纲化处理、关联度计算及热力图可视化,帮助读者快速掌握灰色系统理论在动态历程分析中的应用。
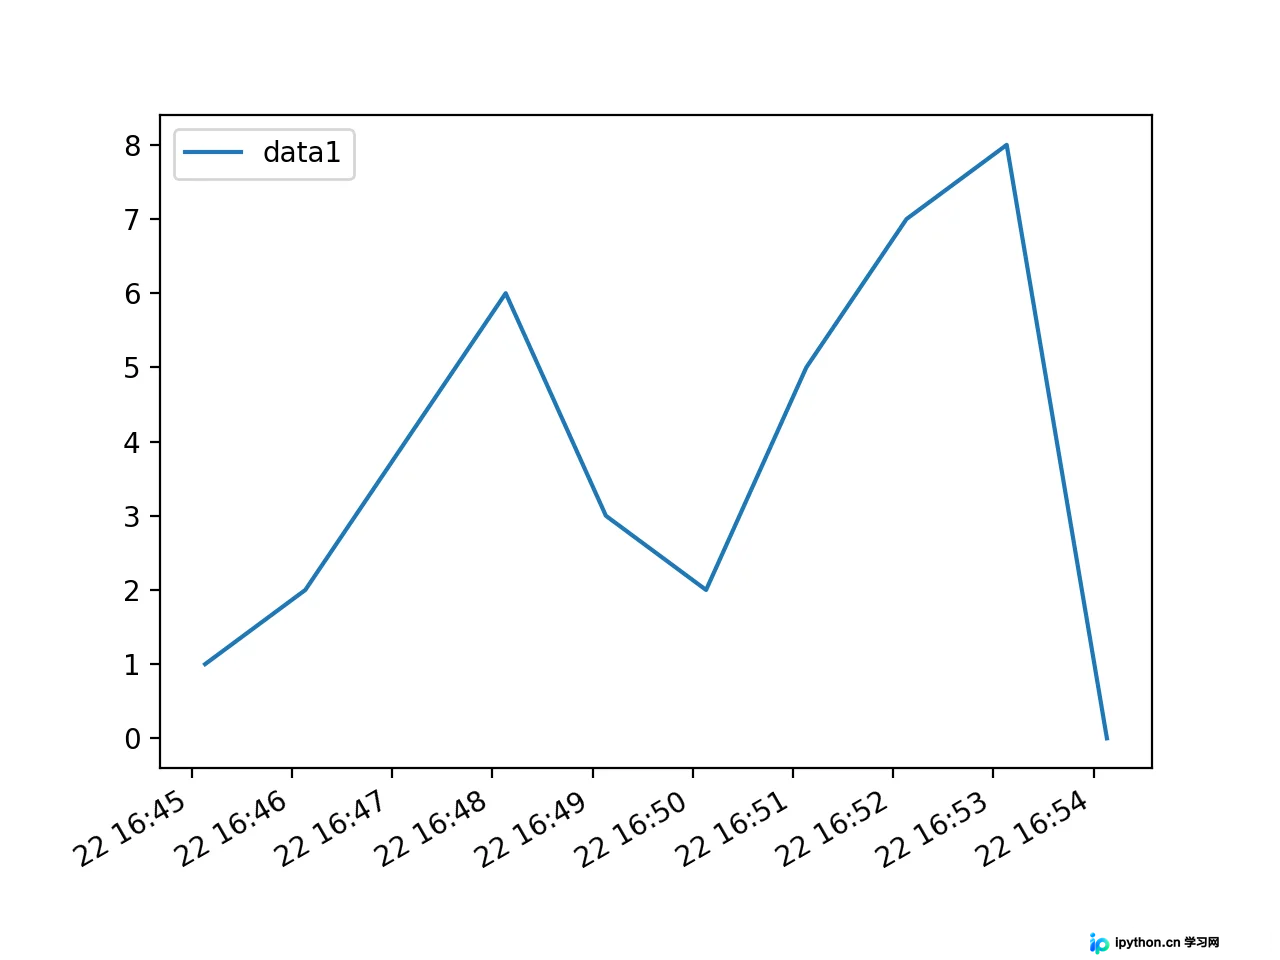
本文介绍如何使用Python中的pandas和matplotlib库将列表数据转换为折线图。通过定义DatetimeIndex作为横坐标索引,分别演示了单条数据线及多条数据线在同一图表中的绘制方法,并提供了保存高清图片的代码示例。
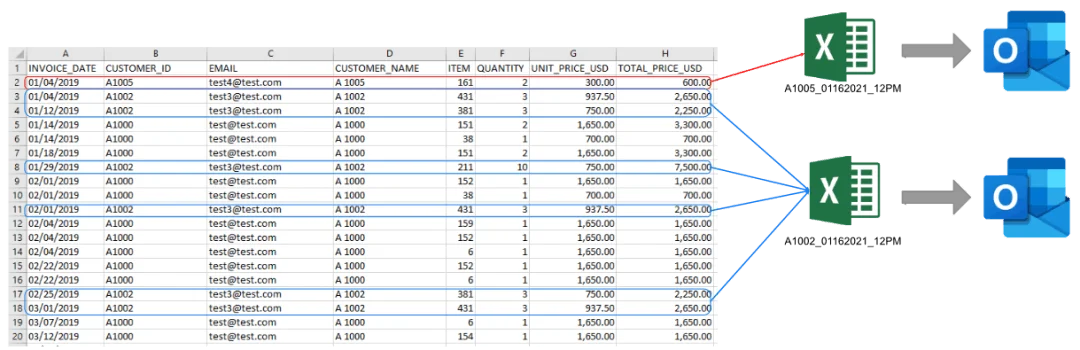
本文介绍如何使用Python自动化处理Excel数据拆分与邮件发送任务。通过pandas库将主Excel文件按用户ID分组生成独立文件,利用win32com库调用Outlook接口,自动将生成的Excel文件作为附件发送给指定邮箱用户,实现批量办公自动化。
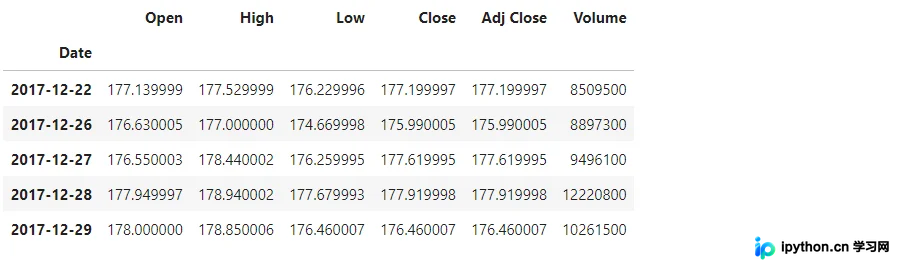
本文介绍如何使用 Python pandas 库计算股票数据的增长率。通过 pct_change() 方法获取逐行环比增长率,并结合自定义函数计算相对于起始值的累计增长率。示例基于 Facebook 2017年股票数据,展示数据读取、增长率计算及格式化输出的完整流程。
本文总结了在Pandas中批量替换字符的六种常用方法,包括map、replace、apply等函数的具体应用。通过实际代码示例,详细演示了如何将编码列批量转换为特定文本,帮助开发者高效完成数据清洗任务。
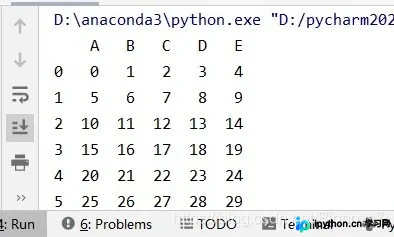
本文详细解析Pandas库中loc和iloc两种核心数据提取方法。loc基于标签索引,支持通过行列名、条件筛选及区域切片获取数据;iloc基于整数位置索引,适用于按物理位置精确提取。文章通过具体代码示例演示了单行、单列、区域及条件读取的操作,并强调切片时左闭右开的区间特性,帮助开发者高效处理DataFrame数据。
本文详细介绍在Pandas DataFrame中高效添加数据的方法。通过df.loc()函数在末尾添加单行,以及使用df.append()合并多个DataFrame的行。文章提供Python代码示例,演示如何操作points、rebounds等列,并补充优雅添加单列的技巧,帮助开发者掌握数据增补的核心操作。
本文介绍在Pandas中修改DataFrame值时如何避免链式索引(Chained Indexing)导致的SettingWithCopyWarning。通过对比直接链式访问与使用loc方法的差异,说明直接标签访问的潜在问题,并推荐正确的赋值方式以确保数据修改生效。
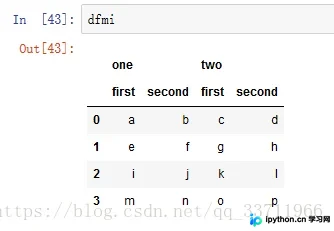
本文详细介绍Pandas中loc方法的布尔索引用法。通过具体代码示例,演示如何利用loc进行单条件筛选(如字段值大于特定阈值)及多条件组合筛选(使用&连接多个条件)。深入解析loc接收Series类型布尔值的过程,帮助开发者掌握高效的数据子集提取技巧。
本文详细介绍在Python中读取TXT数据的三种主流方法。首先演示使用内置open函数进行基础读取与列表转换;其次讲解利用NumPy的loadtxt方法处理纯数值型实验数据,强调其返回ndarray类型的特性;最后介绍通过Pandas的read_table方法处理更复杂的文本格式,返回DataFrame对象。内容涵盖环境配置、代码示例及结果分析,适用于不同场景下的数据读取需求。
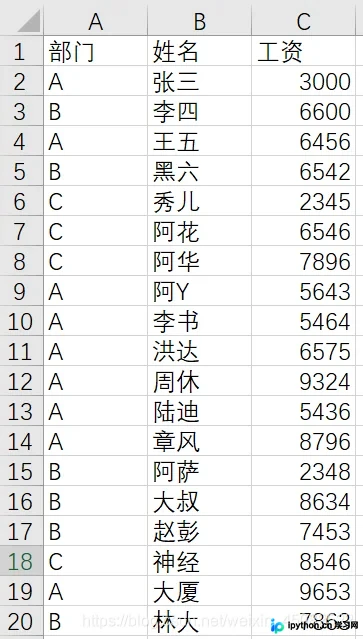
本文详细介绍如何使用Python Pandas库从Excel或CSV文件中读取指定的行和列数据。通过loc和iloc函数,您可以基于索引、位置或特定条件(如部门、工资范围)精准提取数据,并演示如何将筛选结果导出为新的Excel或CSV文件。