Pandas实现在线文件和剪贴板数据读取详解
本文详细介绍Pandas中两种高效的数据读取方式:利用read_html直接解析网页表格,以及通过read_clipboard快速导入剪贴板数据。文章涵盖在线HTML与CSV文件的读取技巧,并提供具体代码示例与操作注意事项,帮助开发者简化数据获取流程。
2026-10-16
6

本文详细介绍Pandas中两种高效的数据读取方式:利用read_html直接解析网页表格,以及通过read_clipboard快速导入剪贴板数据。文章涵盖在线HTML与CSV文件的读取技巧,并提供具体代码示例与操作注意事项,帮助开发者简化数据获取流程。
本文详细介绍Python中help函数的使用方法。通过交互式命令行,开发者可以利用help()查看模块、类方法、变量及内置函数(如print)的详细文档。文章演示了如何通过命令查看pandas模块及其read_csv函数的接口说明,并指导用户通过回车键分页浏览长文档,解决英文文档阅读障碍,提升开发效率。
本文详细介绍Pandas中DataFrame的核心用法,涵盖从创建、索引选取、行列删除到数学运算与Groupby聚合的完整流程。通过具体代码示例,解析如何处理多维数据、执行映射与聚合操作,并演示导出CSV文件的注意事项,助力高效进行Python数据分析。
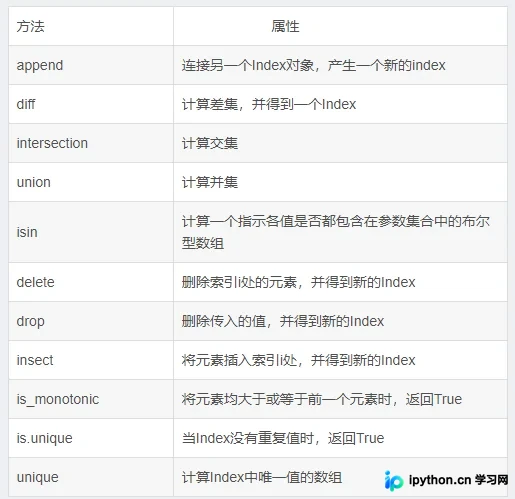
本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。
本文介绍如何利用Python的Openpyxl库对Excel文件中的特定单元格进行颜色填充。通过结合Pandas读取数据与Openpyxl操作样式,实现自动识别并高亮显示大于50的数值。文章详细讲解了PatternFill的使用、Excel列名的动态生成逻辑以及完整的代码实现流程,帮助开发者解决Excel批量格式化处理需求。

本文详细介绍在pandas DataFrame中批量修改数据的四种常用方法。通过iloc进行行列定位赋值,利用where和mask函数根据条件替换数值,以及使用replace函数处理文本、字典映射及正则表达式。涵盖具体代码示例与参数说明,帮助开发者高效完成数据清洗与预处理任务。
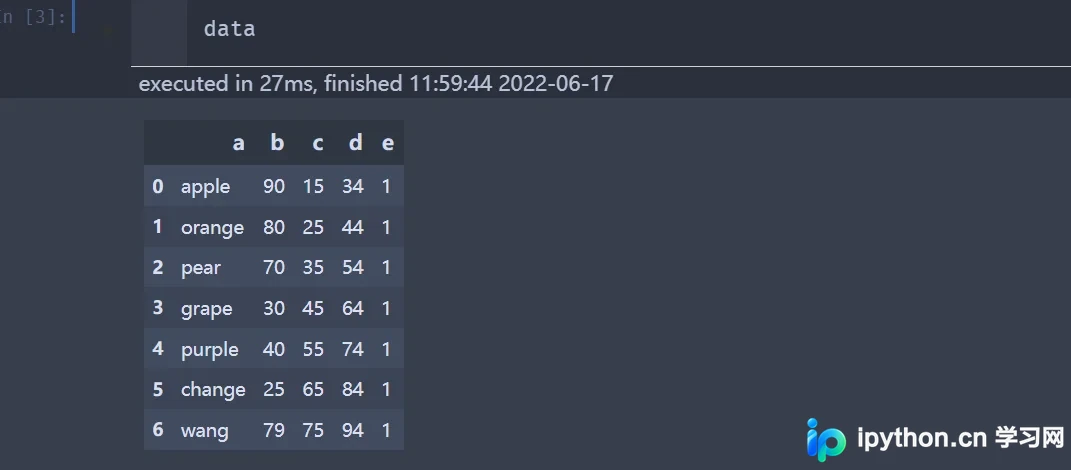
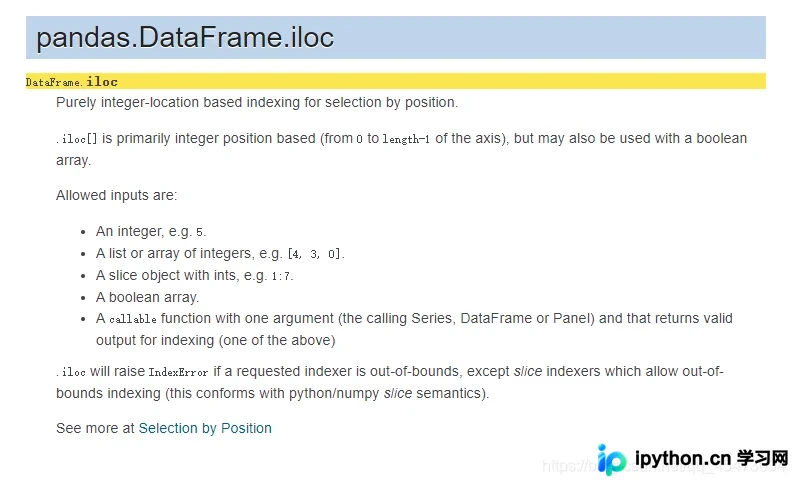
本文详细解析pandas中DataFrame.iloc方法的五种索引方式,包括整数索引、列表索引、切片索引、布尔数组索引及可调用函数索引。通过具体代码示例演示如何精准提取行、列及子集数据,帮助开发者掌握高效的数据筛选技巧。
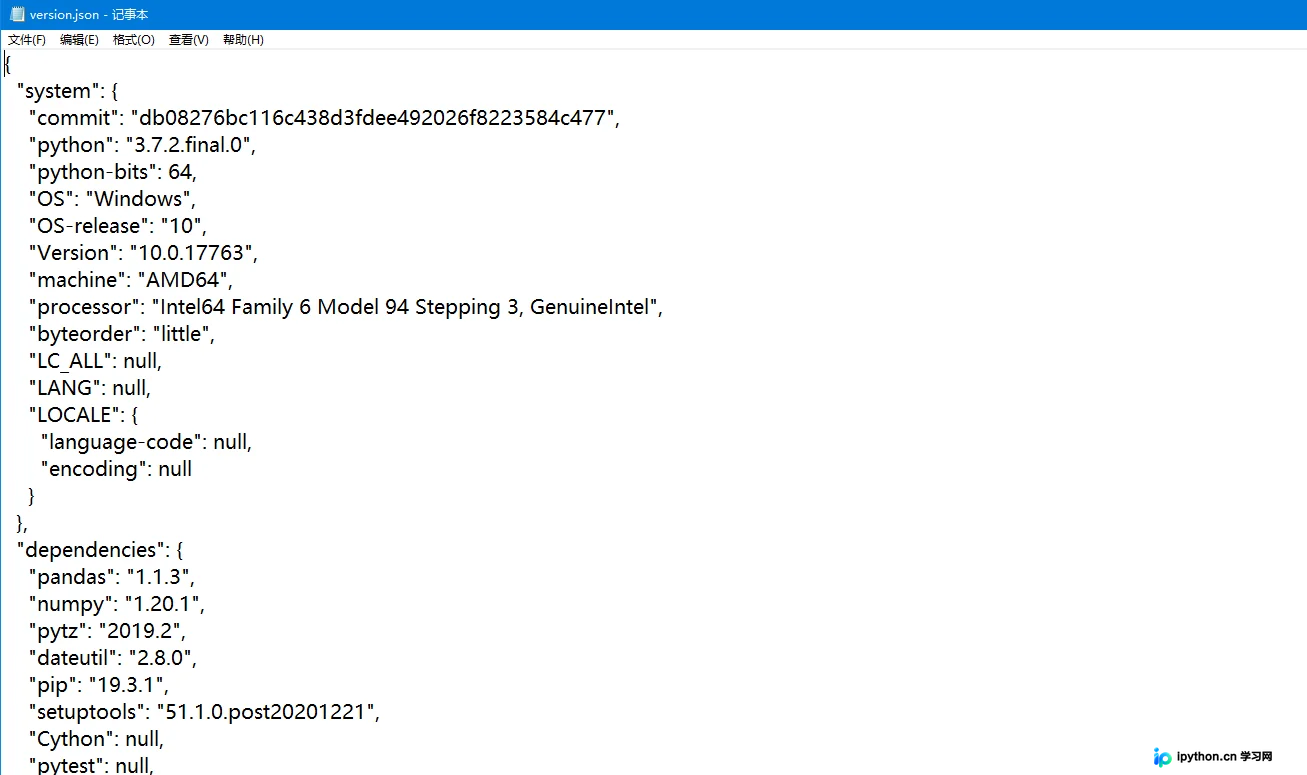
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
本文详细介绍Python中pandas库的pd.cut()和pd.qcut()函数在数据分箱中的应用。pd.cut用于基于指定区间的离散化,支持自定义边界和标签;pd.qcut则根据分位数生成等频箱。文章通过代码示例演示了区间开闭控制、自定义标签及精度设置等关键参数,帮助开发者掌握数据预处理中的分箱技巧。
本文详细介绍Python pandas库中isnull()函数的使用方法。通过创建包含缺失值的DataFrame,演示isnull()如何返回布尔值矩阵,isnull().any()如何识别含缺失值的列,以及isnull().sum()如何统计每列缺失值数量。结合代码示例与结果分析,帮助开发者快速掌握缺失值检测技巧。
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
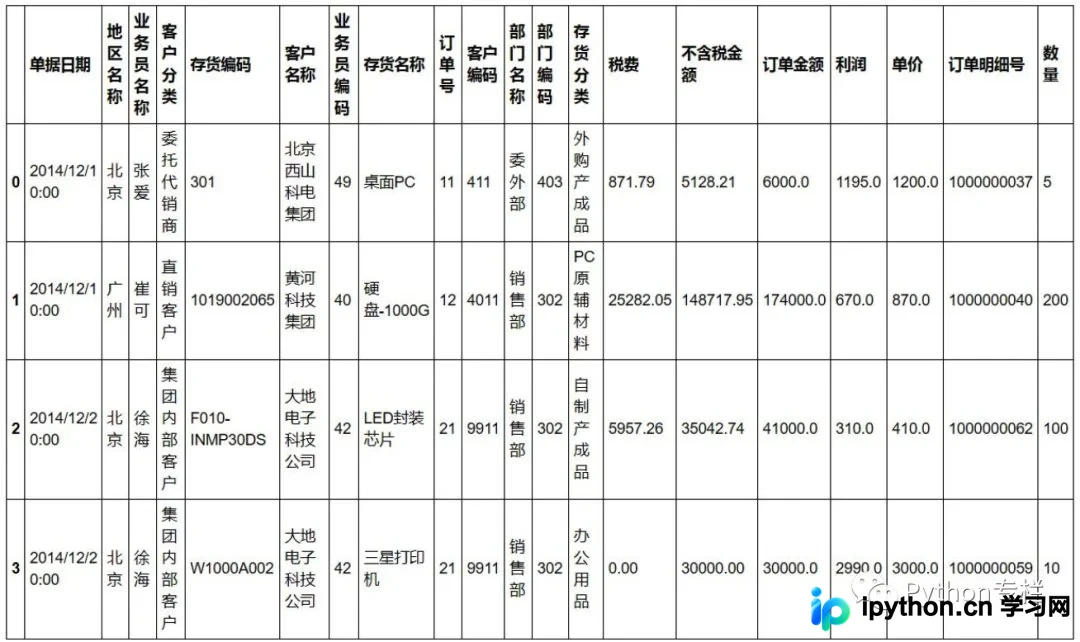
本文介绍如何利用Python Pandas库实现Excel文件的批量拆分与合并。首先演示如何将单个大型Excel按行数等分为多个子文件,并保存至指定目录;接着展示如何遍历文件夹读取多个小Excel,通过添加来源列并使用pd.concat进行合并,最终输出包含来源标记的完整大文件。