

14个用Python实现的Excel常用操作总结

本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
前言
自学习Python以来,作者刻意避免使用Excel,转而尝试用Python完成所有相关操作。这一做法旨在巩固Python编程技能,并增强数据处理能力。
这也是撰写本文的初衷。接下来直接进入正题。
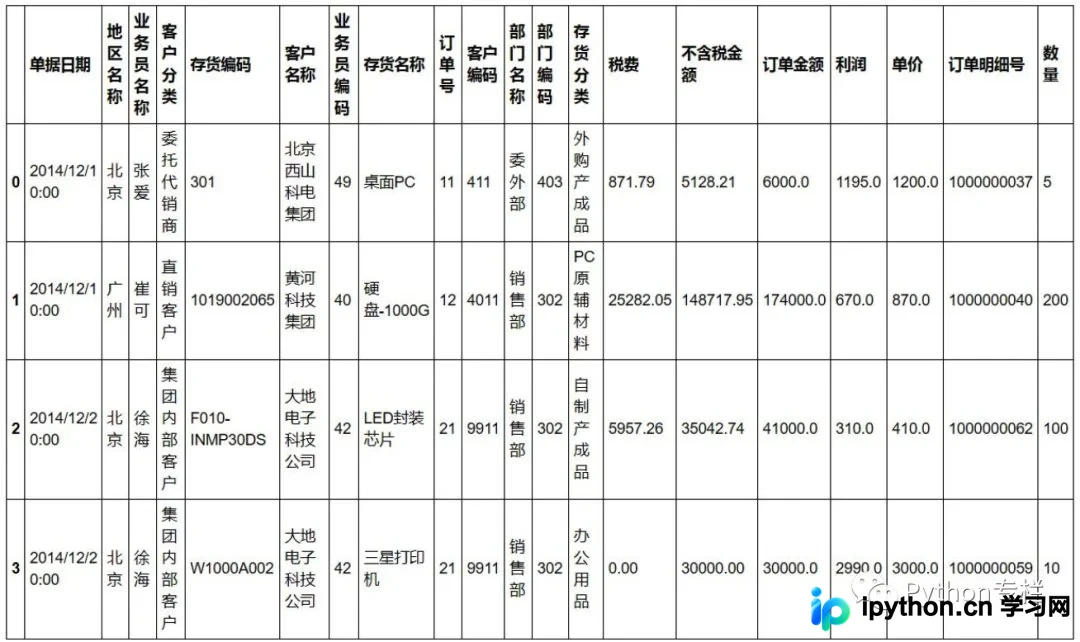
文中使用的数据为网上获取的销售数据,大致结构如下:
一、关联公式:Vlookup
Vlookup是Excel中最常用的公式之一,通常用于两个表格之间的关联查询。为此,作者先将原始数据表拆分为两个子表。
df1=sale[['订单明细号','单据日期','地区名称', '业务员名称','客户分类', '存货编码', '客户名称', '业务员编码', '存货名称', '订单号',
       '客户编码', '部门名称', '部门编码']]
df2=sale[['订单明细号','存货分类', '税费', '不含税金额', '订单金额', '利润', '单价','数量']]
需求:查询df1中每个订单对应的利润值。
利润数据位于df2表中,因此需要关联df1的每个订单以获取对应利润。在Excel中,首先需确认订单明细号为唯一值,然后在df1中新建一列,输入公式:=vlookup(a2,df2!a:h,6,0),并向下填充即可。(其余13个操作不再赘述Excel实现方式)
那么,在Python中如何实现这一功能呢?
#查看订单明细号是否重复,结果是没。
df1["订单明细号"].duplicated().value_counts()
df2["订单明细号"].duplicated().value_counts()

df_c=pd.merge(df1,df2,on="订单明细号",how="left")
二、数据透视表
需求:统计每个地区每位业务员赚取的利润总和与平均利润。
pd.pivot_table(sale,index="地区名称",columns="业务员名称",values="利润",aggfunc=[np.sum,np.mean])
三、对比两列差异
由于表中各列数据维度不同,直接比较意义不大,因此先对订单明细号进行差异分析,再进行后续比较。
需求:比较订单明细号与订单明细号2的差异,并显示结果。
sale["订单明细号2"]=sale["订单明细号"]

#在订单明细号2里前10个都+1.
sale["订单明细号2"][1:10]=sale["订单明细号2"][1:10]+1

#差异输出
result=sale.loc[sale["订单明细号"].isin(sale["订单明细号2"])==False]
四、去除重复值
需求:去除业务员编码列中的重复值。
sale.drop_duplicates("业务员编码",inplace=True)五、缺失值处理
首先检查销售数据中哪些列存在缺失值。
#列的行数小于index的行数的说明有缺失值,这里客户名称329<335,说明有缺失值
sale.info()
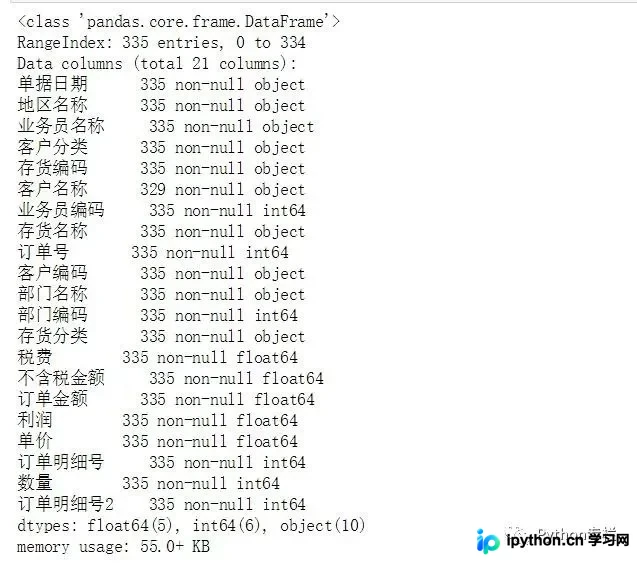
需求:使用0填充缺失值,或删除包含客户编码缺失值的行。实际上,缺失值处理的方法复杂多样:对于数值变量,常用平均数、中位数或众数填充;复杂场景下可使用随机森林模型基于其他维度预测结果进行填充。对于分类变量,依据业务逻辑填充往往更准确。例如,若需填充客户名称缺失值,可根据存货分类中出现频率最高的存货所对应的客户名称进行填充。
此处采用简单处理方式:使用0填充缺失值,或删除包含客户编码缺失值的行。
#用0填充缺失值
sale["客户名称"]=sale["客户名称"].fillna(0)
#删除有客户编码缺失值的行
sale.dropna(subset=["客户编码"])
六、多条件筛选
需求:查询业务员张爱在北京区域销售的商品中,订单金额大于6000的信息。
sale.loc[(sale["地区名称"]=="北京")&(sale["业务员名称"]=="张爱")&(sale["订单金额"]>5000)]七、 模糊筛选数据
需求:筛选存货名称包含“三星”或“索尼”的信息。
sale.loc[sale["存货名称"].str.contains("三星|索尼")]八、分类汇总
需求:计算北京区域各业务员的利润总额。
sale.groupby(["地区名称","业务员名称"])["利润"].sum()九、条件计算
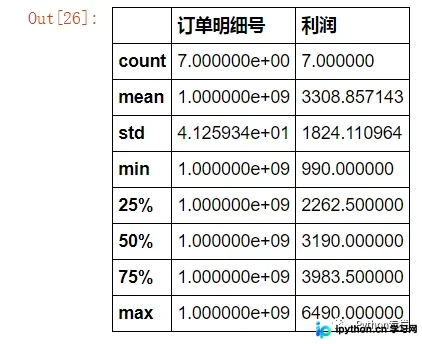
需求:统计存货名称含“三星”且税费高于1000的订单数量,并计算这些订单的利润总和、平均利润(或最小值、最大值、四分位数、标准差)。
sale.loc[sale["存货名称"].str.contains("三星")&(sale["税费"]>=1000)][["订单明细号","利润"]].describe()
十、删除数据间的空格
需求:去除存货名称两侧的空格。
sale["存货名称"].map(lambda s :s.strip(""))十一、数据分列
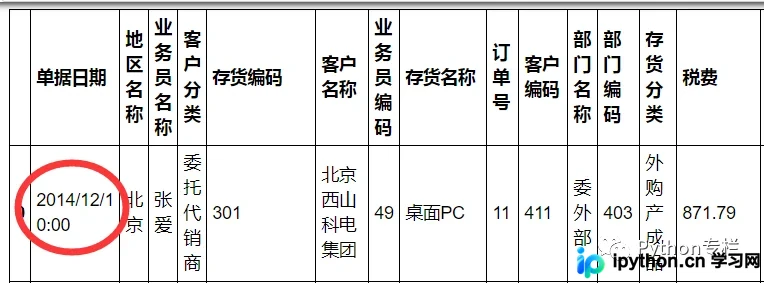
需求:将日期与时间字段拆分为两列。
sale=pd.merge(sale,pd.DataFrame(sale["单据日期"].str.split(" ",expand=True)),how="inner",left_index=True,right_index=True)
十二、异常值替换
首先使用describe()函数简要查看数据是否存在异常值。
#可看到销项税有负数,一般不会有这种情况,视它为异常值。
sale.describe()
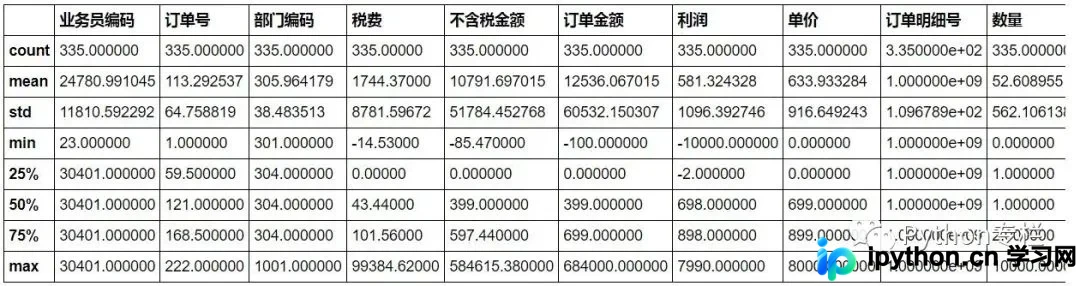
需求:使用0替换异常值。
sale["订单金额"]=sale["订单金额"].replace(min(sale["订单金额"]),0)十三、分组
需求:根据利润数据分布,将地区划分为“较差”、“中等”、“较好”、“非常好”四个等级。
首先,查看利润数据的分布情况,此处采用四分位数进行判断。
sale.groupby("地区名称")["利润"].sum().describe()
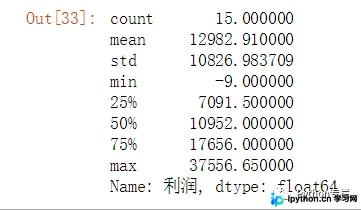
根据四分位数,将地区总利润在[-9,7091]区间的分组为“较差”,(7091,10952]区间的分组为“中等”,(10952,17656]区间的分组为“较好”,(17656,37556]区间的分组为“非常好”。
#先建立一个Dataframe
sale_area=pd.DataFrame(sale.groupby("地区名称")["利润"].sum()).reset_index()

#设置bins,和分组名称
bins=[-10,7091,10952,17656,37556]
groups=["较差","中等","较好","非常好"]

#使用cut分组
#sale_area["分组"]=pd.cut(sale_area["利润"],bins,labels=groups)
十四、根据业务逻辑定义标签
需求:筛选销售利润率(即利润/订单金额)大于30%的商品,并标记为“优质商品”;小于5%的标记为“一般商品”。
sale.loc[(sale["利润"]/sale["订单金额"])>0.3,"label"]="优质商品"
sale.loc[(sale["利润"]/sale["订单金额"])<0.05,"label"]="一般商品"
Excel中常用的操作还有很多,此处仅列举了14个作者较为常用的操作。若读者有其他操作需求,欢迎评论交流。此外,作者自知Python代码尚不够精简,习惯使用loc(实际上query可能更简洁)。若各位有更好的写法,请务必在评论区告知,感谢!
最后想说的是,不建议将Excel与Python进行对比,去研究哪个更好用。两者都是工具,Excel作为最广泛使用的数据处理工具,垄断多年,其在数据处理方面的能力无疑相当优秀。某些操作确实Python更简单,但也有不少Excel操作比Python更便捷。
例如一个很简单的操作:对各列求和并在最下一行显示,Excel只需对一列使用sum()函数,然后向左拖动即可解决;而Python则需要定义一个函数(因为Python需判断格式,若非数值型数据会直接报错)。
以上就是14个用Python实现的Excel常用操作总结的详细内容,更多关于Python Excel操作的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









