pandas中df.rename()的具体使用
本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。
2026-10-15
6

本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。
本文介绍在pandas中修改DataFrame列名的两种主要方法:直接重新赋值columns属性和使用rename方法。重点解析rename方法中inplace参数的作用,演示未使用与使用该参数时的结果差异,并展示如何指定修改特定列名。
本文详细介绍如何利用Python的Pandas库高效读写Excel文件。涵盖read_excel函数的核心参数如sheet_name、header、usecols及skiprows的使用方法,演示ExcelFile类对多Sheet的高效读取。同时讲解to_excel写入逻辑,包括自动创建文件、覆盖数据及关闭文件的注意事项,并通过ExcelWriter实现多Sheet一次写入及追加模式操作,提供完整代码示例。
本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
本文详解Python Pandas中DataFrame.apply函数的多列与多行操作技巧。重点解析axis=1对列操作与axis=0对行操作的差异,演示如何通过result_type="expand"或zip打包实现单行生成多列,以及跨行计算新数据的方法。
本文介绍如何使用Python和pandas编写命令行脚本处理Excel文件。内容包括封装logging日志模块、接收操作目录、检测并读取唯一Excel文件、自动备份、异常处理、动态添加列以及进度展示与阶段保存等实用技巧,帮助开发者高效完成数据批量处理任务。
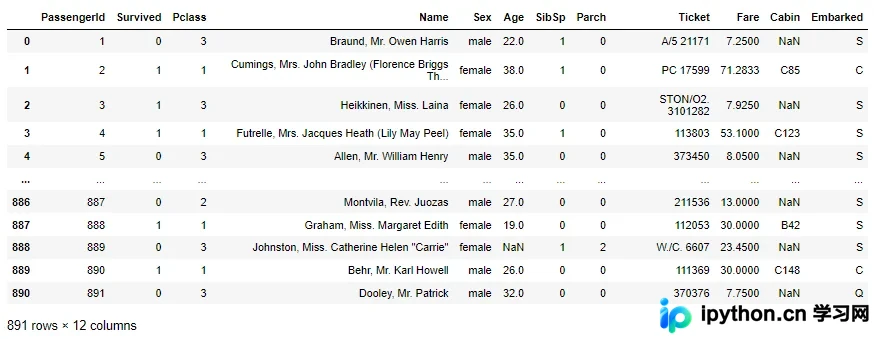
本文深入解析Pandas库中的query()方法,通过Titanic数据集演示如何替代传统的方括号索引进行更简洁的数据筛选。涵盖字符串匹配、变量引用、多条件组合、缺失值处理、索引查询及列间比较等核心用法,帮助开发者提升数据处理效率。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
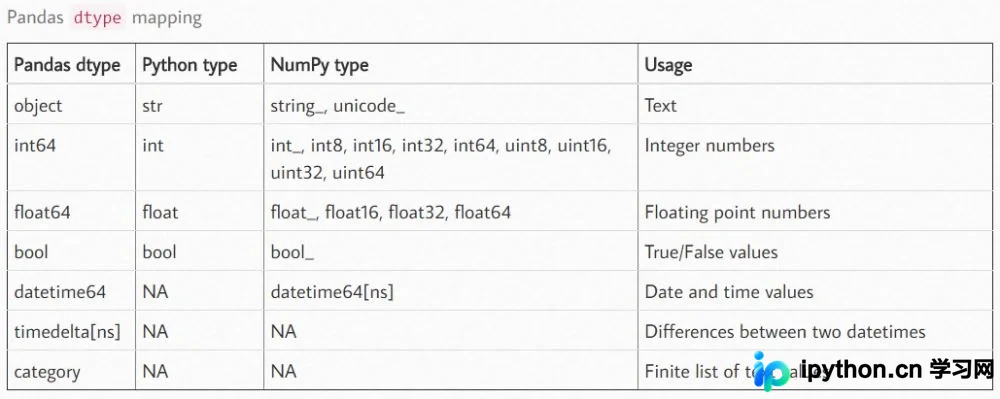
本文详细介绍Pandas中查看和转换数据类型的核心方法。通过df.dtypes、df.shape及df.info()快速获取数据框的维度、列名、非空计数及内存占用等关键信息。重点讲解df.astype()函数的多种用法,包括全局转换、指定列转换及索引类型转换,并深入解析object类型的特殊性及其清洗策略,帮助开发者高效处理数据格式问题。
本文详细介绍Pandas中df.sort_index()函数的使用方法,包括默认的升序排列及通过ascending=False实现降序排序。同时讲解df.reindex()如何自定义行和列的索引顺序,涵盖axis参数及具体代码示例,帮助开发者高效管理DataFrame数据顺序。
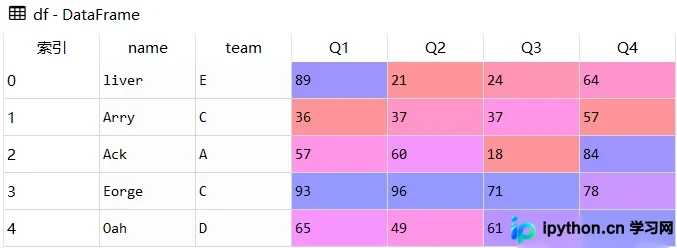
本文深入解析Pandas中sort_values()函数的核心用法,涵盖by、axis、ascending等关键参数的配置细节。通过Series与DataFrame的实例演示,展示单列、多列及混合升降序的排序技巧,并补充处理缺失值、原地修改及索引重置等高级操作,帮助开发者高效实现数据排序需求。
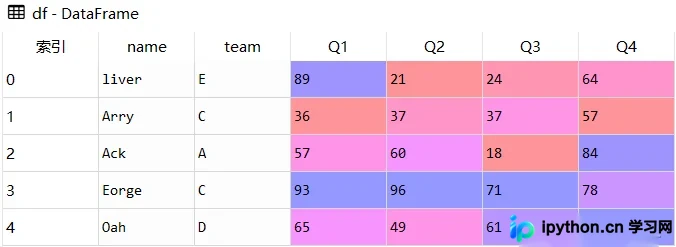
本文详细介绍Pandas库中df.dropna()函数的使用方法,涵盖axis、how、thresh、subset及inplace等核心参数的具体含义与操作示例。通过代码演示整行整列删除、条件过滤及原地修改等常见场景,帮助开发者高效处理数据中的空值。