Python Pandas Series 完全指南:创建、索引与数据处理
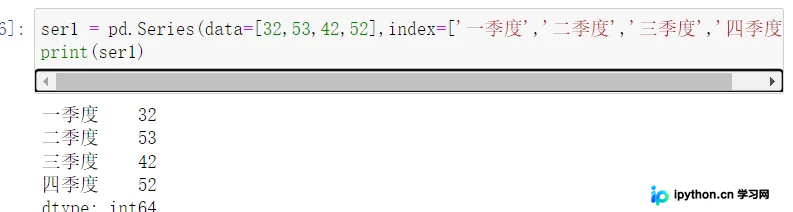
本文详细介绍 Pandas 中 Series 数据结构的创建、索引机制及常用操作方法。涵盖通过列表和字典构建 Series,掌握位置索引与标签索引的区别,演示花式索引与布尔索引技巧。同时深入解析 describe、value_counts、去重、空值处理(dropna/fillna)及排序取 Top-N 等核心函数的使用,帮助开发者高效处理一维数据。
2026-10-12
7

本文详细介绍 Pandas 中 Series 数据结构的创建、索引机制及常用操作方法。涵盖通过列表和字典构建 Series,掌握位置索引与标签索引的区别,演示花式索引与布尔索引技巧。同时深入解析 describe、value_counts、去重、空值处理(dropna/fillna)及排序取 Top-N 等核心函数的使用,帮助开发者高效处理一维数据。
本文详细讲解在 Pandas DataFrame 列中按条件筛选和查找数据的方法。通过 .where() 方法与布尔索引实现跨列条件判断、绝对值过滤及数值比对,附完整代码示例与输出结果说明,帮助开发者快速处理特征数据。
介绍在Python中如何利用pandas库和标准csv模块向CSV文件写入初始数据或安全追加新记录。涵盖核心参数配置、不同数据结构的转换方法、按行追加的正确姿势,以及追加列的通用逻辑,提供可直接运行的代码示例与注意事项。
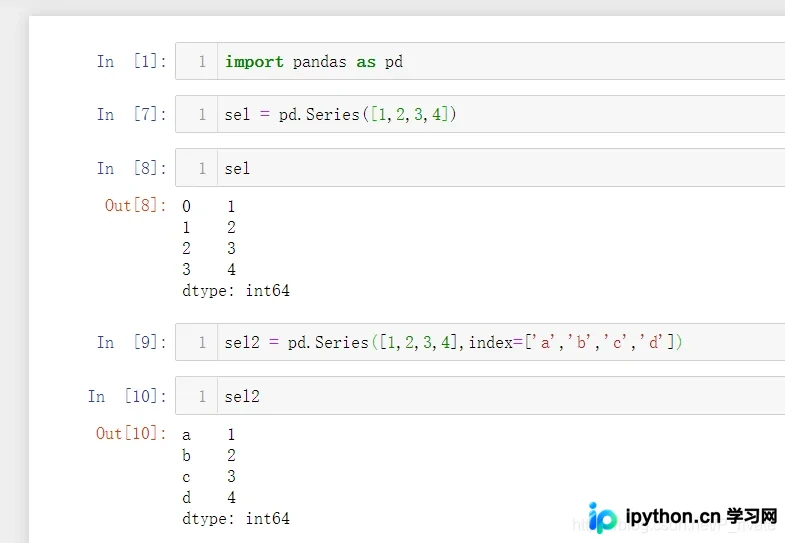
Pandas 的 Series 是用于存储一维序列的带标签数据结构,其底层由索引与值数组组成。本文通过可运行代码演示如何创建 Series、使用索引与切片访问元素、执行基础数学运算与标签对齐,并掌握 unique、value_counts 及 isin 等高效统计筛选方法,助您快速上手结构化数据的常规处理流程。
本文介绍在Python中加载数据文件的两种实用方法,分别使用内置open()函数和pandas库的read_csv()功能。通过实例演示如何读取特征和标签数据,比较结果一致性,适用于机器学习等数据密集型任务的预处理环节。
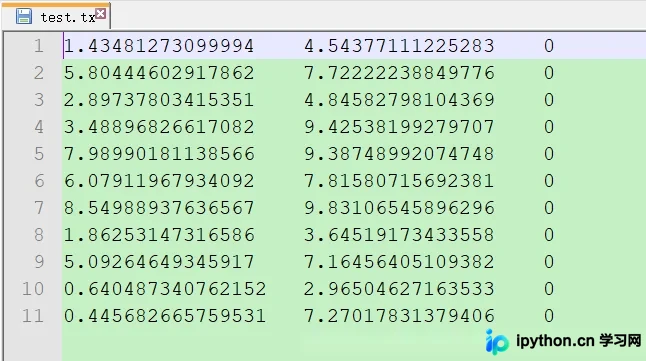
本文详细介绍使用 Python 的 pandas 库进行 CSV 与 Excel 文件的读取及保存方法,系统讲解空值筛选、行列删除、索引重置与缺失统计等核心清洗操作。通过明确关键参数设置与标准化代码示例,协助开发者高效完成数据预处理与质量校验流程,确保分析基础稳定可靠。
本文详解pandas中处理重复数据的两个核心方法:duplicated()与drop_duplicates()。通过DataFrame、Series及Index三种对象的示例,解析subset与keep参数的具体行为,并演示如何根据品牌或全部列识别重复项,以及如何直接删除重复数据以完成数据清洗。
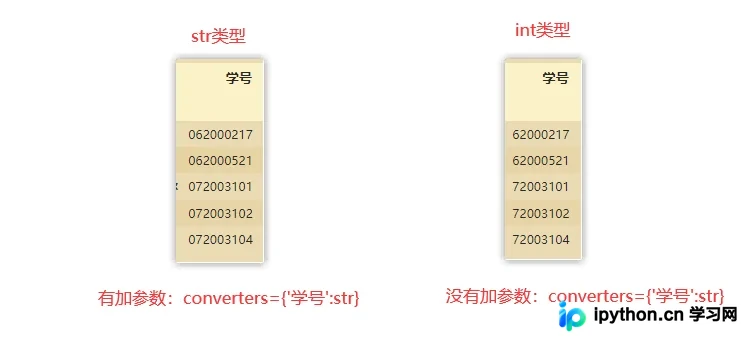
本文详解pandas读取Excel时的常见陷阱,重点解析converters参数用于强制类型转换(如学号转字符串)以解决空值问题,以及usecols参数的三种用法:列表指定列名、numpy切片区间及字母范围切片。强调sheet_name需显式指定,提供完整代码示例与注意事项。
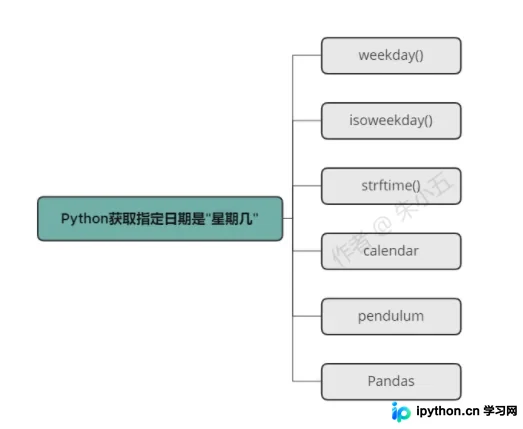
本文详细演示了在Python中获取指定日期对应星期几的6种常用方法,涵盖内置的datetime与calendar模块、第三方库pendulum以及数据分析工具pandas。通过返回数值索引、中英文字符串及批量列计算,帮助开发者快速解决日期分组汇总与周期分析中的格式化问题。
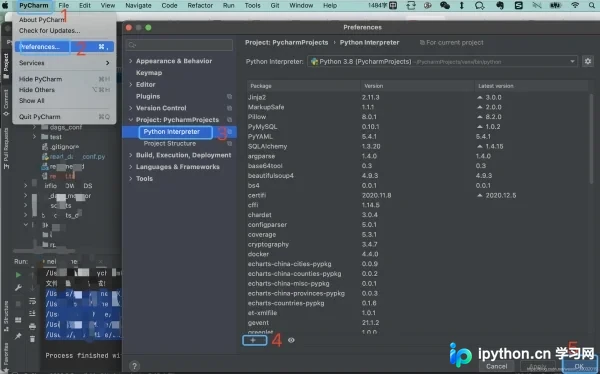
本文系统介绍Python数据分析生态中的七个核心库,涵盖NumPy、SciPy、Pandas、Scikit-learn及Matplotlib等可视化工具。详细解析各库功能特性,并提供Anaconda发行版、pip命令及PyCharm环境下的多种安装指南,最后通过NumPy的vdot函数示例展示基础应用,助力开发者快速构建数据处理工作流。
本文系统梳理了 Python Pandas 库中最常用的数据处理函数与方法,涵盖数据读写、统计展示、增删改及特殊操作四大类。通过提供详细的函数列表与可直接运行的代码示例,帮助开发者快速定位所需功能,解决记忆模糊或查找效率低的问题,提升数据处理效率。
本文基于公交IC卡刷卡数据集,演示使用Python进行数据分析的完整流程。涵盖数据导入、时间格式转换、早晚高峰刷卡量统计、各小时刷卡趋势折线图绘制、乘客搭乘时间函数构建、交易类型占比饼图生成,以及线路、司机与车辆信息的分类存储与高频服务者分析。