

如何在 Pandas DataFrame 列中进行条件筛选与数据查找

本文详细讲解在 Pandas DataFrame 列中按条件筛选和查找数据的方法。通过 .where() 方法与布尔索引实现跨列条件判断、绝对值过滤及数值比对,附完整代码示例与输出结果说明,帮助开发者快速处理特征数据。
在 Pandas DataFrame 列中进行条件筛选的常用方法
在数据处理或机器学习特征工程中,经常需要根据特定规则提取目标行或替换不匹配的数据。Pandas 提供了高效的向量化操作,无需循环即可快速完成列值搜索与过滤。
方法一:利用 .where() 按条件保留或替换数据
第1步:导入依赖与准备测试集
目的为建立可执行的数据操作环境。在终端或脚本入口处运行导入命令后,程序成功加载 pandas 模块即为完成状态。
import pandas as pd第2步:构造结构化数据框架
目的为提供包含多特征的原始样本。通过字典传入 pd.DataFrame() 创建表,完成后可通过 print 验证行列维度。参数需严格对应列名,完成状态为终端输出完整的初始数据表。
raw_data = {'first_name': ['Sheldon', 'Raj', 'Leonard', 'Howard', 'Amy'],
            'last_name': ['Copper', 'Koothrappali', 'Hofstadter', 'Wolowitz', 'Fowler'],
            'age': [42, 38, 36, 41, 35],
            'Comedy_Score': [9, 7, 8, 8, 5],
            'Rating_Score': [25, 25, 49, 62, 70]}
df = pd.DataFrame(raw_data, columns=['first_name', 'last_name', 'age',
                                     'Comedy_Score', 'Rating_Score'])
print(df)
第3步:配置跨列条件并执行过滤
目的为基于其他特征的值动态决定当前列的输出。在 df['目标列'].where(条件表达式) 入口中使用,核心动作为传入布尔型条件参数。当条件为真时保留原值,为假时自动替换为 NaN,可观察的完成状态是返回与原索引对齐的 Series。
result = df['Comedy_Score'].where(df['Rating_Score'] < 50)
print(result)
第4步:核对输出结构状态
执行后终端将显示带索引的浮点型序列。满足 Rating_Score < 50 的前三行返回原始喜剧评分,最后两行因条件未命中显示为 NaN。该特性适用于需要保持原数据长度以进行后续对齐或掩码生成的场景。
方法二:使用布尔索引直接过滤整行数据
第1步:初始化二维数据表
目的为构建用于范围验证的基准矩阵。通过列表嵌套传入 pd.DataFrame(),完成状态为表结构稳定且列属性明确。
import pandas as pd
data = [[1,2],[2,3],[3,4],[-3,4],[-2,3]]
column = ['a','b']
df = pd.DataFrame(data, columns=column)
第2步:编写复合条件并应用掩码
目的为精准剔除不符合业务阈值的数据。入口为方括号内放置条件表达式,动作为调用内置函数 abs() 配合比较运算符 > 生成布尔向量。参数需指向具体列名,完成状态是返回仅含合规行的子集 Dataframe。
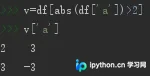
v = df[abs(df['a']) > 2]
print(v['a'])
第3步:验证截断结果
系统仅投影符合条件的目标列数据。实际运行后终端输出如下,数值绝对值均大于 2,可直接用于后续建模或统计:
操作要点回顾
- 区分场景:需保留原表结构且标记不达标项时用
.where();需彻底丢弃无关行时用布尔索引df[cond]。 - 性能注意:条件表达式应作用于单列或向量,避免在大型数据集上使用 Python 原生循环逐行判断。
- 类型安全:
.where()可能改变列的数据类型,后续计算前建议使用astype()校验并确保数值精度。
以上就是在 Pandas DataFrame 列中进行条件筛选与数据查找的详细内容,更多关于 Python 数据处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









