

Pandas Series 结构详解与常用操作指南

Pandas 的 Series 是用于存储一维序列的带标签数据结构,其底层由索引与值数组组成。本文通过可运行代码演示如何创建 Series、使用索引与切片访问元素、执行基础数学运算与标签对齐,并掌握 unique、value_counts 及 isin 等高效统计筛选方法,助您快速上手结构化数据的常规处理流程。
Series 核心结构原理
在 Pandas 生态中,DataFrame 负责二维表格,而 Series 则是构建一切复杂分析的基础一维对象。它内部维护两个关联数组:左侧为自定义或默认的索引标签(index),右侧为对应的数据值(values)。这种设计使得后续的所有计算、筛选和聚合都能基于明确的标签定位,避免传统 NumPy 纯位置索引容易引发的错位问题。
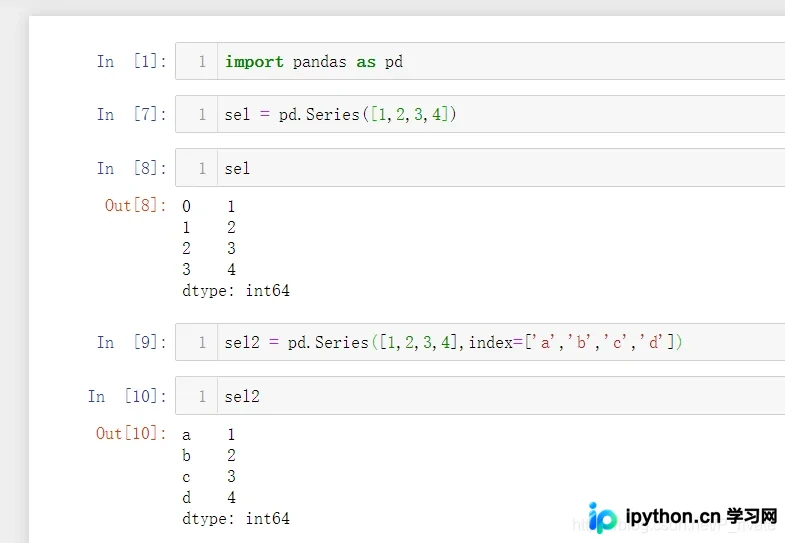
第1步:初始化与属性查看
可通过列表、字典或标量创建 Series。若省略 index 参数,默认生成从 0 开始的 RangeIndex。创建后,利用 .values 获取底层数组,.index 获取标签索引,便于核对数据结构是否符合预期。
import pandas as pd

# 使用列表创建,默认索引为 0, 1, 2...
s_list = pd.Series([1600, 12, 1])

# 使用字典创建,键自动转为索引
s_dict = pd.Series({'A': 1600, 'B': 12, 'C': 1})

print(s_list.index)
print(s_dict.values)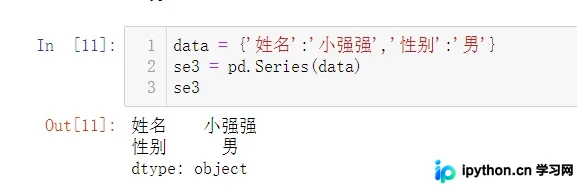
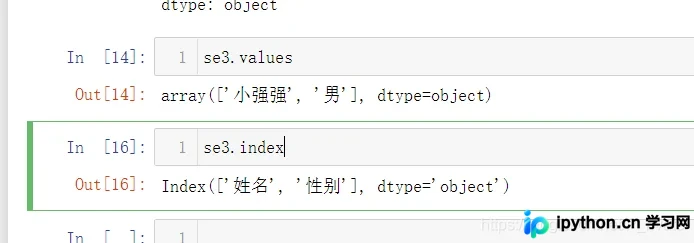
第2步:元素选取与直接赋值
Series 支持整数位置索引、标签索引、布尔掩码切片以及多标签列表查询。赋值操作遵循标准容器语法,可直接覆盖指定位置的值。
# 位置索引与切片
val_0 = s_list[0]
sub_set = s_list[1:3]

# 标签索引与批量选择
val_B = s_dict['B']
subset_labels = s_dict[['A', 'C']]

# 直接赋值修改
s_list[0] = 2000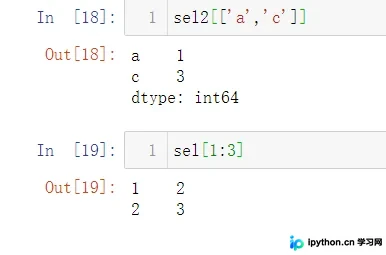
第3步:数学运算与标签对齐机制
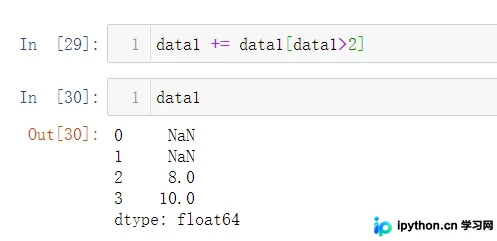
Pandas 继承了 NumPy 的向量化计算能力,支持加、减、乘、除及常用数学函数。当两个 Series 进行运算时,Pandas 会依据 index 标签自动对齐缺失项并填充 NaN,这一特性在处理时间序列或异构数据集时极为关键。
s1 = pd.Series([10, 20, 30], index=['x', 'y', 'z'])
s2 = pd.Series([5, 15, 25], index=['y', 'z', 'w'])

# 标签对齐相加,未匹配的索引结果为 NaN
result = s1 + s2
print(result)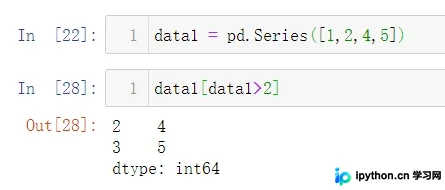
第4步:数据统计与成员验证
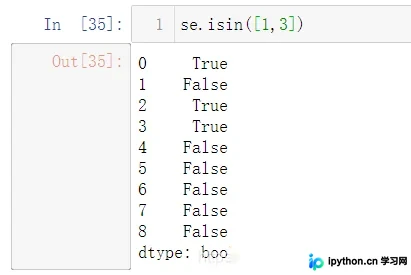
日常清洗中常需去重、统计频次或验证集合归属。Pandas 提供了内置的高效方法,避免手动编写循环过滤逻辑。
s = pd.Series(['apple', 'banana', 'apple', 'cherry'])

# 去重获取唯一值
unique_vals = s.unique()

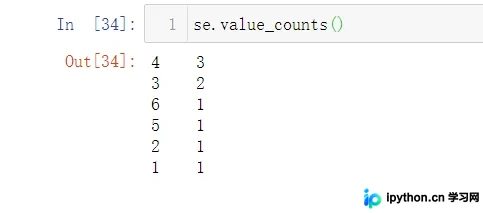
# 统计各元素出现次数(降序排列)
counts = s.value_counts()

# 验证特定值是否存在于序列中
mask = s.isin(['apple', 'fig'])
filtered = s[mask]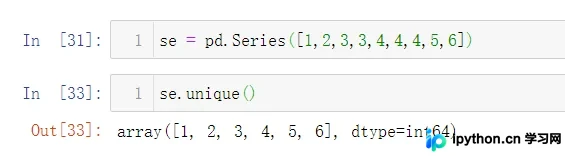
总结
Series 凭借灵活的索引结构与向量化运算规则,大幅降低了数据预处理阶段的编码成本。掌握其创建方式、标签对齐逻辑以及常用统计函数后,可平滑衔接至 DataFrame 的多表合并与透视分析。以上就是 Pandas Series 结构及常用操作实例的详细内容,更多关于 Pandas 数据处理进阶技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









