

Pandas数据清洗实战:缺失值、重复值与异常值
以一份典型业务数据为例,按照“数据概览→缺失值处理→重复值处理→异常值识别与处理→结果验证”的流程,系统讲清 Pandas 数据清洗中最常见的问题、核心操作与容易踩坑的地方。重点覆盖 isna()/isnull()、dropna()/fillna()、duplicated()/drop_duplicates(),以及基于统计规则识别异常值,并强调清洗前后数据量与关键指标的验证。
2026-09-15
11

以一份典型业务数据为例,按照“数据概览→缺失值处理→重复值处理→异常值识别与处理→结果验证”的流程,系统讲清 Pandas 数据清洗中最常见的问题、核心操作与容易踩坑的地方。重点覆盖 isna()/isnull()、dropna()/fillna()、duplicated()/drop_duplicates(),以及基于统计规则识别异常值,并强调清洗前后数据量与关键指标的验证。
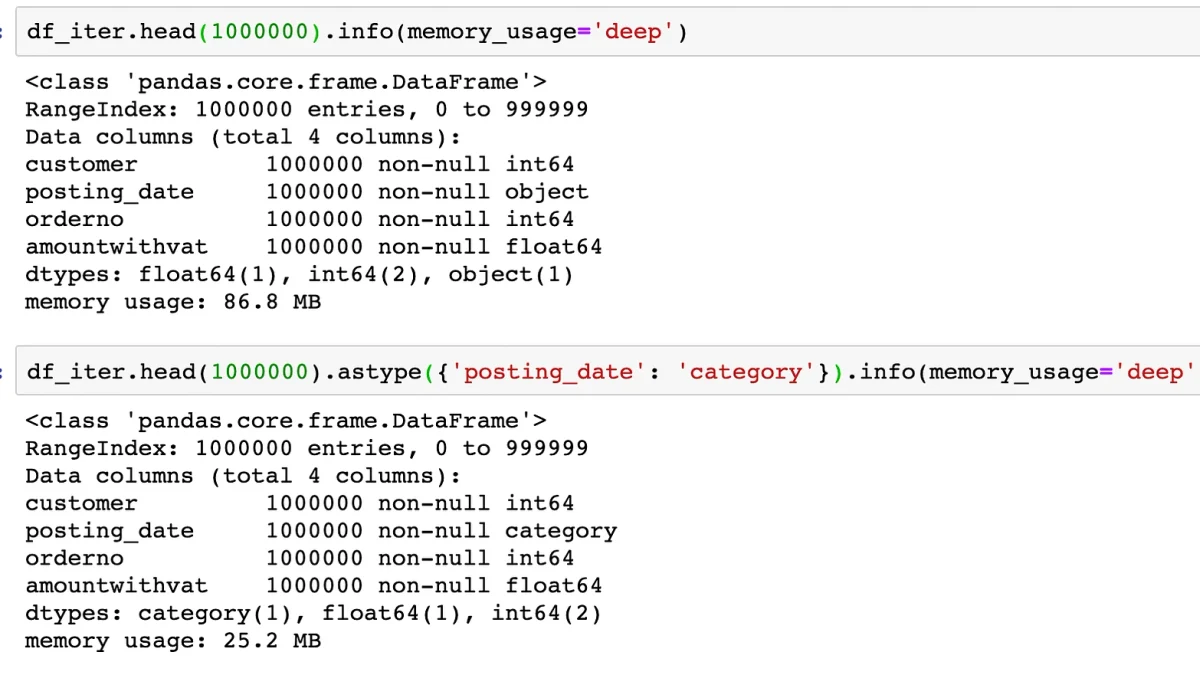
系统介绍 Pandas 处理大规模数据时的内存占用分析、数据类型优化、分块读取与结果验证,帮助读者降低峰值内存并避免常见的数据类型和处理陷阱。
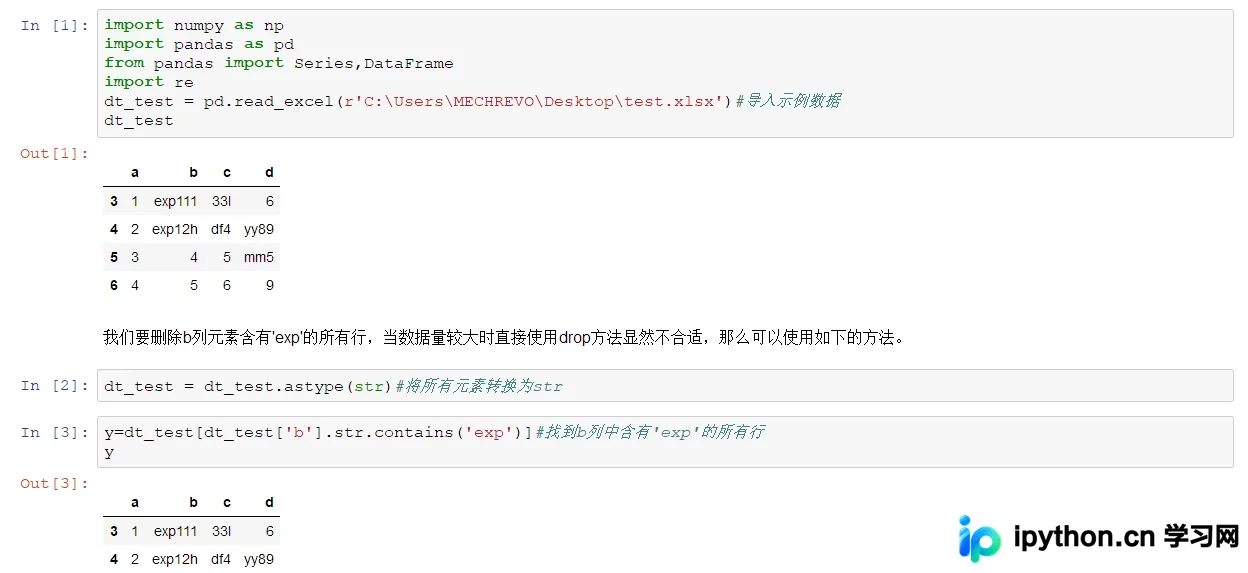
本文详解在pandas DataFrame中如何高效筛选和删除指定行。通过isin()方法传入列表或字典可实现精确匹配,同时介绍针对包含特定字符串行的处理技巧,帮助开发者快速完成数据清洗与过滤操作。
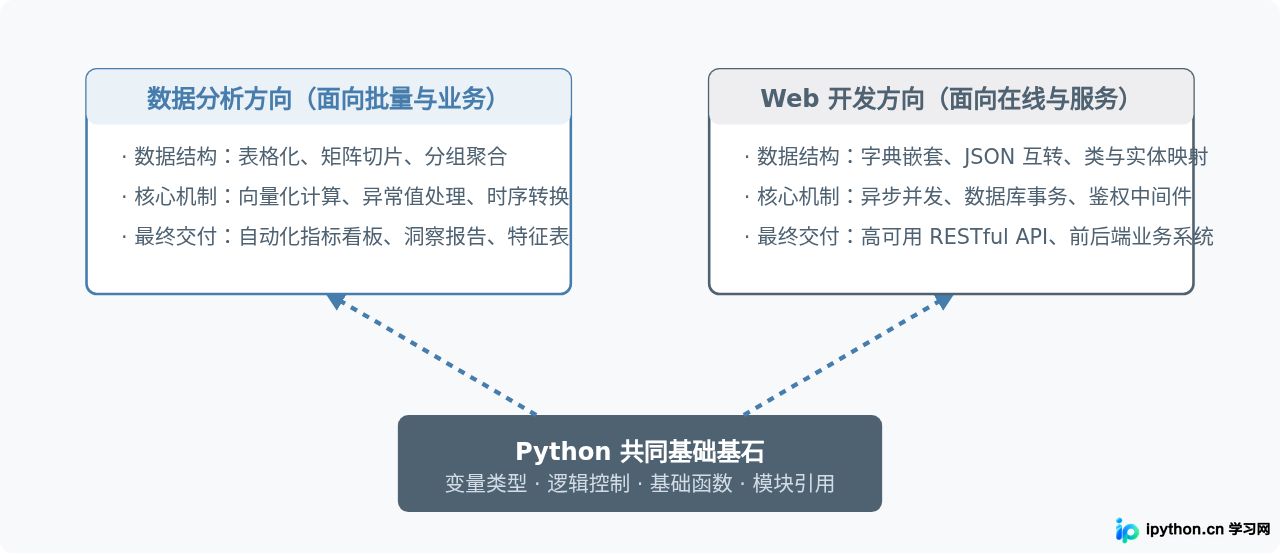
对比零基础转行数据分析与Web开发两个不同方向时,Python基础语法的取舍、核心第三方库、数据结构侧重以及学习落地路径的具体差异。
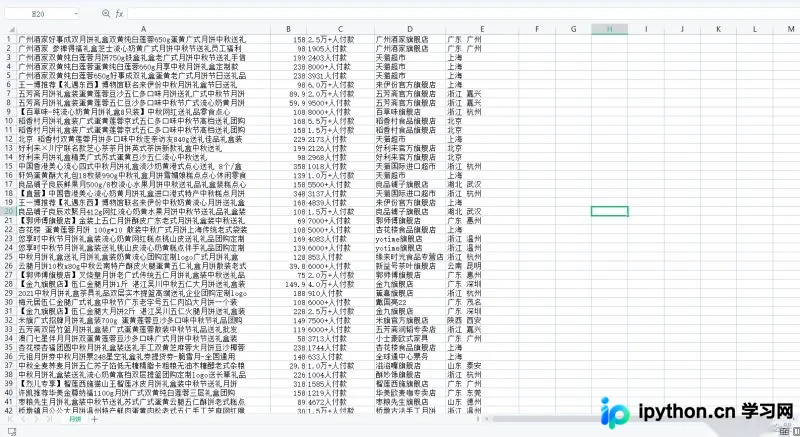
本文介绍如何使用Python对月饼电商数据进行清洗与可视化分析。通过Pandas处理价格、销量及店铺信息,利用Pyecharts生成销量Top10店铺与商品柱状图、不同价格区间销量占比饼图以及各省销量分布地图,帮助直观了解市场趋势与热门产品。
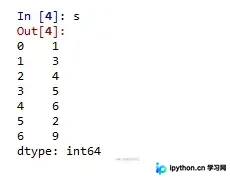
本文详细介绍Python中Pandas库的核心数据结构Series和DataFrame。通过具体代码示例,演示如何利用标量、字典、Ndarray等数据源创建Series,以及如何基于字典、Series和二维数组构建DataFrame,帮助开发者快速掌握Pandas基础操作。
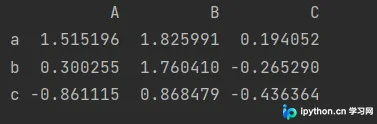
本文介绍了在 Python 的 Pandas 库中为 DataFrame 添加列名的两种常用方法。第一种是在创建 DataFrame 时通过 columns 参数直接指定;第二种是先创建无列名的 DataFrame,再使用 columns 属性进行赋值。文章提供了具体的代码示例和运行结果,帮助开发者快速掌握相关操作技巧。
本文详细介绍如何使用Python的pandas库通过pd.read_csv()方法读取CSV文件。内容涵盖基础读取、去除表头、自定义列名、设置索引以及指定分隔符等关键参数用法,并展示如何处理缺失数据,帮助开发者高效处理标准化数据。
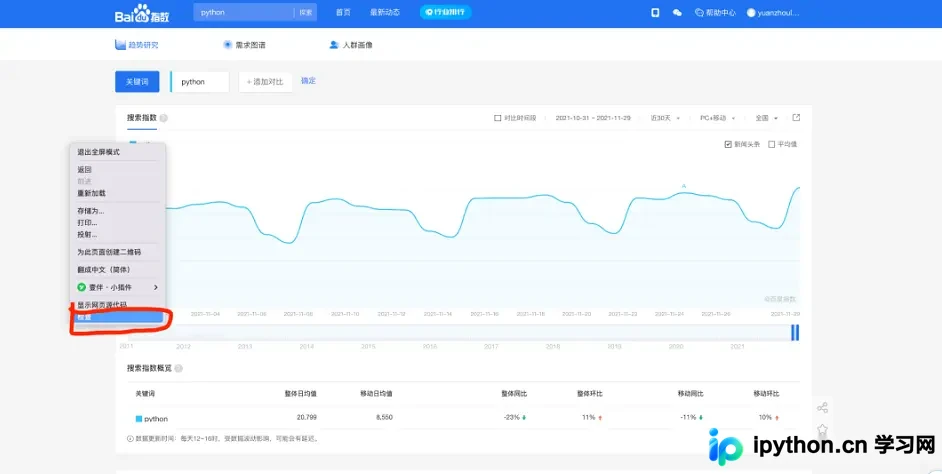
本文介绍如何使用Python脚本获取百度指数数据。通过提取登录Cookie,利用自定义类解析API返回的加密数据,生成Pandas DataFrame。文章包含获取Cookie的步骤、核心代码示例、数据保存为CSV的方法,以及使用Plotly进行时间序列可视化的完整流程,帮助开发者便捷地获取并分析关键词热度趋势。
本文详细介绍在Python数据分析中,如何利用Pandas库对DataFrame高效应用自定义函数。重点解析apply方法按行或列处理数据、applymap方法逐元素处理数据,以及map方法在Series中的应用,通过具体代码示例展示如何替代低效的for循环,提升数据处理效率。
本文介绍在Python中使用pandas读取CSV文件时,如何处理缺失表头或需要自定义列名的情况。通过header=None参数配合columns属性或names参数,可在读取时直接定义列名。同时提供批量修改已有CSV文件表头的代码示例,帮助开发者避免数据解析错误。
本文介绍在Pandas DataFrame计算中产生inf(无穷大)值的原因及处理方法。通过Numpy库提供的isinf、isposinf等函数定位inf位置,并演示如何将Series或整个DataFrame中的正负无穷大替换为指定数值或NaN,以适配机器学习算法对数据完整性的要求。