

Python数据分析:Pandas DataFrame高效应用自定义函数详解

发布时间:2026-10-16| 9人浏览过
本文详细介绍在Python数据分析中,如何利用Pandas库对DataFrame高效应用自定义函数。重点解析apply方法按行或列处理数据、applymap方法逐元素处理数据,以及map方法在Series中的应用,通过具体代码示例展示如何替代低效的for循环,提升数据处理效率。
前言
在数据分析过程中,经常需要针对数据集应用自定义函数或其他第三方库的函数,以获取期望的结果。面对这一需求,许多开发者首先想到的是使用for循环遍历DataFrame对象,提取特定行或列的数据后再调用自定义函数。虽然这种方法可行,但执行效率较低。本文将介绍如何在Pandas中更高效地对数据集应用自定义函数。
应用函数
apply 方法
apply()函数可将自定义函数应用于某一行或几行,以及某一列或多列中的每个元素。其基本使用格式如下:
df.apply(func, axis=0, *args, **kwargs)主要参数说明如下:
- func:指定要应用的函数。
- axis:指定操作轴,默认为0,表示作用于列;若设置为1,则表示作用于行。
- *args和**kwargs:用于接收任意数量和类型的额外参数,这些参数将被传递给func函数。
以下面DataFrame为例进行操作:
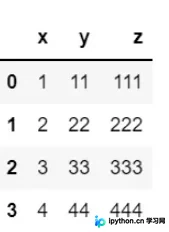
定义一个“返回最大值”的自定义函数,并将其应用于该DataFrame:
def func(x):
    return x.max()
df.apply(func)
运行结果如下:
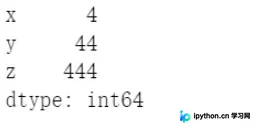
从结果可见,返回了每列的最大值。若希望返回每行的最大值,只需设置axis=1即可。
此外,apply()也支持传递lambda匿名函数。
applymap 方法
applymap()函数可以作用于DataFrame中的每一个元素,例如用于转换DataFrame中数据的格式:
df.applymap(lambda x: '%.2f' % x)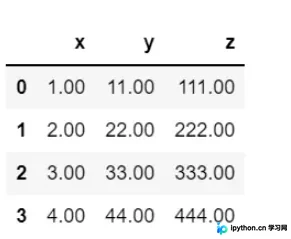
注意:Pandas还提供了一个map()方法,专门作用于Series对象。此类方法与Python原生的map()方法功能类似。
至此,关于Python数据分析中Pandas DataFrame应用自定义函数的介绍已完成。如需了解更多相关内容,可搜索本站过往文章或继续浏览相关文章。感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









