使用pandas to_sql将DataFrame高效存入数据库
本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
2026-10-13
6

本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
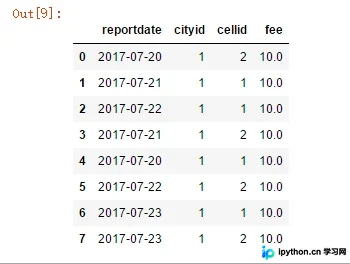
本文详细解析Pandas库中resample方法的使用。涵盖降采样与升采样的具体操作,包括频率调整、区间闭合规则(closed)、标签设置(label)以及NaN值填充策略(pad/bfill)。通过Series示例展示如何应用自定义函数,帮助开发者掌握时间序列数据的高效处理技巧。
本文详解 pandas DataFrame 的行列索引创建与值提取方法。通过 index 和 columns 参数自定义索引,演示如何获取单列、单行及特定单元格数值。结合车站客流数据实例,展示利用 iloc 和 loc 进行数据筛选与统计计算,如查找最大客流车站及其日均值对比。
本文深入解析Pandas中分组聚合的核心机制,详细对比apply、applymap、map及agg函数的适用场景与性能差异。通过groupby对象的工作原理,结合代码示例展示如何高效进行数据分组、统计分析及多维度聚合操作,帮助开发者优化数据处理流程。
本文详解如何在 Python Pandas 中高效获取满足特定条件的行索引。对比了低效的迭代方式,重点介绍了使用布尔索引直接获取 index 列表的方法,并深入解析了 iloc(位置索引)与 loc(标签索引)的区别。同时提供了利用 np.flatnonzero 获取序数索引的技巧,帮助开发者避免常见的索引混淆错误。
本文介绍如何使用Python的Pandas库生成指定范围内的日期列表。通过pd.date_range函数,可以灵活设置起始与结束日期,并自定义频率参数(如天、月等)。示例展示了如何将日期对象转换为字符串格式,适用于数据分析和时间序列处理场景。
本文详细解析NumPy和Pandas中数组的合并、拉直与重塑操作。通过concatenate和pandas.concat实现垂直或水平合并,利用ravel进行行优先(C顺序)或列优先(Fortran顺序)的拉直,并结合reshape探讨不同内存顺序下的重塑效果,提供完整代码示例与结果分析。
本文介绍Python中Pandas与NumPy数组的相互转换及DataFrame连接方法。通过np.array()将Pandas对象转为数组,利用pd.DataFrame()将数组转为DataFrame,并使用pd.concat进行左右拼接。掌握这些基础操作有助于高效处理数据。
本文深入探讨Pandas Series与Numpy Array在功能实现上的高度一致性。两者均支持通过中括号进行元素索引与切片操作,具备相同的遍历语法,并内置求最大最小值等统计函数。此外,Series支持向量运算,且底层基于C语言实现,运算效率显著优于原生Python列表。
本文深入解析Pandas中Series和DataFrame的索引机制,涵盖基于下标与关键字的索引方式、整数索引的特殊处理、布尔Series过滤及Index对象应用。重点对比loc与iloc的行为差异,通过代码示例展示列索引、行切片及布尔筛选的具体操作,帮助开发者掌握高效的数据访问技巧。
本文总结了Python自动化测试中处理Excel文件的三种常用方法:openpyxl、xlrd及pandas。文章详细对比了各库的安装方式、读写特性及局限性,重点提供了针对多Sheet操作Bug修复的openpyxl封装代码,以及xlrd配合xlutils处理.xls文件的读写方案,并简要展示了pandas在数据读取中的应用,旨在为测试人员提供可直接复用的工具类代码。
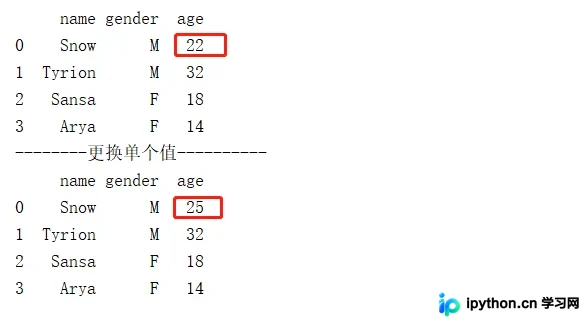
本文介绍如何使用Pandas库修改DataFrame中的特定值,包括使用loc、iloc、at和iat方法。同时详细讲解如何在DataFrame末尾或指定位置新增列,以及如何通过append方法添加新行,提供完整代码示例和注意事项。