

MySQL内部临时表:何时产生及使用场景解析
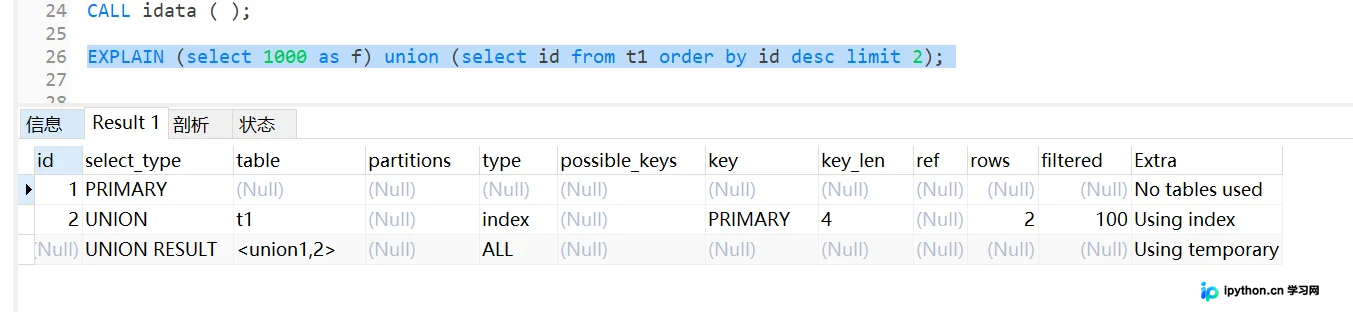
MySQL在特定SQL操作下会创建内部临时表以辅助计算。本文通过具体示例分析两种常见场景:UNION进行结果集去重时,内存临时表存储中间结果并约束主键实现去重;GROUP BY分组聚合时,临时表暂存分组键与计数值,完成后需Filesort排序。当数据量超过tmp_table_size(默认16MB)限制时,临时表将转化为磁盘InnoDB表,影响性能。理解其执行流程有助于优化查询语句。
2026-10-16
8

MySQL在特定SQL操作下会创建内部临时表以辅助计算。本文通过具体示例分析两种常见场景:UNION进行结果集去重时,内存临时表存储中间结果并约束主键实现去重;GROUP BY分组聚合时,临时表暂存分组键与计数值,完成后需Filesort排序。当数据量超过tmp_table_size(默认16MB)限制时,临时表将转化为磁盘InnoDB表,影响性能。理解其执行流程有助于优化查询语句。
本文深入解析 MySQL 中用于 SQL 高级过滤的 LIKE 通配符,详细演示 %(匹配任意字符)与 _(匹配单个字符)的实际应用案例。针对以星号开头导致的搜索缓慢问题,提供具体优化建议,同时强调尾空格干扰及 NULL 值处理的注意事项,帮助开发者实现高效且准确的模糊查询。
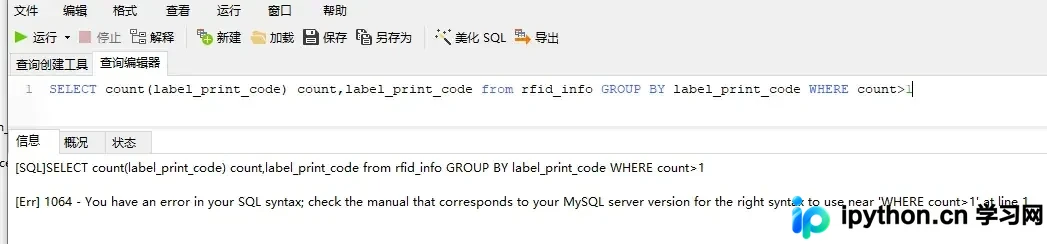
在生产环境中遇到数据重复(如标签重复)时,可利用MySQL的GROUP BY和HAVING语句快速定位问题。本文通过实际案例,演示如何编写SQL查询提取重复记录,结合临时表进行数量统计与频次占比分析,并详细解析WHERE与HAVING的区别,帮助开发者高效排查数据库异常。
本文深入解析MySQL分库分表的三种核心策略:RANGE范围划分、HASH取模及一致性Hash算法。通过对比各方法的优劣,重点阐述一致性Hash配合虚拟节点如何解决数据倾斜与扩容难题,并提供Java单元测试代码验证路由逻辑,助力高并发场景下的数据库架构设计。
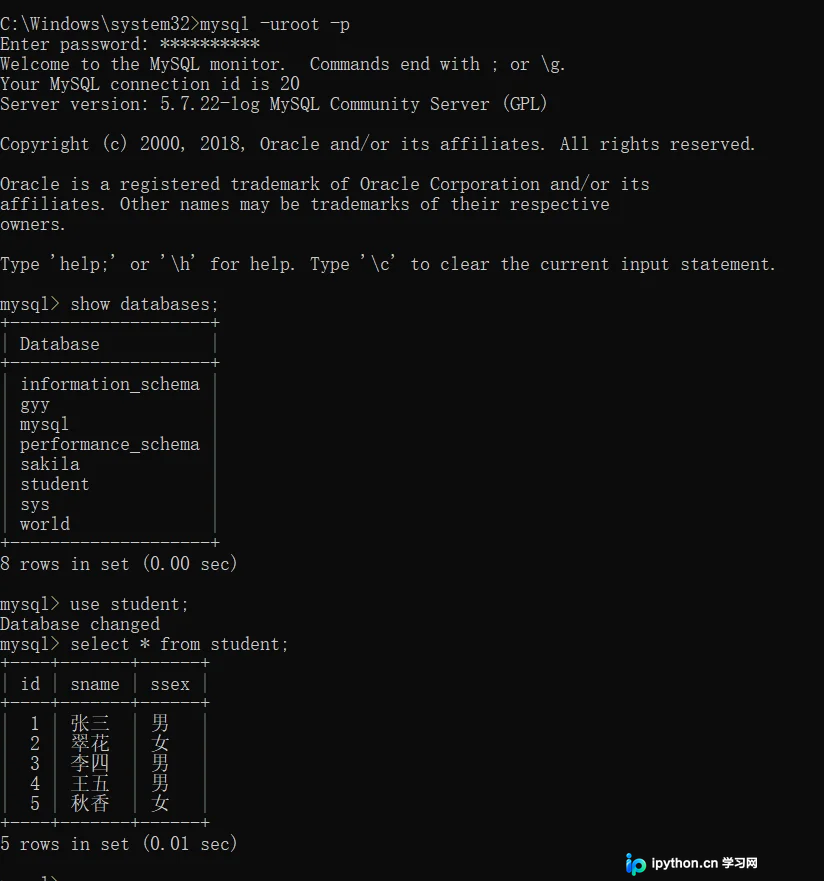
本文详细讲解MySQL数据库的备份与还原方法。首先介绍mysqldump工具的使用,通过命令行将指定数据库导出为SQL文件;随后演示如何删除库并新建同名库,利用source命令在MySQL客户端内完成数据导入,确保业务数据的安全性与可恢复性。
本文解决如何在MySQL中筛选“进行中”状态的数据,核心在于处理开始或结束时间可能为空的情况。通过 `IS NULL` 结合 `NOW()` 函数,实现四种时间边界条件的统一查询。同时提供MyBatis动态SQL的XML配置示例,确保参数灵活传入时逻辑依然准确。
本文介绍如何仅凭借 .frm 文件恢复 MySQL 数据表的定义结构。针对 InnoDB 引擎,通过在同名数据库重建空表并覆盖 .frm 文件实现;针对 MyISAM 引擎,则需建立 .MYI/.MYD 占位文件后执行 REPAIR TABLE ... USE_FRM 命令。该方法适用于备份丢失但保留基础文件时的紧急恢复场景。
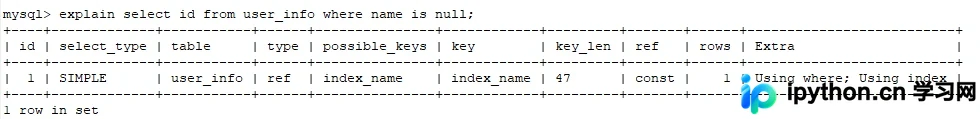
许多开发者误以为 MySQL 中 WHERE name IS NULL 会导致索引失效,实则不然。本文通过 innodb_ruby 工具与二进制文件分析,揭示 NULL 值在 B+ 树中的存储位置;并通过案例复现证明,所谓“索引失效”通常是由于条件匹配行数过多(如 >20%)导致回表成本高于全表扫描,由 Optimizer 主动放弃索引所致。
本文介绍如何利用Python的PyMySQL库将字典类型数据保存至MySQL数据库。通过封装类实现自动检测表是否存在,若不存在则根据字典键值自动创建表及对应列,并支持写入多条不同结构的字典数据,简化数据库交互流程。
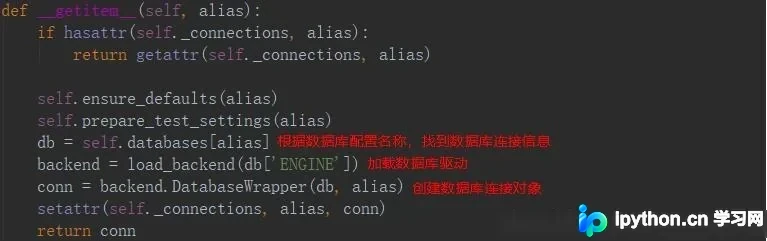
本文介绍在Django中执行原始SQL并返回字典类型数据的两种方法。第一种通过手动遍历游标结果构建字典,适用于简单场景;第二种通过继承重写mysql驱动中的create_cursor和is_sql_auto_is_null_enabled方法,实现全局自动返回字典,解决元组嵌套带来的处理麻烦,提升查询效率与代码可读性。
本文介绍如何利用Python将MySQL数据库中的数据转换为JSON格式,以简化第三方推送平台的数据录入工作。通过实例代码展示连接数据库、查询数据、处理字典结构及生成JSON文件的全过程,帮助开发者高效完成数据格式转换任务。
本文介绍了一个基于Python和mysqldump命令的MySQL数据库自动备份脚本,适用于Windows环境。脚本通过调用系统CMD执行备份指令,支持指定数据库名、用户、密码及编码格式,并将备份文件保存至指定目录。