

MySQL排查重复数据实战:从查询到统计汇总

在生产环境中遇到数据重复(如标签重复)时,可利用MySQL的GROUP BY和HAVING语句快速定位问题。本文通过实际案例,演示如何编写SQL查询提取重复记录,结合临时表进行数量统计与频次占比分析,并详细解析WHERE与HAVING的区别,帮助开发者高效排查数据库异常。
排查思路与初步查询
在处理生产环境的数据异常时,首要任务是准确锁定问题范围。当客户反馈存在“同一个标签出现在多个物料上”的现象时,我们需要在数据库中找出所有出现次数大于1的标签记录。
这一需求的核心在于聚合数据并进行过滤。首先,我们使用 GROUP BY 对标签进行分组,并利用 COUNT() 函数统计每个标签出现的频次。为了在查询结果中直接筛选出重复项,必须使用 HAVING 子句配合 COUNT(> 1) 进行过滤。
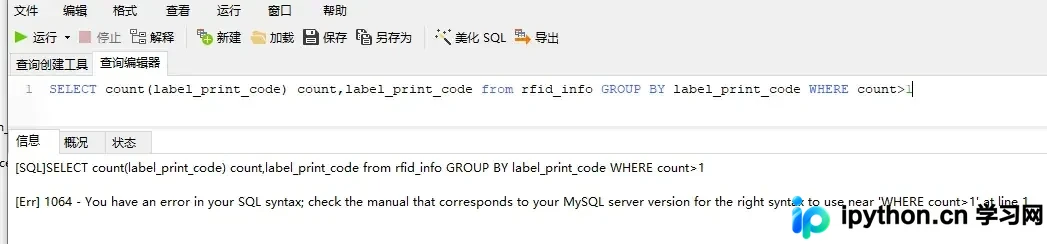
注:在初次编写类似逻辑时,需注意SQL语法的规范性,确保聚合函数的使用位置正确。如果语法报错,应及时检查是放在了WHERE还是HAVING之后。
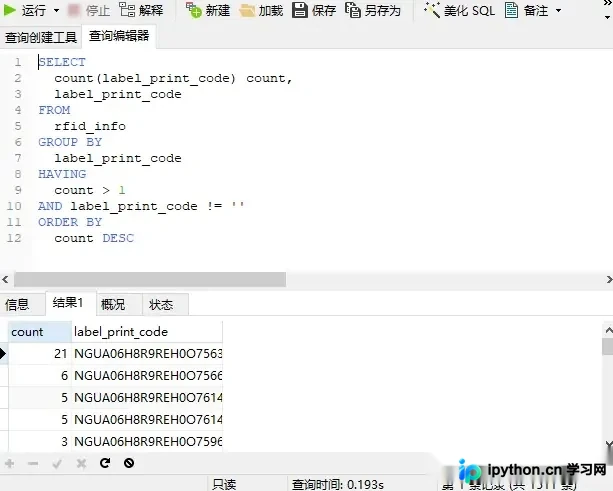
执行正确的查询后,发现重复的标签多达 1500 多条。面对如此庞大的数据量,除了修复代码逻辑外,还需要将这些问题数据导出供业务方追溯产品来源。在现代数据库管理工具(如 Navicat)中,通常支持直接复制查询结果,便于快速交接给业务部门。
第1步:获取重复记录总数
为了量化问题的严重程度,需要将上述查询得到的重复标签列表视为一个临时表,并对该集合的行数进行求和计算。
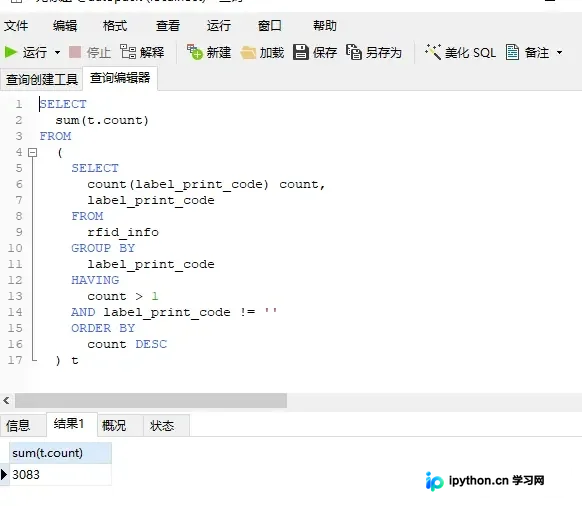
通过 SUM() 或进一步的 COUNT() 操作,可以快速得出具体有多少条受影响的记录。这一步骤能直观地向管理层或客户展示问题规模,为后续的重试或批量修正提供数据支撑。
第2步:分析重复次数的占比分布
仅知道总数还不够,了解数据重复的规律有助于推断问题产生的原因。我们可以对上一步的结果再次进行分组统计,查看不同重复频次(如重复2次、3次等)的记录各有多少。
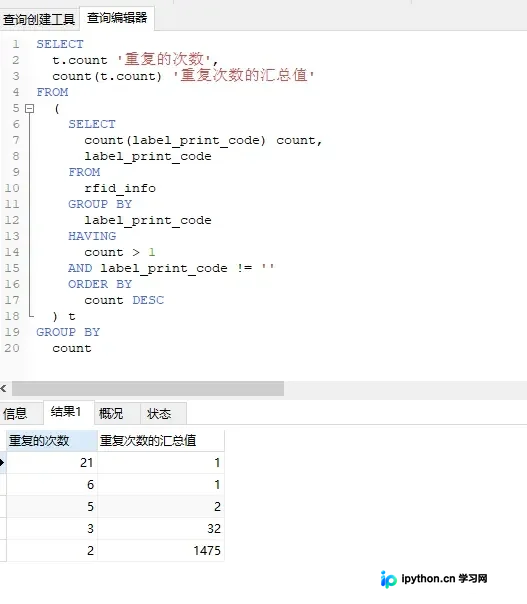
分析结果显示,绝大部分问题数据的重复次数为 2 次。这种分布特征可能暗示了特定的系统行为模式(例如某次操作触发了两次写入),为进一步的代码审计提供了方向。
核心原理:WHERE 与 HAVING 的区别
在排查上述重复数据的过程中,正确使用 WHERE 和 HAVING 是成功的关键。两者虽然都是用于过滤数据,但作用阶段和限制条件截然不同。
- WHERE(约束声明):在数据库返回结果集之前生效。它直接作用于原始表的行,因此只能在 WHERE 后面使用普通列条件,不能使用聚合函数(如
COUNT,SUM)。 - HAVING(过滤声明):在数据库返回结果集之后生效。它主要作用于
GROUP BY分组后的结果,因此可以在 HAVING 后面使用聚合函数进行条件判断。
简单来说,如果你需要对单行数据进行筛选,使用 WHERE;如果你需要对分组后的统计结果(如“重复次数大于1”)进行筛选,必须使用 HAVING。
总结
在日常的 MySQL 开发中,多表联查以及利用子查询或临时表进行多次筛选是非常常见的操作。当涉及数据合并、分组和统计汇总时,往往会产生新的聚合结果。此时,应遵循以下原则:
- 原始行级条件过滤使用
WHERE。 - 基于聚合函数(如
COUNT,MAX)的条件过滤使用HAVING。
掌握这两者的区别,能够显著提高排查数据库异常和数据处理的效率与准确性。以上就是MySQL排查重复数据实战的详细内容,更多关于MySQL数据排查处理的内容请搜索本站以前的文章或继续浏览下面的相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









