

MySQL分库分表方案对比:RANGE、HASH与一致性HASH详解

面对电商系统海量用户数据与高并发访问需求,传统单机MySQL难以承载。分库分表成为提升性能的关键手段。本文将详细对比RANGE、HASH取模及一致性Hash三种分片策略,分析其适用场景与局限性,并通过一致性Hash的Java实现演示如何优雅解决扩容时的数据迁移与数据倾斜问题。
业务场景与挑战
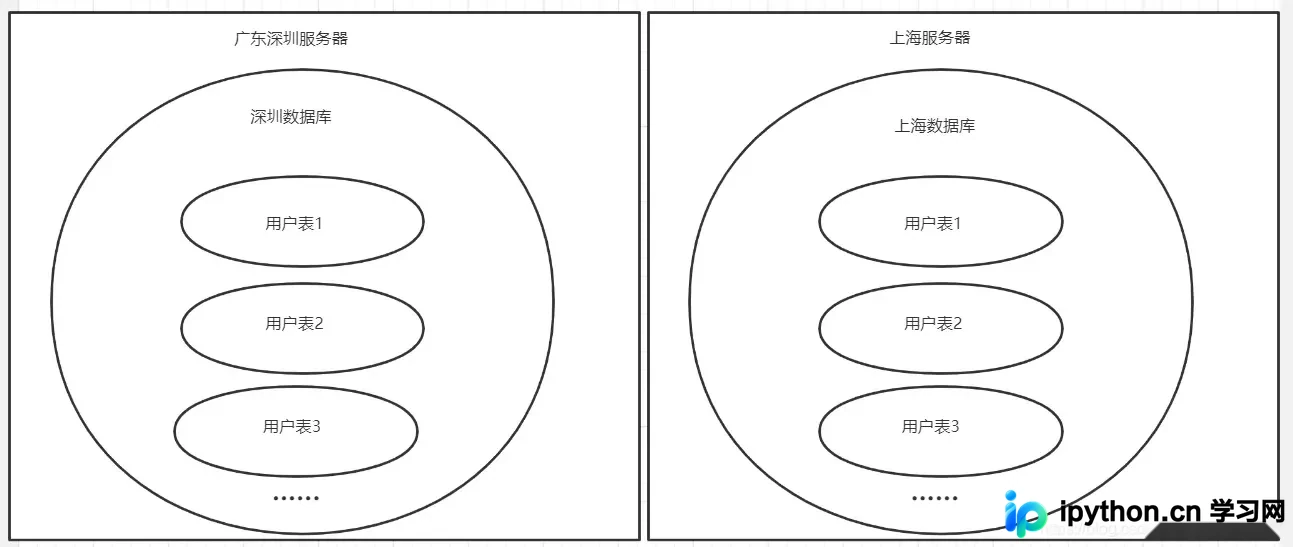
在典型的电商系统中,用户表数据量随业务增长呈指数级上升。单表存储不仅导致查询效率下降,写入瓶颈也日益凸显。为构建具备高扩展性的大数据存储方案,需将物理上的一个大表分散存储到多个数据库实例的不同表中。常见的拆分维度包括按省份/地区划分或基于业务关系拆分,但核心难点在于制定合理的分片规则,以平衡各节点的读写压力并支持平滑扩容。
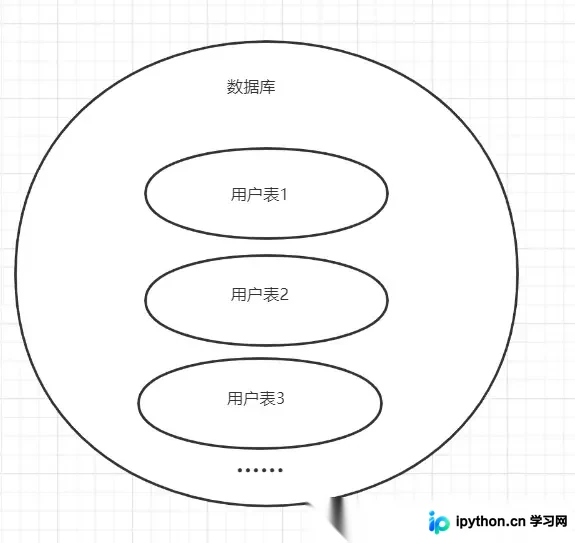
除了基础的垂直拆分(按业务模块分库),水平拆分(分表)是更常用的手段。关键在于如何实现数据均匀分布且便于后续维护。
水平分库分表方法对比
第1步:RANGE范围分片
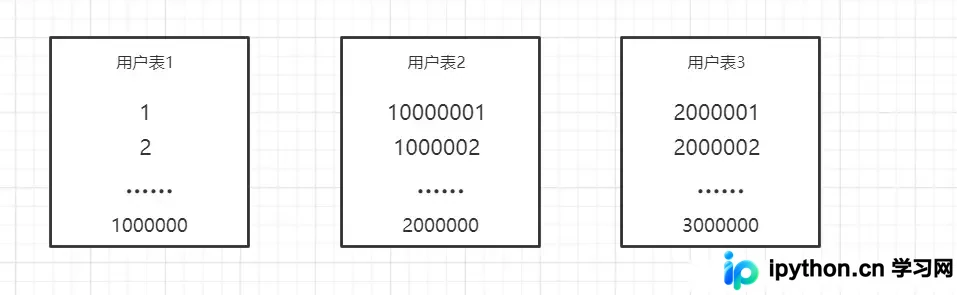
操作逻辑: 根据主键ID的范围区间进行划分,例如 ID 1~1,000,000 存储在库A,ID 1,000,001~2,000,000 存储在库B。
在此模式下,通常需要使用 Redis 的 incr 命令来生成全局唯一的分布式ID,避免本地ID冲突。
优点: 扩容操作简单,预先规划好区间并新建库表即可。
缺点: 随着时间推移,新产生的数据集中在最新创建的库表中,导致“热点”问题。老库负载低,新库IO压力极大,违背负载均衡初衷,不建议在持续写入场景采用。
第2步:HASH取模分片
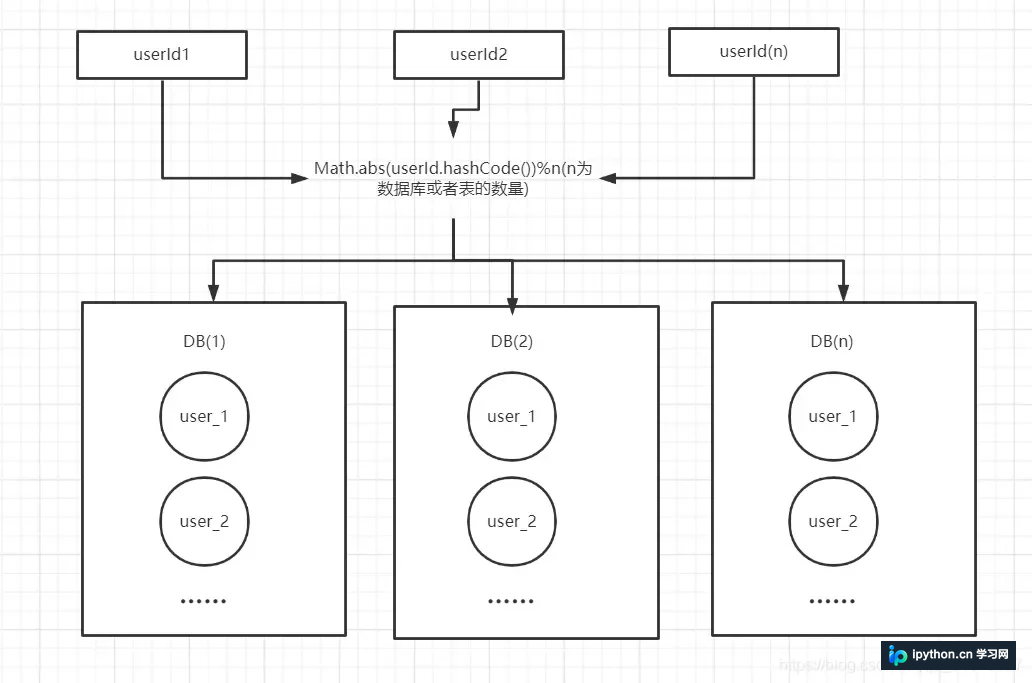
操作逻辑: 对数据的主键ID进行哈希计算后取模,公式通常为 ID % N(N为库或表数量)。这将数据随机分散到不同的节点中。
优点: 数据分布相对均匀,能有效分散读写压力。
缺点: 扩容极其困难。当增加或减少节点数(N变化)时,绝大多数数据的哈希结果会发生改变,导致大量数据需要重新迁移定位,甚至引发全表重排。
第3步:一致性HASH分片(推荐)
为解决普通HASH算法扩容灾难性问题,引入一致性HASH算法。
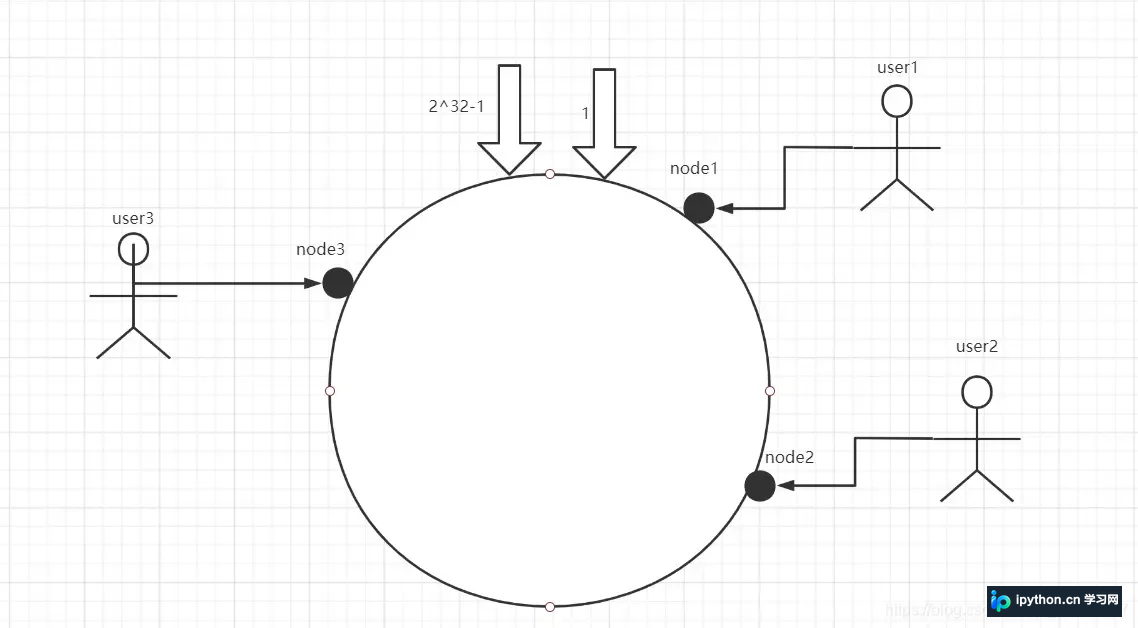
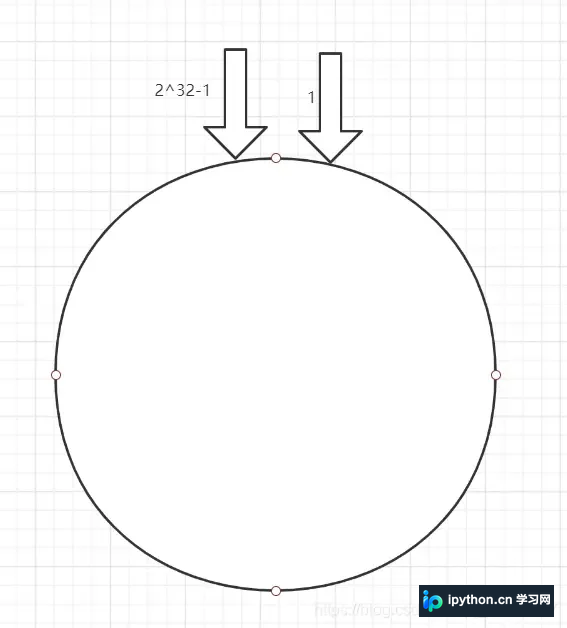
原理机制: 将哈希值空间想象成一个闭合的圆环(0 ~ 2^32-1)。服务器节点和数据Key都映射到该圆环上。数据沿顺时针方向寻找最近的一个服务器节点存储。
节点失效与新增测试:
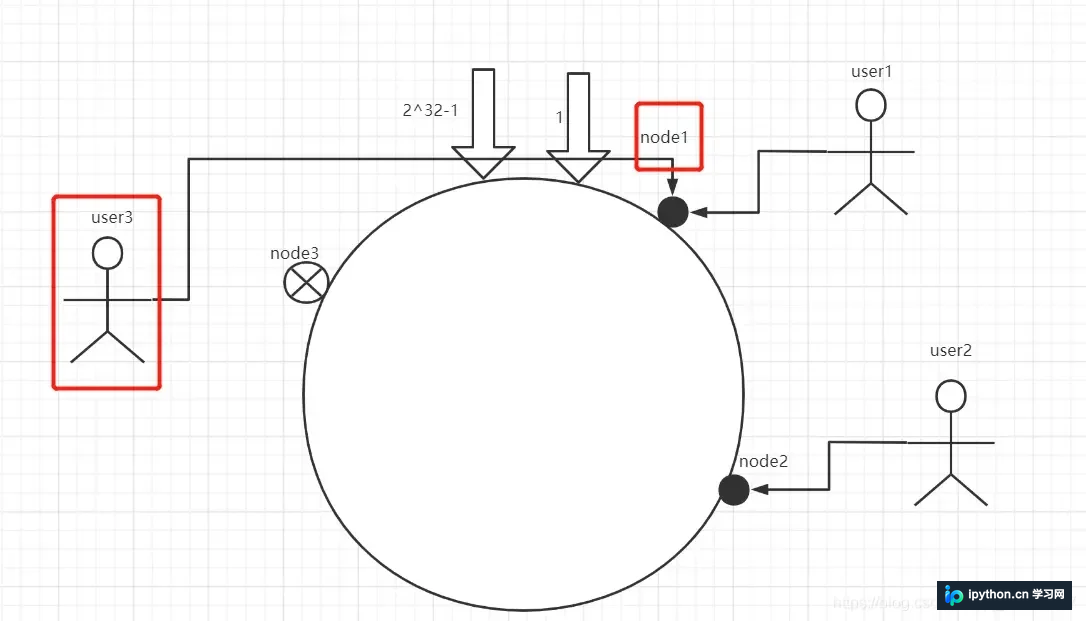
- 节点下线: 假设
node3宕机,原本落在node3的数据(如user3)会顺时针迁移到下一个存活节点node1,而node1和node2的数据保持不变。
[](javascript:void(0))

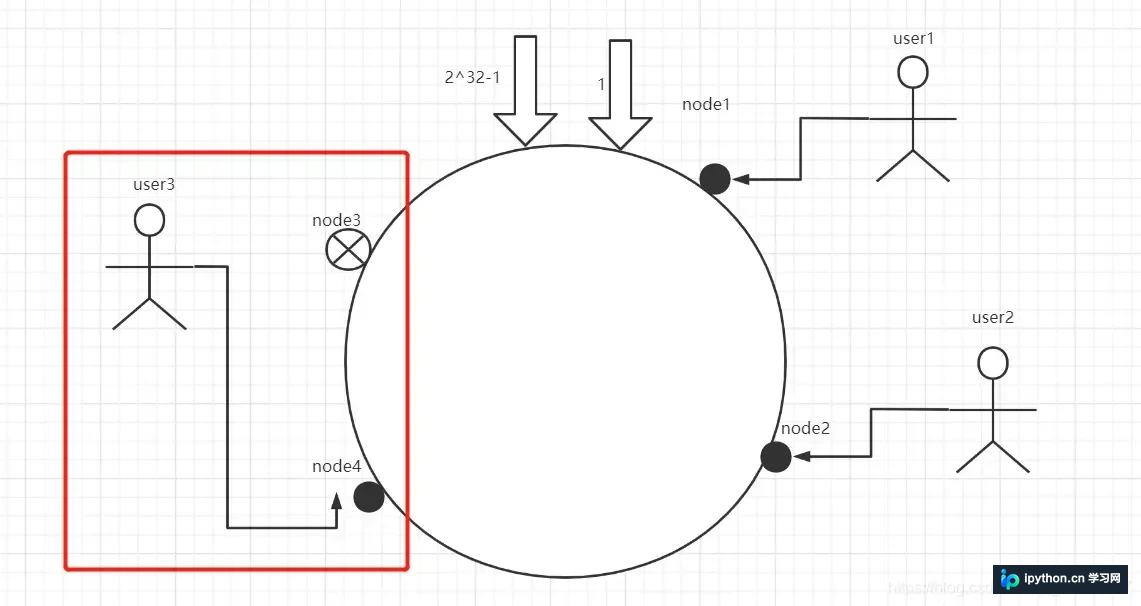
- 节点上线: 新增
node4,user3会从node1迁移到node4。相比普通HASH,只有少量受影响区域的数据发生迁移,极大地减少了集群波动带来的数据搬运压力。
[](javascript:void(0))
虚拟节点解决数据倾斜:
当物理节点较少时,哈希环上的分布可能不均匀,导致某些节点承载过多数据。为此引入“虚拟节点”:为每个物理服务器计算多个哈希值(如 node1-1, node1-2, node1-3),这些虚拟节点均匀分布在哈希环上。实际请求路由时,无论命中哪个虚拟节点,都指向对应的物理服务器。这有效解决了少数节点时的负载不均问题。
总结: 一致性Hash配合虚拟节点,实现了高可用性、容灾性强及扩容数据迁移量最小化,是分布式微服务架构下分库分表的首选方案。
单元测试验证
以下Java代码实现了一致性Hash算法的核心逻辑,包含虚拟节点配置与路由算法测试。模拟3个真实节点,每个节点对应3个虚拟节点,测试9个用户的哈希路由分布情况。
package com.hyh.core.test;

import com.hyh.utils.common.StringUtils;
import org.junit.Test;

import java.util.LinkedList;
import java.util.List;
import java.util.SortedMap;
import java.util.TreeMap;

/**
 * 一致性HASH TEST
 *
 * @Author heyuhua
 * @create 2021/1/31 19:50
 */
public class ConsistentHashTest {

    //待添加入Hash环的服务器列表
    private static String[] servers = {"192.168.5.1", "192.168.5.2", "192.168.5.3"};

    //真实结点列表,考虑到服务器上线、下线的场景,即添加、删除的场景会比较频繁,这里使用LinkedList会更好
    private static List<String> realNodes = new LinkedList<>();

    //虚拟节点,key表示虚拟节点的hash值,value表示虚拟节点的名称
    private static SortedMap<Integer, String> virtualNodes = new TreeMap<>();

    //一个真实结点对应3个虚拟节点
    private static final int VIRTUAL_NODES = 3;

    /**
     * 测试有虚拟节点的一致性HASH
     */
    @Test
    public void testConsistentHash() {
        initNodes();
        String[] users = {"user1", "user2", "user3", "user4", "user5", "user6", "user7", "user8", "user9"};
        for (int i = 0; i < users.length; i++)
            System.out.println("[" + users[i] + "]的hash值为" +
                    getHash(users[i]) + ", 被路由到结点[" + getServer(users[i]) + "]");
    }

    /**
     * 先把原始的服务器添加到真实结点列表中
     */
    public void initNodes() {
        for (int i = 0; i < servers.length; i++)
            realNodes.add(servers[i]);
        for (String str : realNodes) {
            for (int i = 0; i < VIRTUAL_NODES; i++) {
                String virtualNodeName = str + "-虚拟节点" + String.valueOf(i);
                int hash = getHash(virtualNodeName);
                System.out.println("虚拟节点[" + virtualNodeName + "]被添加, hash值为" + hash);
                virtualNodes.put(hash, virtualNodeName);
            }
        }
        System.out.println();
    }

    //使用FNV1_32_HASH算法计算服务器的Hash值,这里不使用重写hashCode的方法,最终效果没区别
    private static int getHash(String str) {
        final int p = 16777619;
        int hash = (int) 2166136261L;
        for (int i = 0; i < str.length(); i++)
            hash = (hash ^ str.charAt(i)) * p;
        hash += hash << 13;
        hash ^= hash >> 7;
        hash += hash << 3;
        hash ^= hash >> 17;
        hash += hash << 5;

        // 如果算出来的值为负数则取其绝对值
        if (hash < 0)
            hash = Math.abs(hash);
        return hash;
    }

    //得到应当路由到的结点
    private static String getServer(String key) {
        //得到该key的hash值
        int hash = getHash(key);
        // 得到大于该Hash值的所有Map
        SortedMap<Integer, String> subMap = virtualNodes.tailMap(hash);
        String virtualNode;
        if (subMap.isEmpty()) {
            //如果没有比该key的hash值大的,则从第一个node开始
            Integer i = virtualNodes.firstKey();
            //返回对应的服务器
            virtualNode = virtualNodes.get(i);
        } else {
            //第一个Key就是顺时针过去离node最近的那个结点
            Integer i = subMap.firstKey();
            //返回对应的服务器
            virtualNode = subMap.get(i);
        }
        //virtualNode虚拟节点名称要截取一下
        if (StringUtils.isNotBlank(virtualNode)) {
            return virtualNode.substring(0, virtualNode.indexOf("-"));
        }
        return null;
    }
}
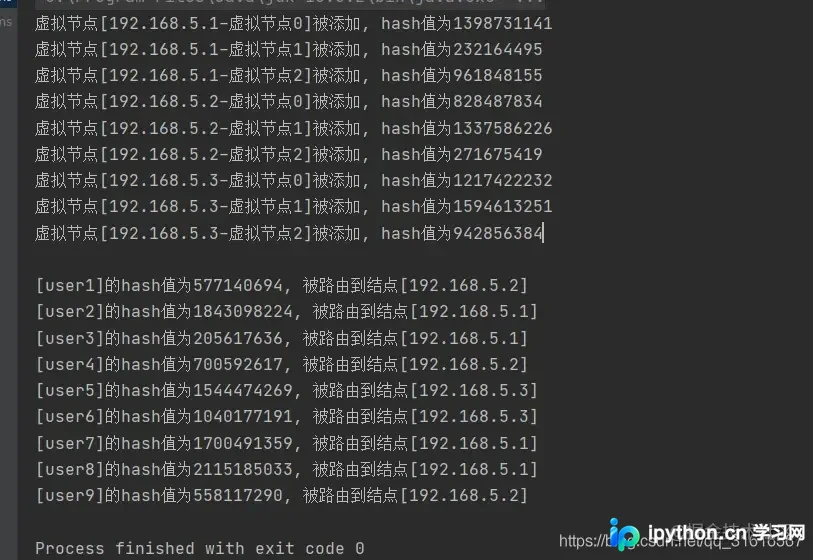
执行上述测试,输出结果显示不同用户被均匀路由到了不同的服务器上,验证了算法的有效性。
总结
在分布式微服务架构下,强烈建议采用一致性Hash算法作为分库分表的基础,尤其是结合虚拟节点机制以保障数据均衡。当然,分布式环境还需进一步解决数据一致性与分布式事务问题,这将是后续探讨的重点。
以上就是MySQL分库分表详情的详细内容,更多关于MySQL分库分表内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









