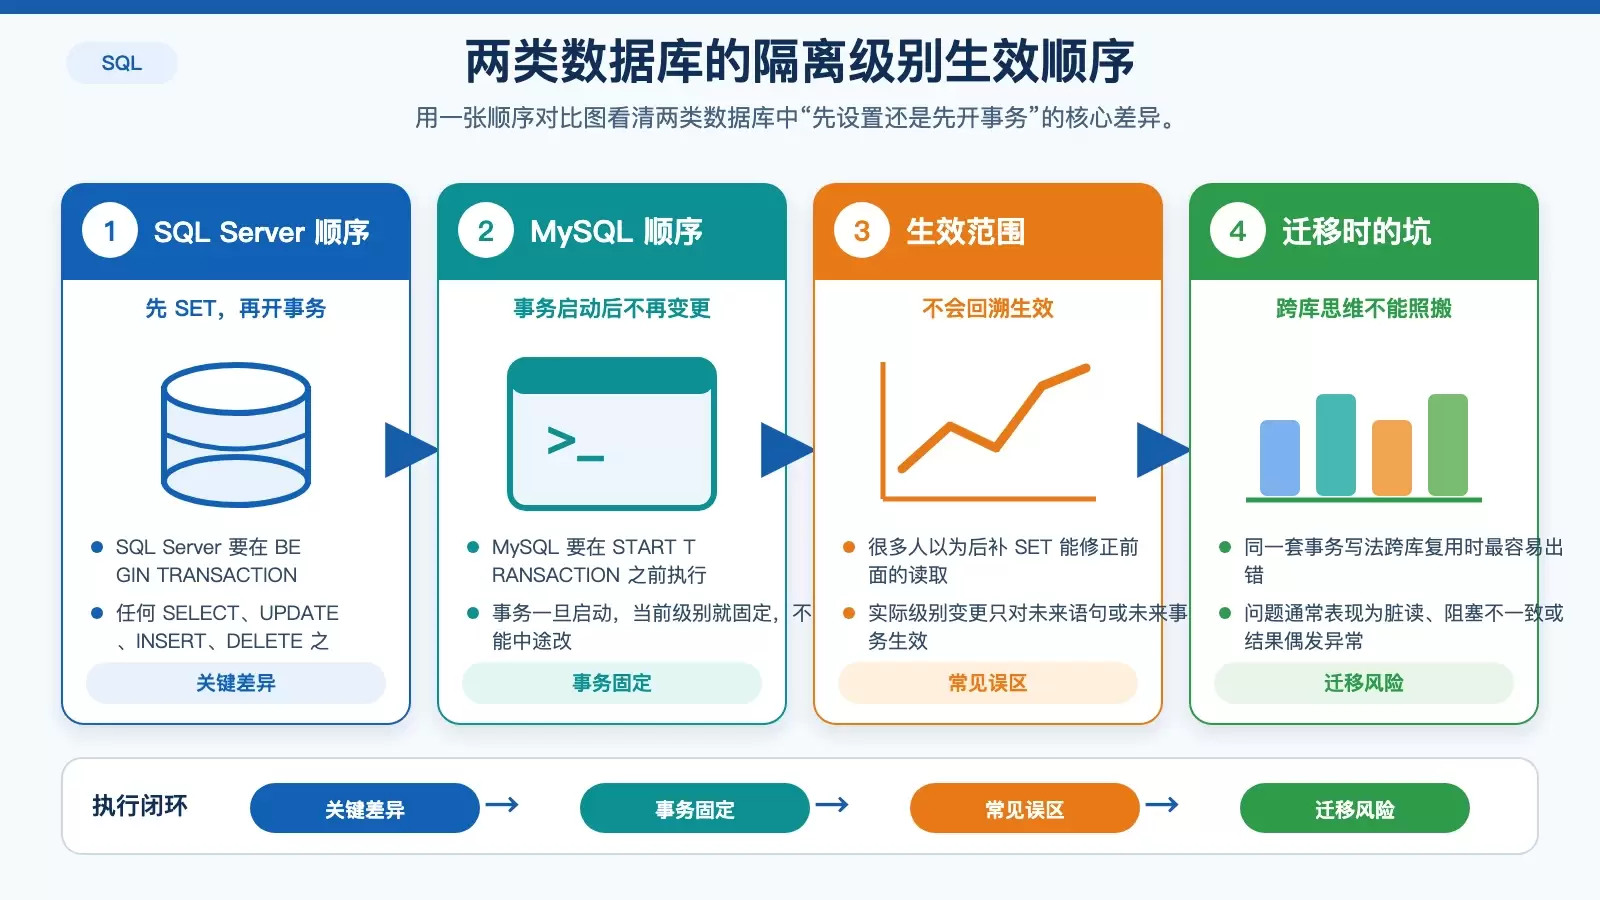
SQL 存储过程如何设置事务隔离级别:SQL Server 与 MySQL 的正确顺序和常见误区
存储过程中设置事务隔离级别,真正容易出错的不是语法,而是生效时机。本文按 SQL Server 与 MySQL 分别梳理正确顺序、常见误区和并发风险,帮助你判断隔离级别到底有没有按预期执行。
2026-08-22
205

存储过程中设置事务隔离级别,真正容易出错的不是语法,而是生效时机。本文按 SQL Server 与 MySQL 分别梳理正确顺序、常见误区和并发风险,帮助你判断隔离级别到底有没有按预期执行。
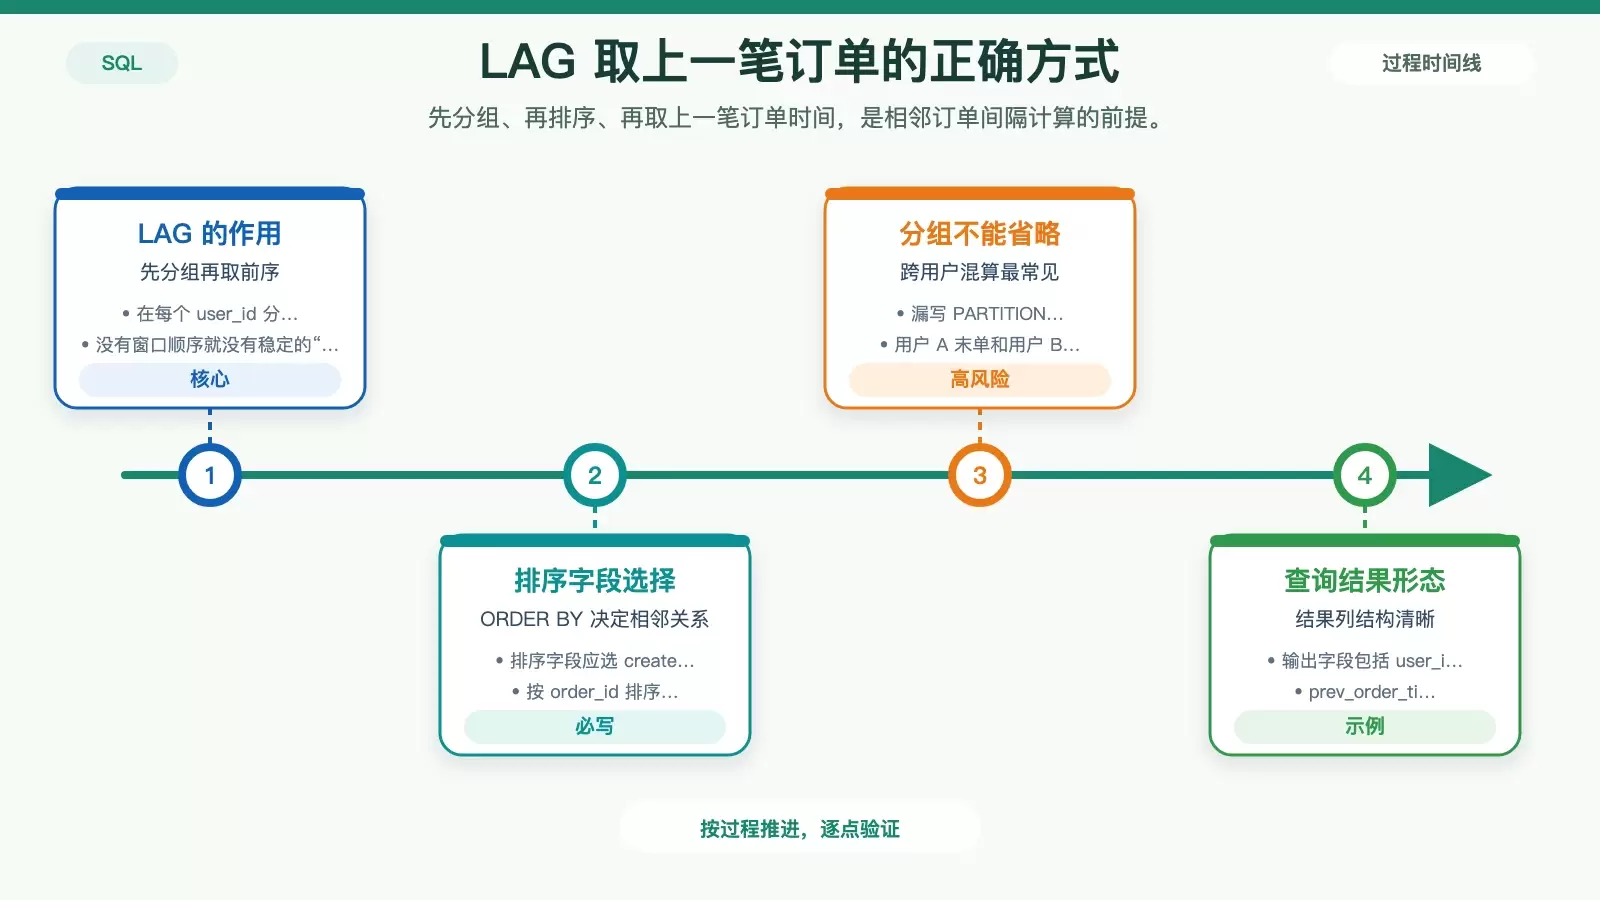
在 SQL 里计算相邻订单时间差,关键不只是 `LAG()`,还包括按正确时间字段排序、按用户分组,以及针对不同数据库选择合适的时间差函数。本文用 MySQL、PostgreSQL、SQL Server 的写法对照说明,并补上空值处理和索引检查的实际要点。
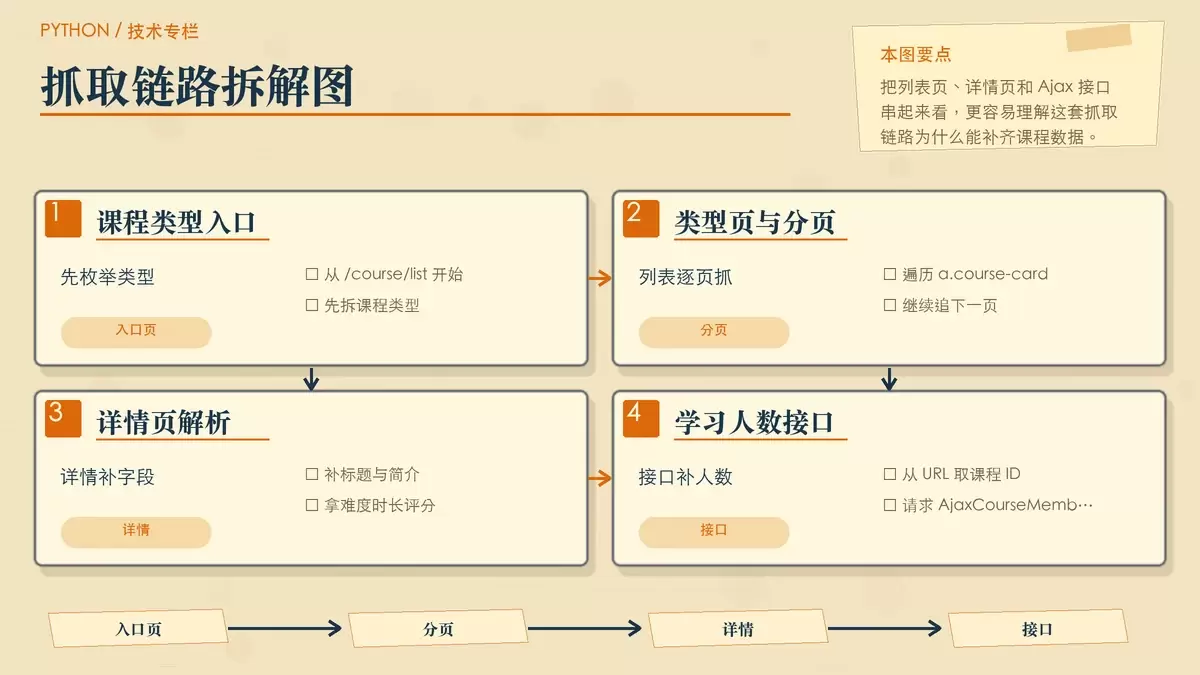
这篇文章把一个抓取慕课网免费课程的 Scrapy 示例,整理成可直接复用的完整流程:从按课程类型翻页抓取,到进入详情页补齐难度、时长、评分,再通过接口拿到学习人数,最后异步写入 MySQL。代码事实、命令和表结构均保留,方便对照落地。
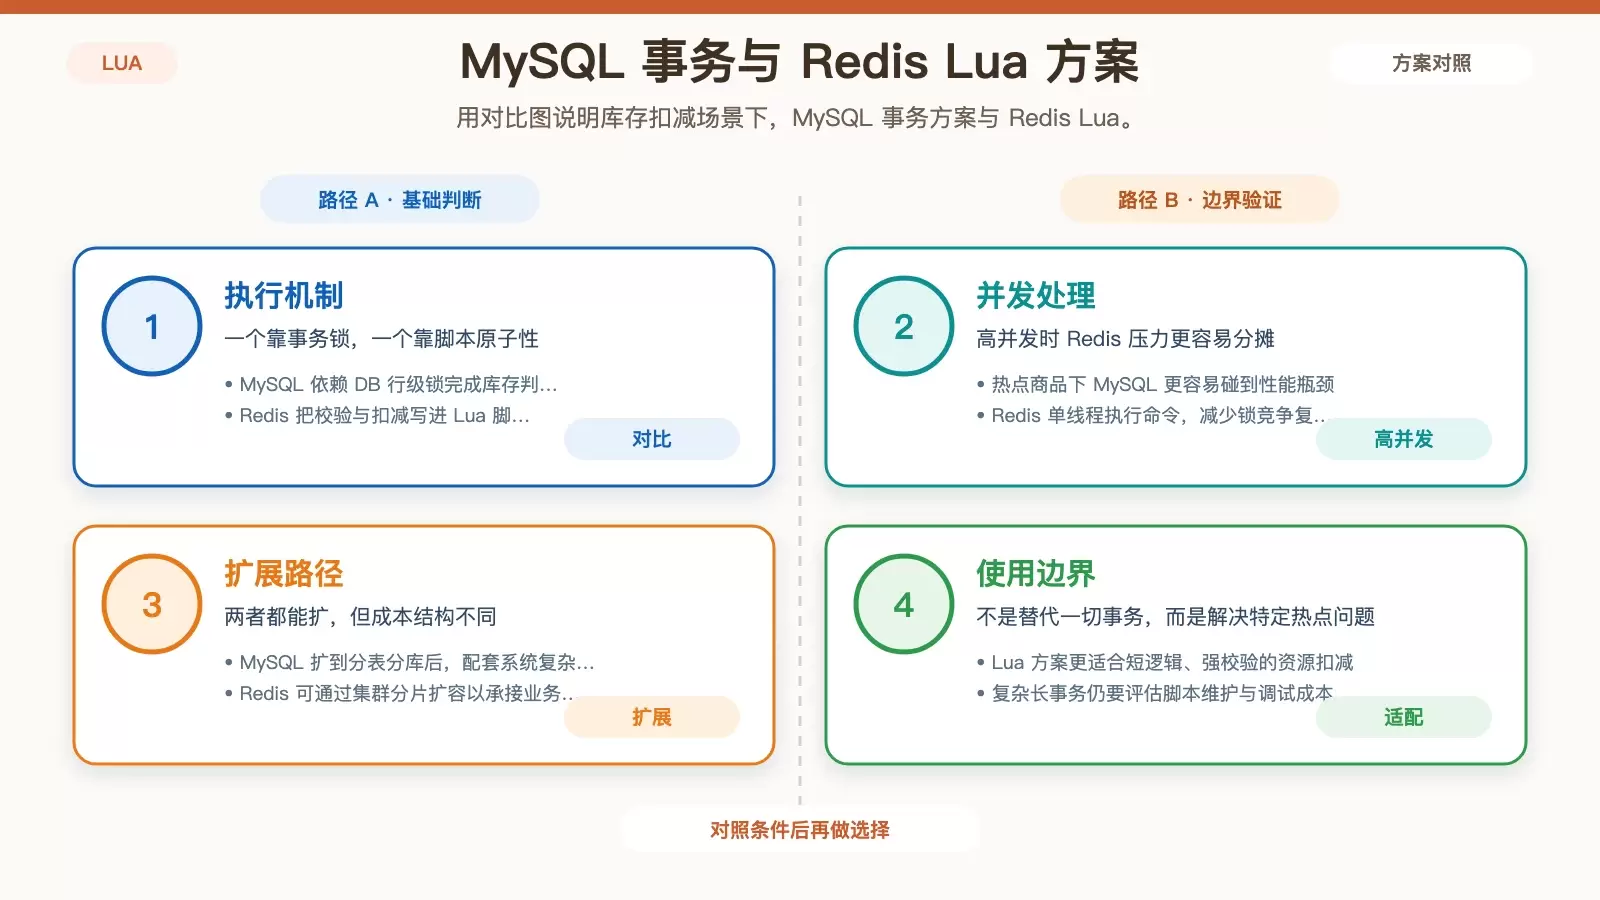
文章围绕“Redis 事务不能像 MySQL 一样回滚”这一痛点,拆解 Lua 脚本如何把库存校验、扣减、防重和结果返回收敛为一次原子执行。文中保留了初始化、脚本加载与执行代码,并说明 Redis 集群下多 Key 同分片等落地细节。
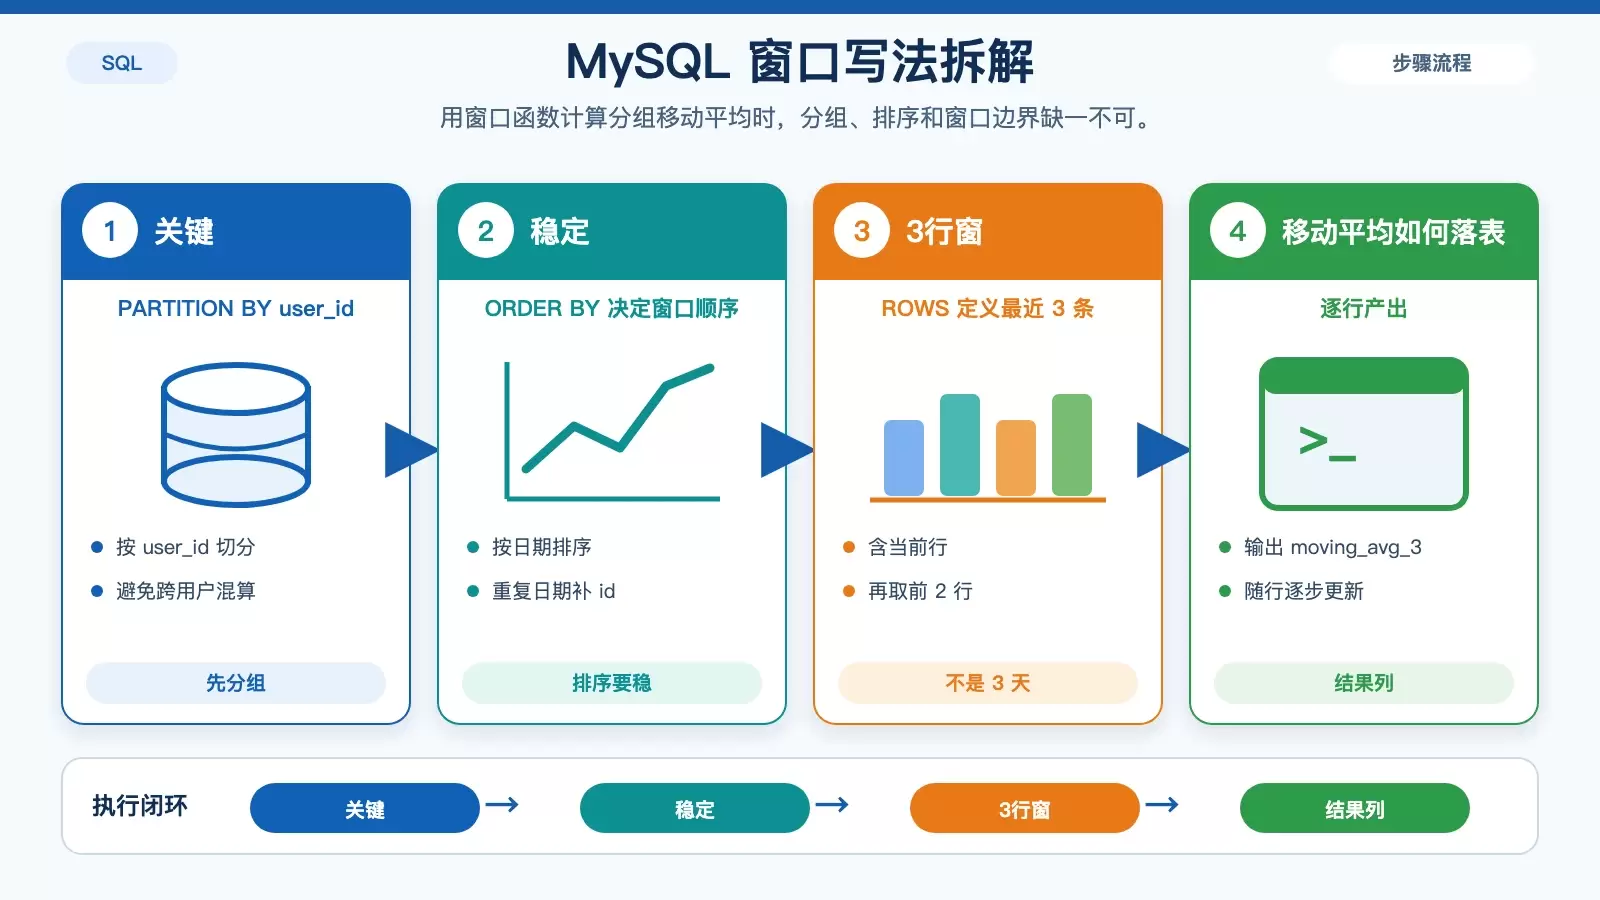
分组移动平均在 SQL 里不难,真正容易出错的是窗口怎么定义、分组是否隔离,以及数据库版本对 `ROWS`、`RANGE` 的支持差异。本文按 MySQL、PostgreSQL、SQL Server 与 SQLite 分别梳理可用写法,并补上边界行与 `NULL` 处理时最常见的误区。
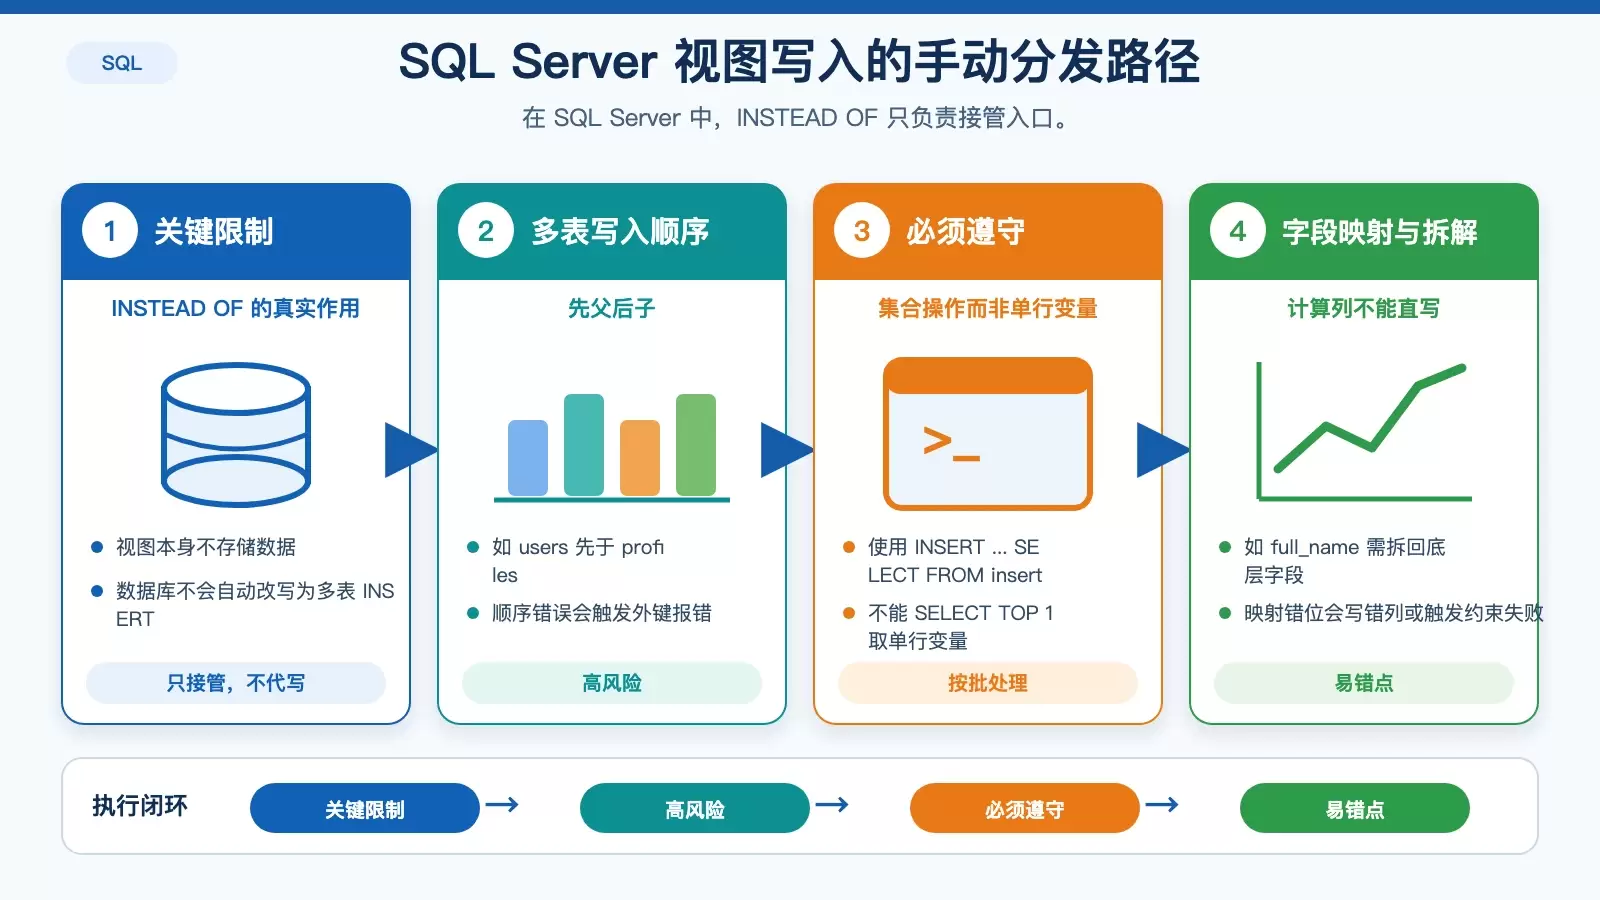
复杂视图之所以不能像表一样直接更新,核心不在语法,而在数据库是否愿意替你拆解 DML。SQL Server 允许借助 INSTEAD OF 触发器接管写入,但所有分发表、字段映射和校验都要手写;MySQL 则直接禁止在视图上创建触发器。
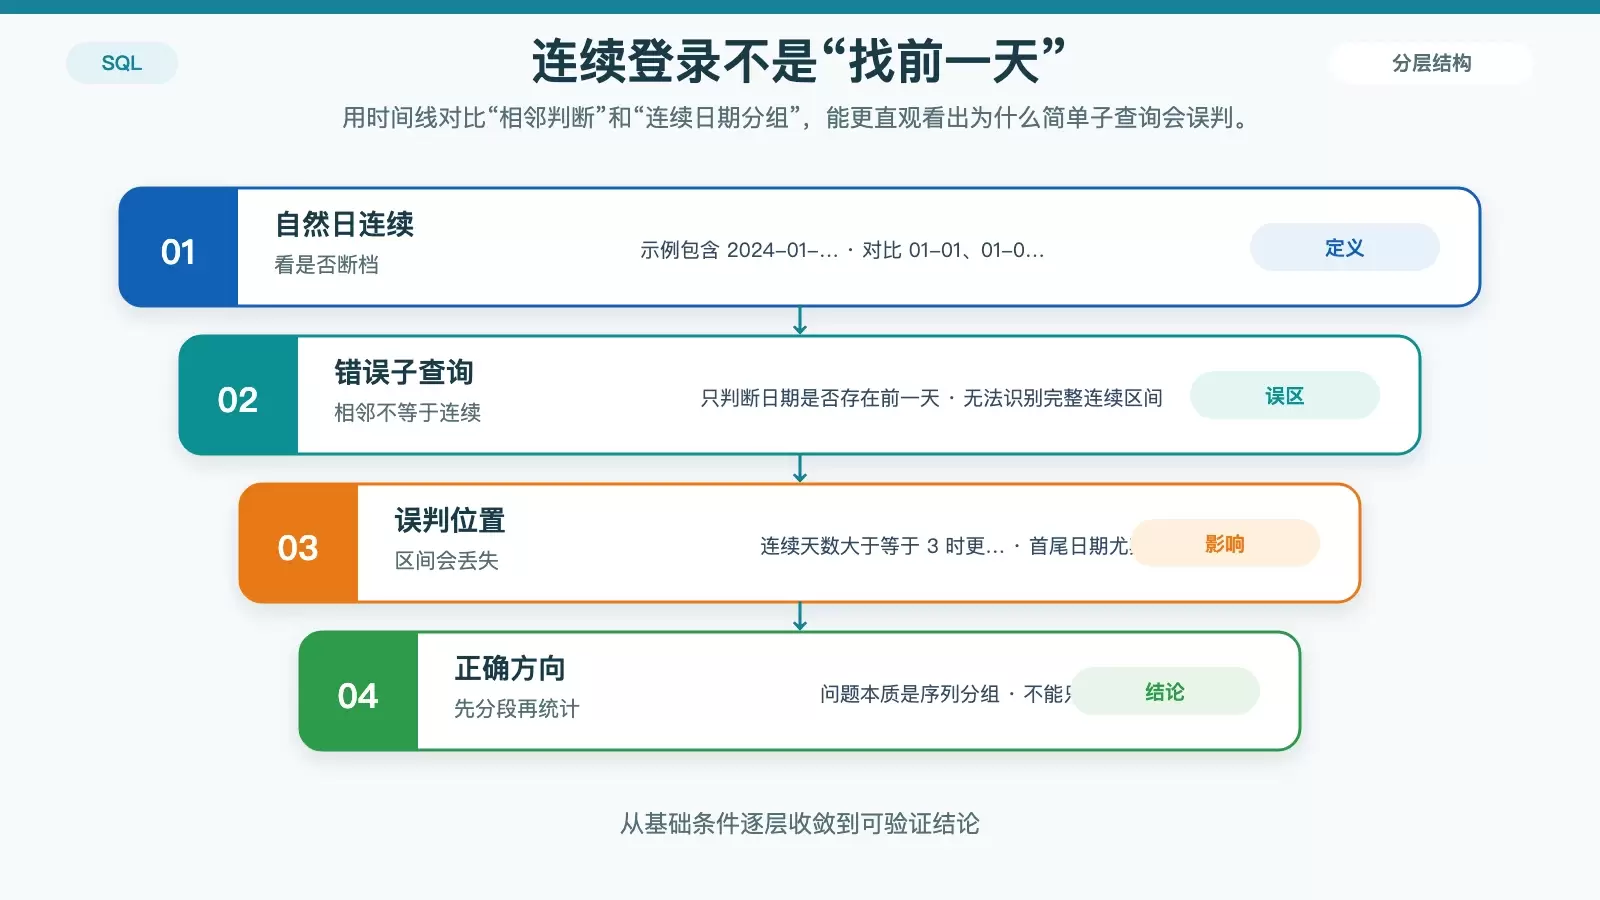
查询连续登录用户,关键不在“找前一天是否存在”,而在把无断档的日期序列识别成同一段。本文围绕连续登录定义、`ROW_NUMBER()` 分组写法、MySQL 5.7 替代方案与 `LEAD/LAG` 适用边界,整理出更适合上线使用的 SQL 思路。
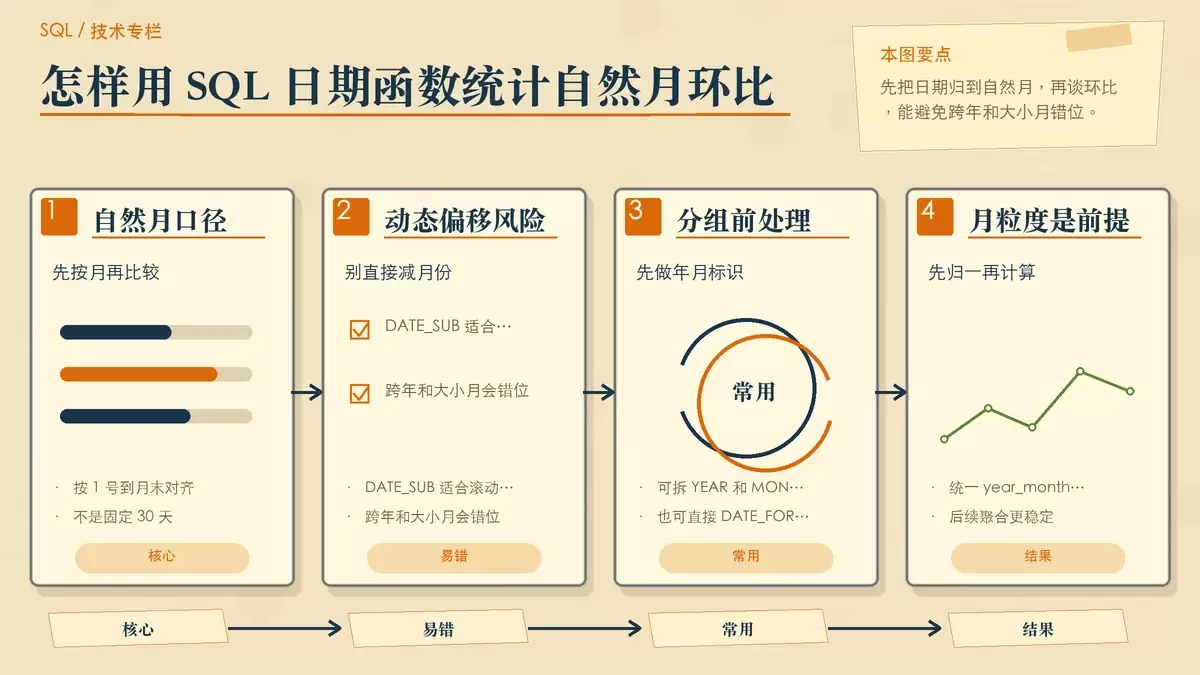
统计自然月环比,难点不在公式本身,而在“按日历月对齐”和“上月值如何准确关联”。本文按 MySQL 8.0+ 与 5.7 及以下两种场景,整理可直接套用的 SQL 写法,并补出时区、空值、除零和时间口径这些最容易让结果失真的细节。
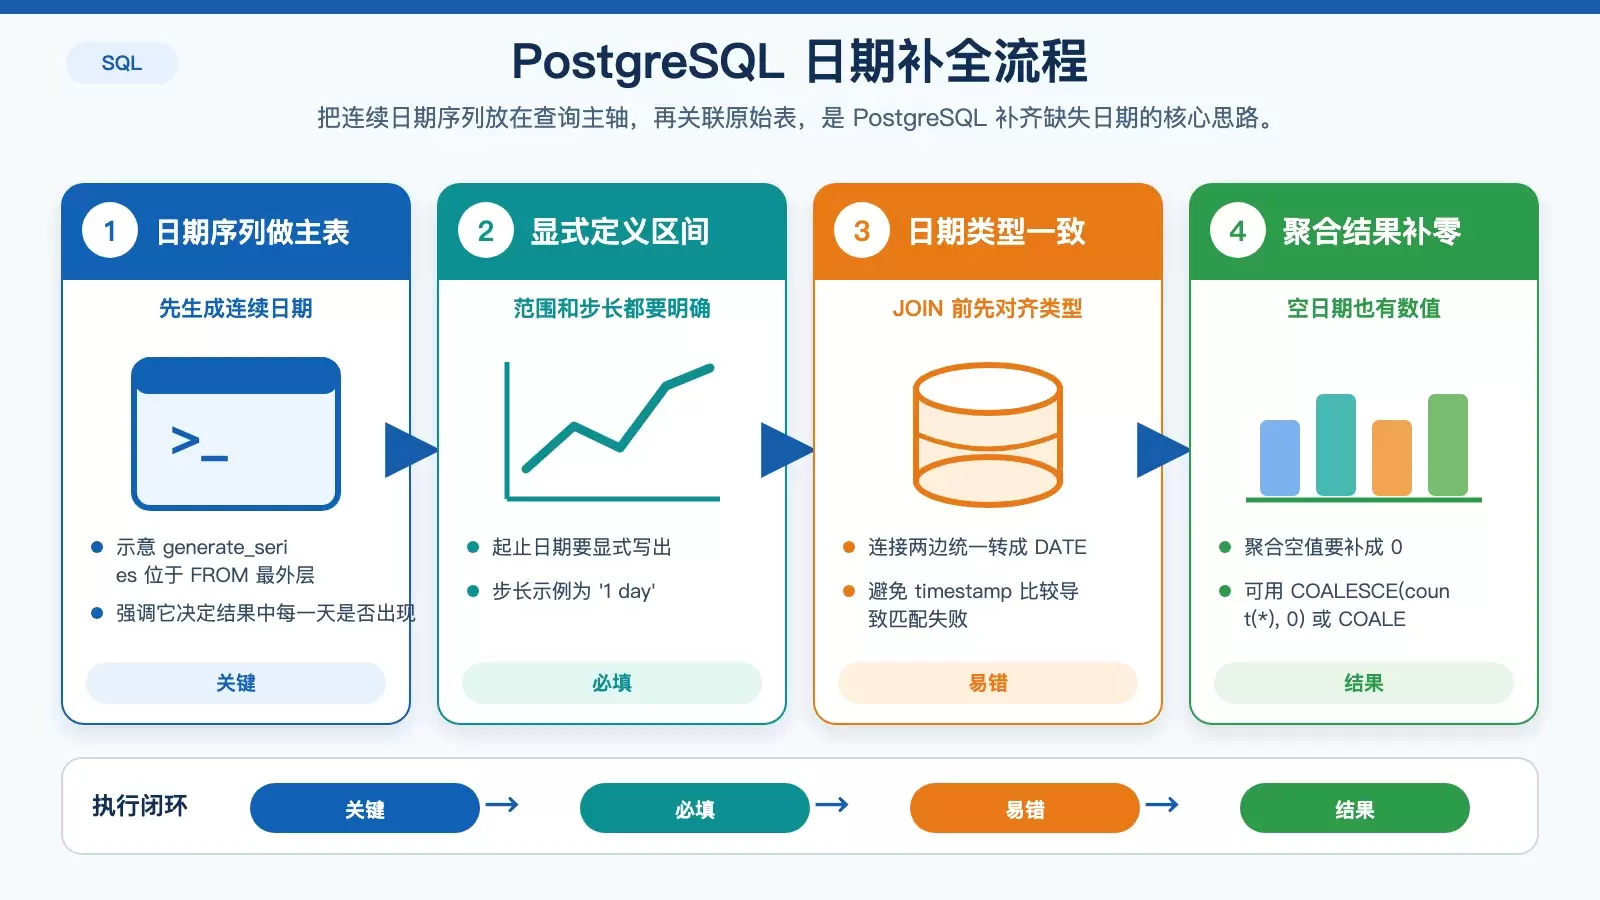
按日期分组后出现“断档”,通常不是 GROUP BY 写错,而是结果集里本来就没有那些日期。本文分别整理 PostgreSQL 的 `generate_series`、MySQL/SQL Server/Oracle 的日历表方案,并说明周/月分组、性能和边界数据里最容易踩的坑。 按日期统计时,结果里少几天、少几周,很多时候并不是 `GROUP BY` 写错了,而是数据源里根本没有这些日期。
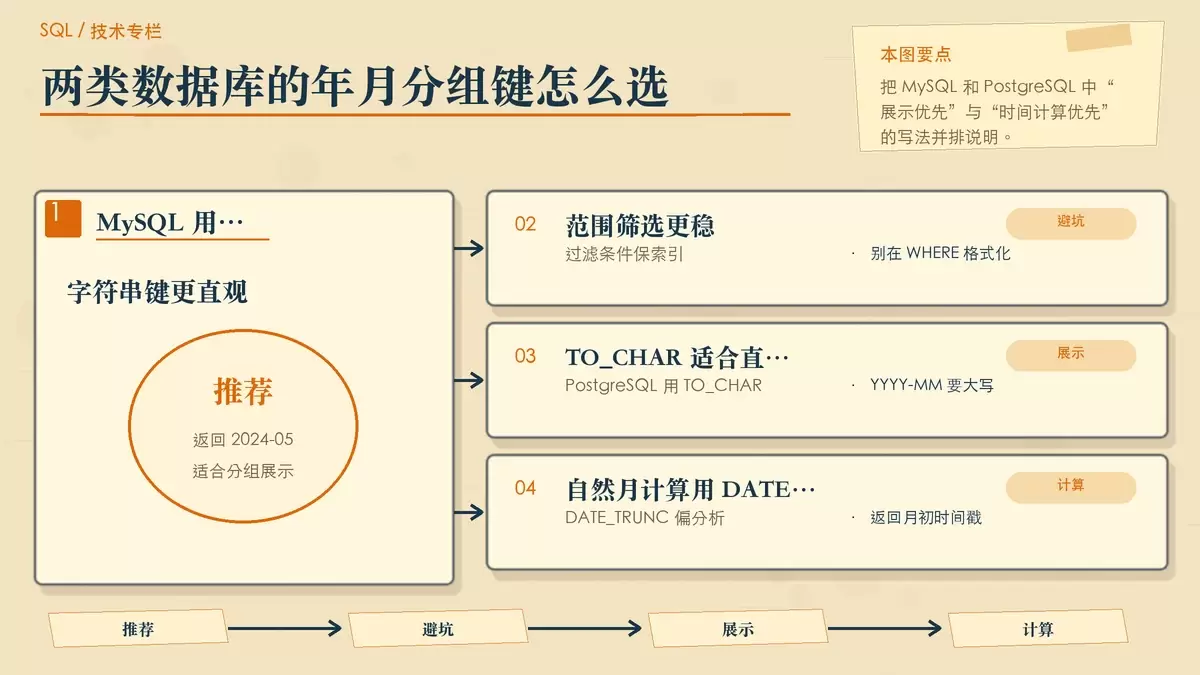
按年月统计订单并不难,难点在于分组键是否稳定、展示是否直观,以及查询能否继续走索引。本文按 MySQL、PostgreSQL、SQL Server 和跨库写法分别整理可直接落地的方案,同时指出常见误区与性能边界。
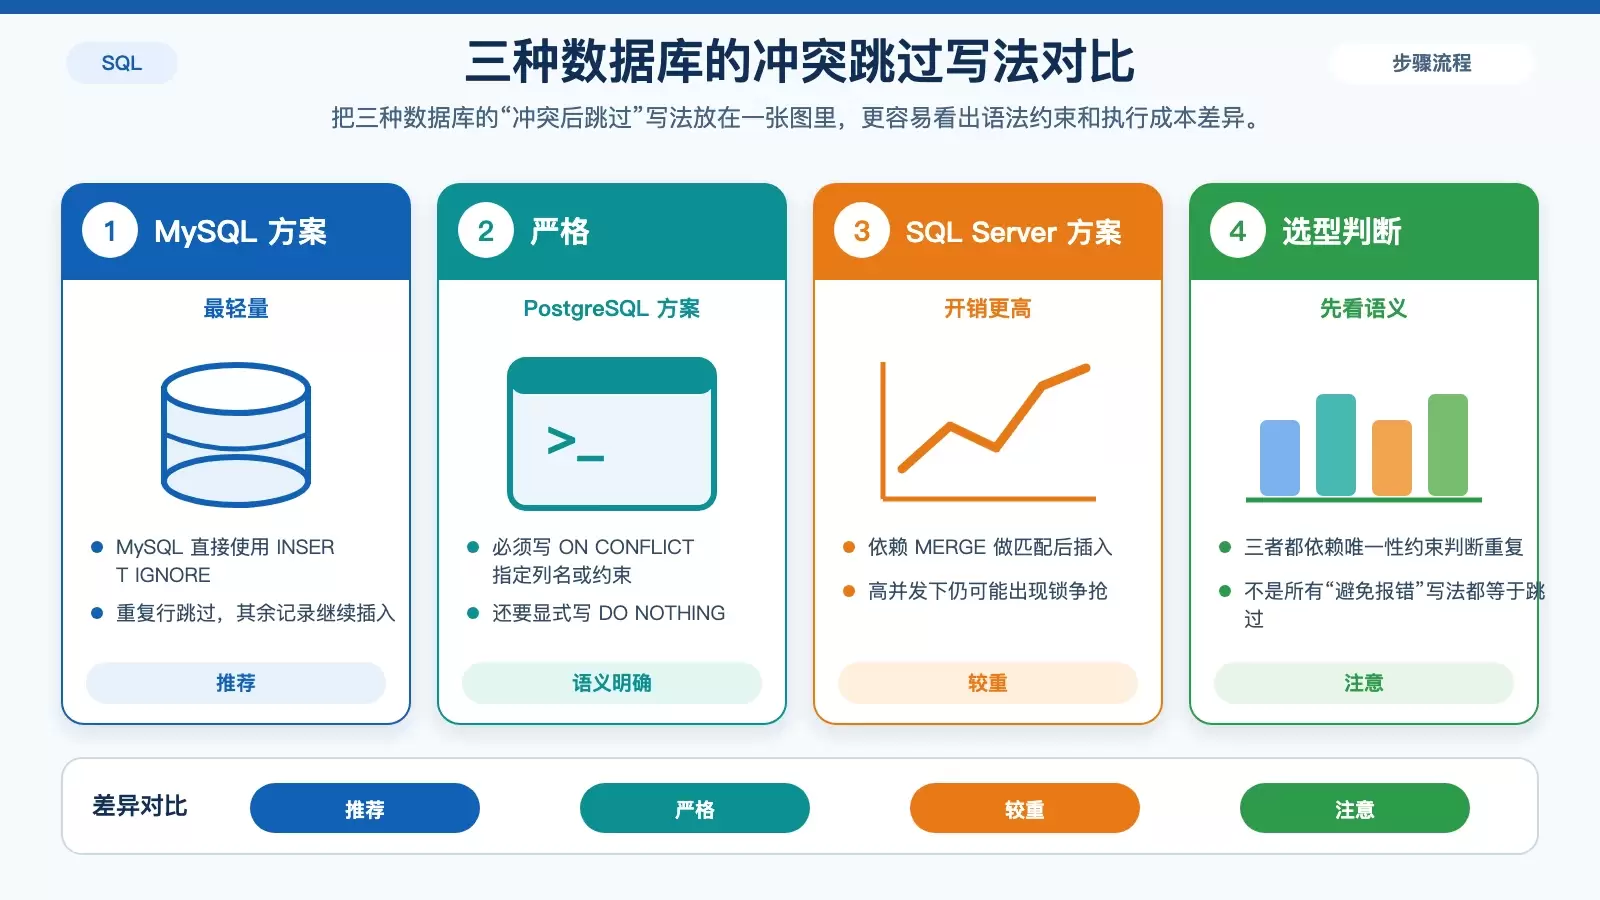
批量插入遇到主键或唯一键重复时,核心不是“怎么不报错”,而是按数据库方言选择真正的跳过写法。MySQL、PostgreSQL 和 SQL Server 的语义、锁行为与开销差异很大,用错语句往往会把简单去重变成阻塞和死锁问题。
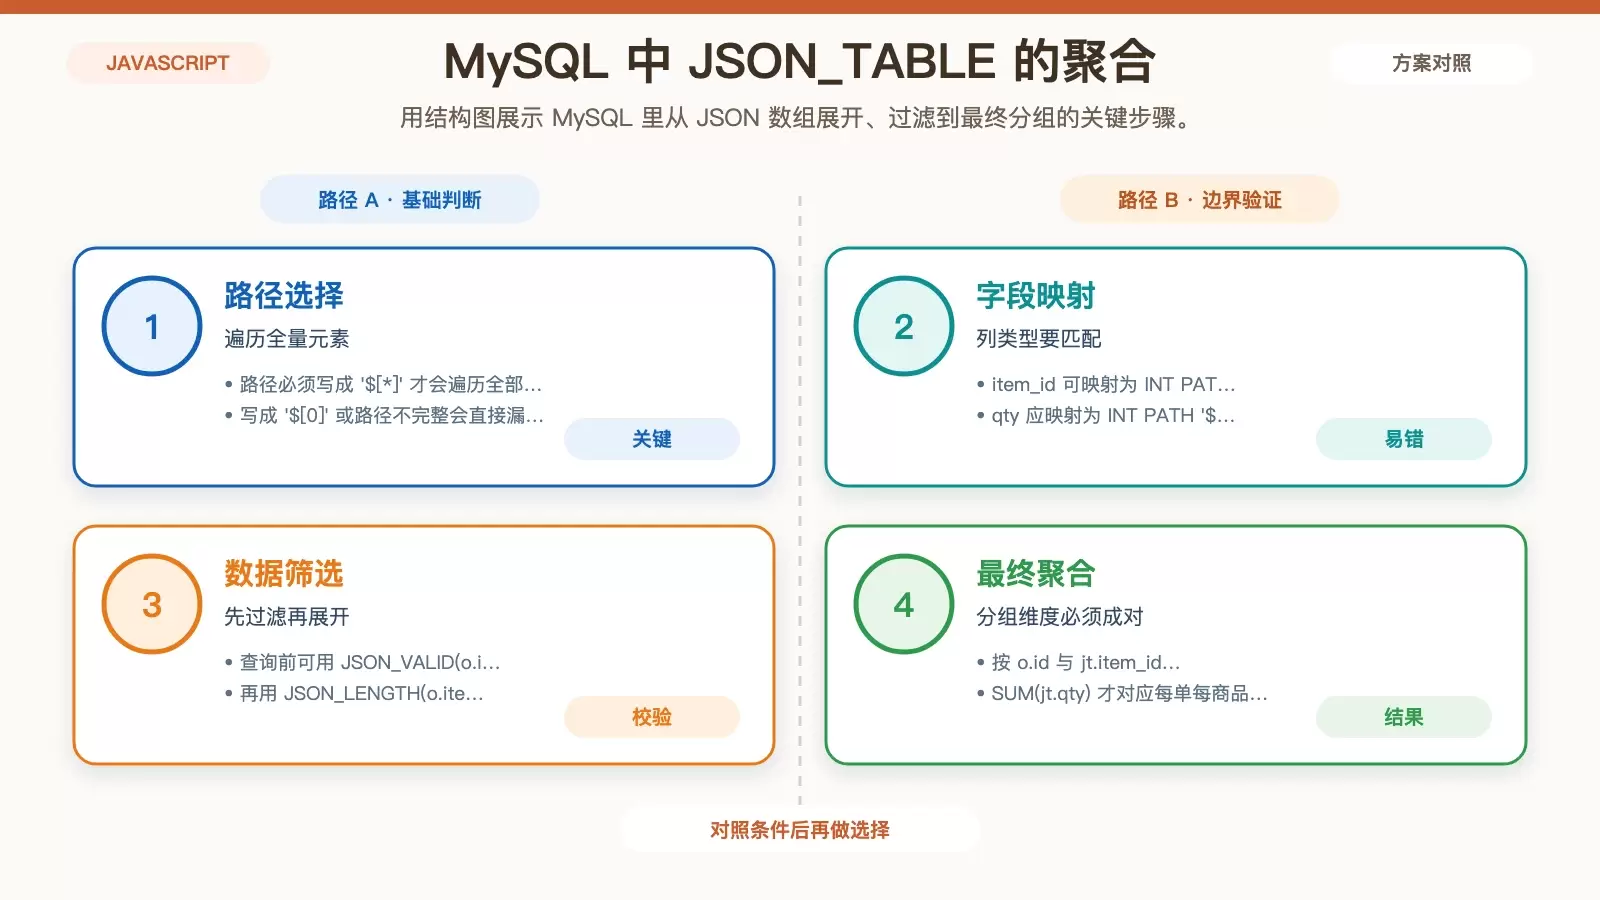
JSON 字段里的数组或对象,不能直接拿来做 `GROUP BY`。这篇文章把 MySQL 8.0+ 的 `JSON_TABLE()` 和 PostgreSQL 的 `jsonb_array_elements()` 拆开说明,并补上类型转换、空值过滤、分组维度选择这些最容易把统计结果做错的关键点。 JSON 字段里有数组或对象时,不能直接 GROUP BY 。正确做法是先展开成行,再按主键或提取字段分组。