

MySQL内部临时表:何时产生及使用场景解析

MySQL在执行复杂查询时,常需借助内部临时表处理中间结果。本文将深入剖析在UNION去重和GROUP BY分组两大典型场景中,MySQL如何利用内存及磁盘临时表协助完成运算,并解释从内存转换为磁盘表的触发条件及性能影响。
UNION操作中的临时表应用
在使用 UNION 合并多个子查询结果集时,MySQL必须执行隐式去重操作。此时,引擎通常会创建一个内部临时表来暂存中间数据。为了清晰展示这一机制,我们先构建测试环境:
CREATE TABLE t1 ( id INT PRIMARY KEY, a INT, b INT, INDEX ( a ) );

delimiter ;;
CREATE PROCEDURE idata ( ) BEGIN
DECLARE i INT;
SET i = 1;
WHILE ( i <= 1000 ) DO
INSERT INTO t1 VALUES ( i, i, i );
SET i = i + 1;
END WHILE;
END;;
delimiter ;
CALL idata ( );
随后执行以下带有排序和限制的去重查询:
(select 1000 as f) union (select id from t1 order by id desc limit 2);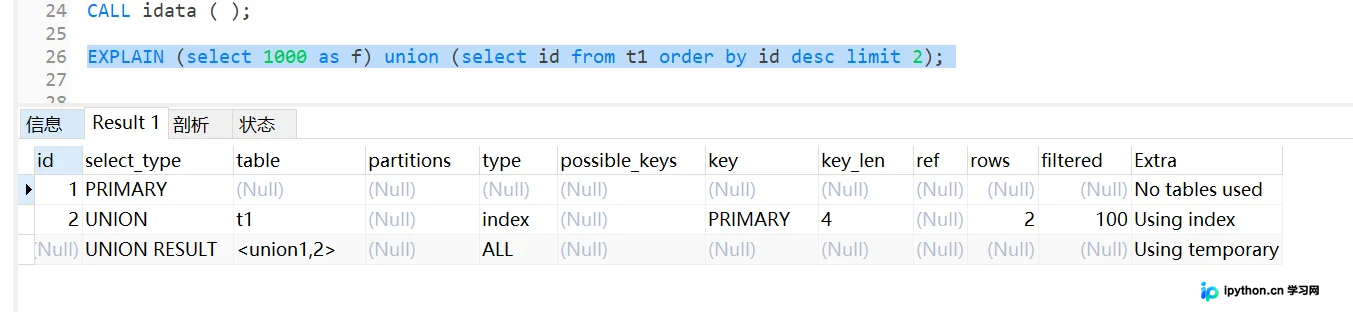
查看该查询的执行计划(EXPLAIN),可以观察到几个关键特征:第二个子查询的 key 字段为 PRIMARY,表明正确利用了索引;而最关键的标志出现在 Extra 字段中显示的 Using temporary,这直接证实了查询过程中创建了临时表。
第1步:内存临时表初始化
Mysql首先分配一个仅包含单列整形字段 f 作为主键的内存临时表。该结构旨在快速判断数据的唯一性。
第2步:插入首个子查询结果
执行第一个子查询 select 1000,并将数值 1000 写入临时表中。
第3步:插入第二个子查询结果并去重
接着处理第二个子查询(按ID降序取前两行):
- 取出第一行数据
id=1000,尝试插入临时表。由于该值已存在且违背主键唯一性约束,插入被拒绝,该行不计入最终结果。 - 取出第二行数据
id=999,临时表中不存在该值,插入成功。
第4步:返回结果并清理
遍历结束后,MySQL从临时表中逐行提取数据作为最终输出(本例为1000和999,注:此处原文逻辑为演示去重过程,实际union返回顺序取决于内部排序或插入顺序,重点在于1000被重复处理后的去重逻辑演示),随后销毁该临时表以释放资源。
GROUP BY分组中的临时表机制
另一个高频使用临时表的场景是 GROUP BY 语句。当需要对数据进行分组统计并伴随排序时,临时表成为核心组件。
select id%10 as m, count(*) as c from t1 group by m;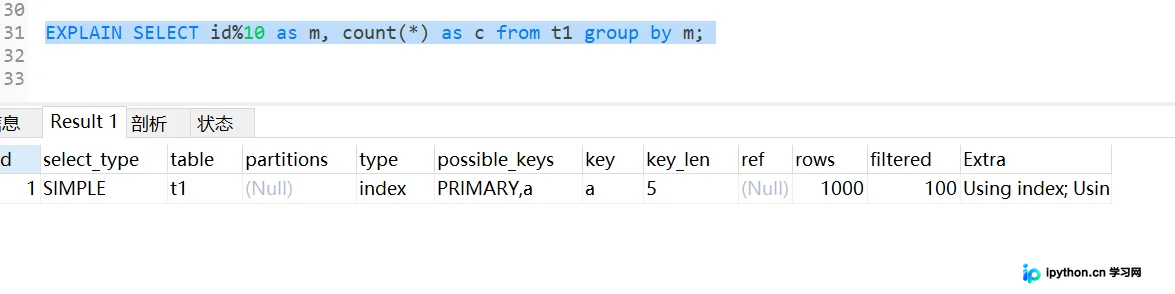
观察上述语句的执行计划 Extra 字段,包含了三个重要信息:
1. Using index:表示使用了覆盖索引,避免了回表读取。
2. Using temporary:表明建立了临时表用于分组。
3. Using filesort:意味着最终的排序无法依靠索引自然完成,必须在内存或磁盘中进行文件排序。
第1步:建立分组临时表结构
系统创建一个具有两列(m 和 c)的临时表,其中 m 字段作为主键。
第2步:扫描原始数据并聚合
扫描基表 t1 的索引 a,依次获取叶子节点的值 id,计算 id % 10 的结果记为 x:
- 若临时表中不存在主键
x,则新插入一行记录(x, 1)。 - 若临时表中已存在主键
x,则将对应行的计数值c加 1。
第3步:排序并输出
所有源数据扫描完毕后,临时表中存储的是去重后的分组结果。此时引擎根据字段 m 执行 filesort 操作,对临时表内容进行排序,最后输出给客户端。
内存限制与磁盘转换风险
需要注意的是,MySQL生成的内存临时表体积并非无限大。该容量受到系统参数 tmp_table_size 的严格管控,默认值为 16MB。
当正在使用的内部临时表数据量接近或达到此上限时,MySQL会自动触发降级机制,将内存中的临时表转换为基于磁盘的临时表(默认引擎通常为 InnoDB)。如果涉及的数据量巨大,这种转换会导致大量的随机 I/O 操作,显著拖慢查询速度。因此,在处理海量数据的分组或去重操作前,评估数据规模并适当调整相关配置至关重要。
以上就是MySQL内部临时表在Union去重及Group By排序中使用场景的详细内容,更多关于MySQL临时表优化与原理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









