

MySQL非空约束设置、添加与删除方法
本文详解MySQL中非空约束(NOT NULL)的用法。通过具体案例演示如何在创建表时定义非空字段,如何修改现有表添加或移除非空约束,并提供完整的SQL语句及运行结果参考,帮助用户规范数据库设计。
2026-10-16
8

本文详解MySQL中非空约束(NOT NULL)的用法。通过具体案例演示如何在创建表时定义非空字段,如何修改现有表添加或移除非空约束,并提供完整的SQL语句及运行结果参考,帮助用户规范数据库设计。
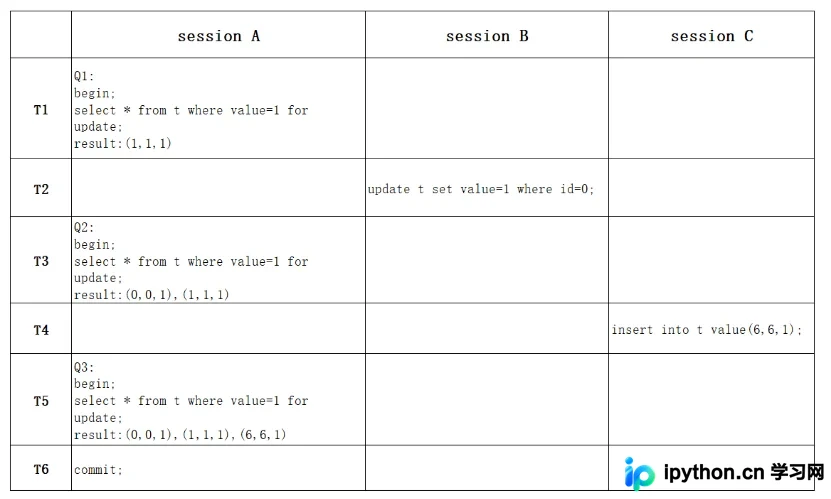
本文探讨MySQL在“可重复读”(RR)隔离级别下如何彻底解决“幻读”问题。普通查询(快照读)依靠MVCC机制保证一致性,而加锁查询(当前读)则引入间隙锁(Gap Lock)锁定记录间的逻辑区间。文章通过Next-Key Lock机制分析并发控制策略,并指出在高并发场景下RC隔离级别的替代方案及其潜在风险。
本文深入解析MySQL触发器在数据库管理中的实际应用,以学校数据库(School)为例,演示如何创建BEFORE INSERT/UPDATE触发器。重点解决成绩范围(0-100)校验、学分上限(30分)控制、不及格记录保护、默认年龄填充以及自动计算学生平均成绩与等级评定等需求,确保数据的实时一致性与业务逻辑的自动化执行。
本文详解 Node-RED 连接 MySQL 数据库的全过程。从安装 node-red-node-mysql 节点开始,逐步演示如何配置数据库连接参数,并通过 inject 与 function 节点执行 CREATE DATABASE、CREATE TABLE 及 INSERT 语句。掌握在 Node-RED 中高效管理关系型数据的方法,包含直接字符串拼接与 util.format 两种动态传参技巧。
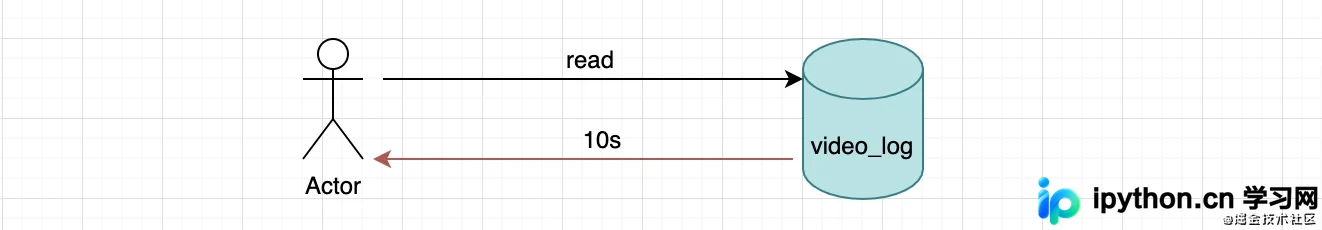
面对日均百万级增长的 MySQL 日志表,本文对比了老数据归档、应用层分表及迁移至 TiDB 三种方案。重点复盘迁移 TiDB 过程中遇到的主键冲突难题,并分享基于 Redis 状态记录的断点续传同步脚本设计,实现平滑迁移且避免线上阻塞。
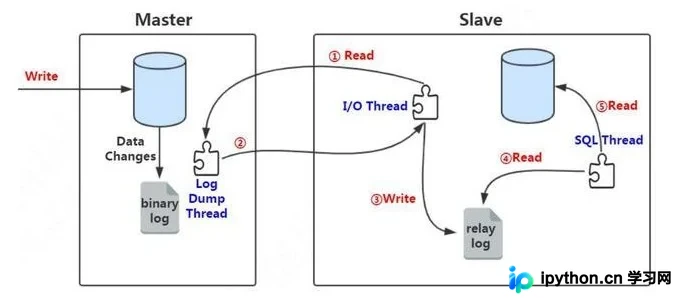
本文详细解析MySQL主从复制中实现数据过滤的两种核心思路。重点讲解为何推荐在从库而非主库进行过滤,并通过CHANGE REPLICATION FILTER命令展示具体的过滤配置步骤(包括库级与表级过滤)。同时提供GTID模式下解决因表结构不一致导致的SQL线程报错及自动恢复方案。
许多开发者误以为 MySQL 中 WHERE name IS NULL 会导致索引失效,实则不然。本文通过 innodb_ruby 工具与二进制文件分析,揭示 NULL 值在 B+ 树中的存储位置;并通过案例复现证明,所谓“索引失效”通常是由于条件匹配行数过多(如 >20%)导致回表成本高于全表扫描,由 Optimizer 主动放弃索引所致。
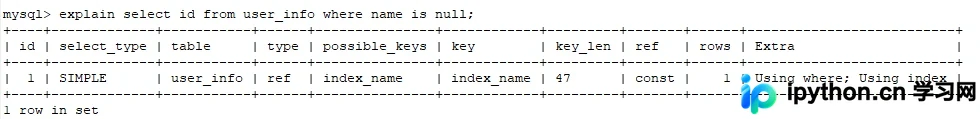
本文介绍如何仅凭借 .frm 文件恢复 MySQL 数据表的定义结构。针对 InnoDB 引擎,通过在同名数据库重建空表并覆盖 .frm 文件实现;针对 MyISAM 引擎,则需建立 .MYI/.MYD 占位文件后执行 REPAIR TABLE ... USE_FRM 命令。该方法适用于备份丢失但保留基础文件时的紧急恢复场景。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
在MySQL中,CHAR是固定长度字符类型,不足补空格;VARCHAR是可变长度,仅存实际内容加1-2字节头信息。CHAR适合定长且短小的数据如MD5哈希,查询速度快;VARCHAR适合不定长文本以节省空间。合理选择能显著提升存储空间利用率与I/O效率,避免不必要的资源浪费。
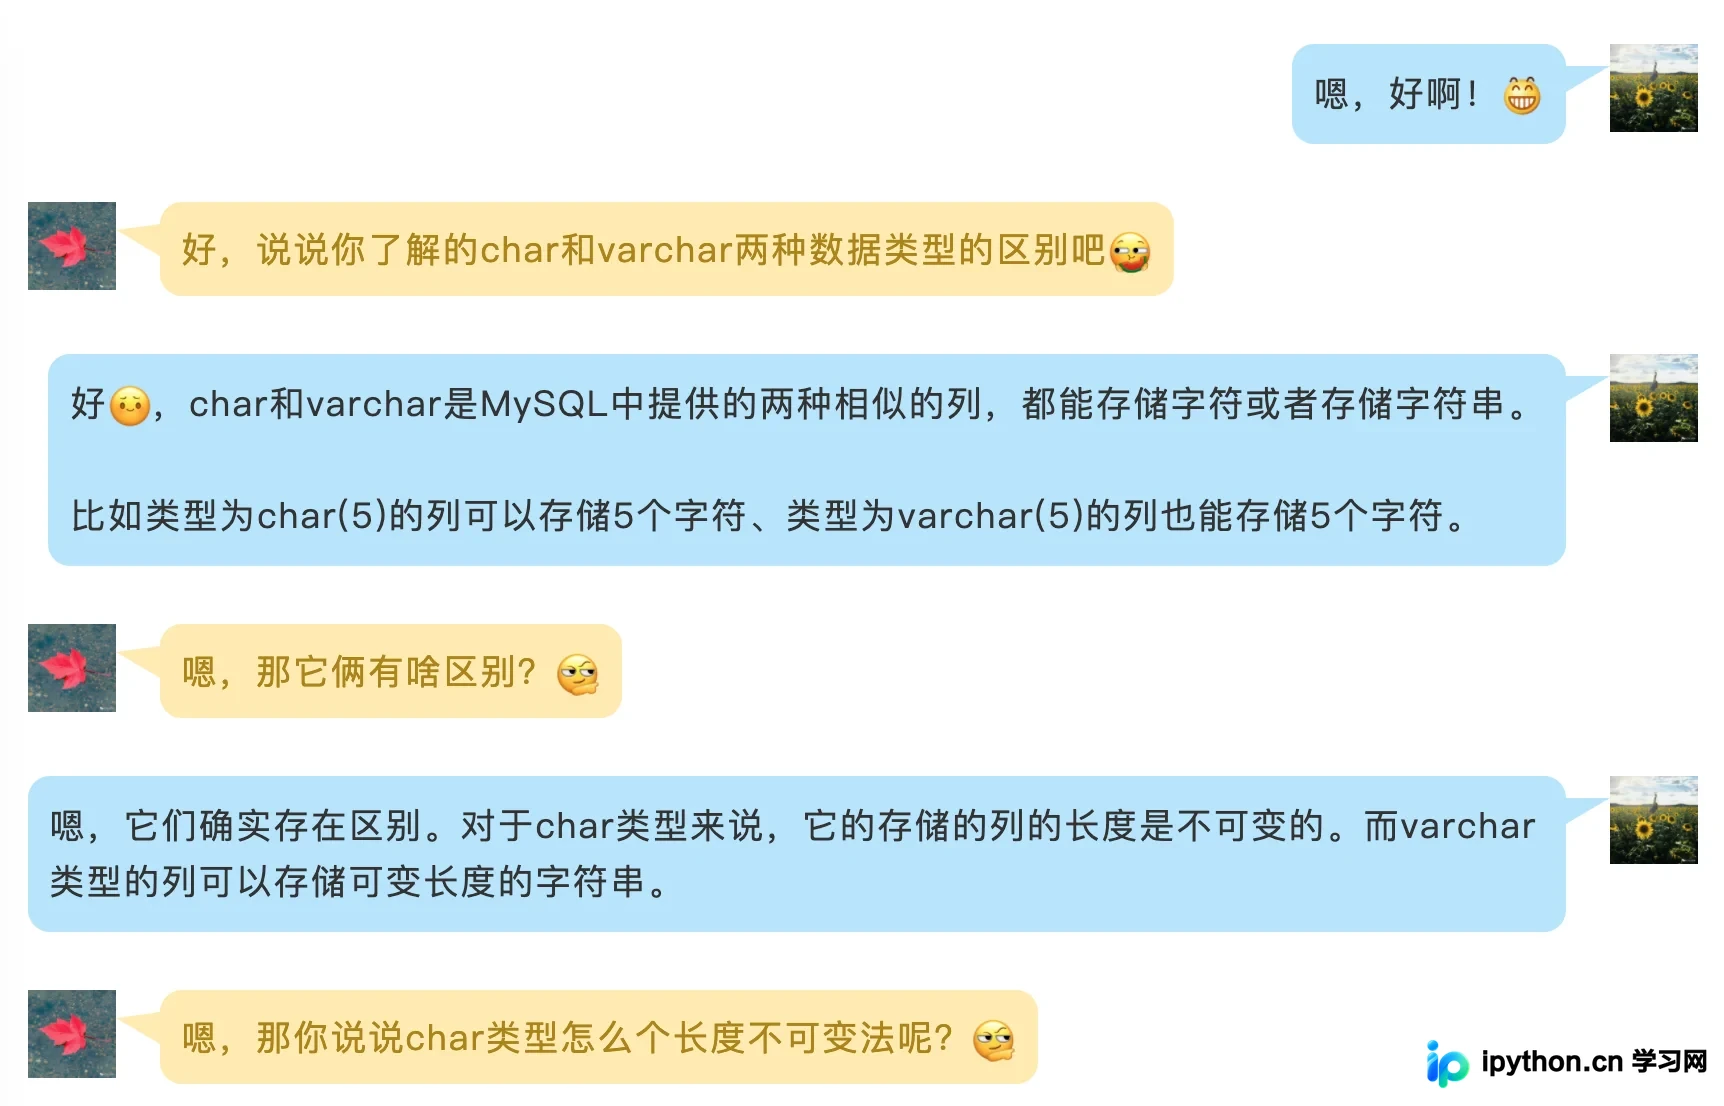
在MySQL开发中,处理重复数据插入是常见需求。本文详细解析INSERT IGNORE、ON DUPLICATE KEY UPDATE和REPLACE INTO三种核心语法的使用场景与差异,涵盖主键与唯一索引前提。同时提供基于CASE WHEN的高效批量更新方法,以及百万级数据的批量插入优化策略,帮助开发者避免错误日志并提升数据写入性能。
本文详细解析MySQL中慢SQL优化的完整流程,涵盖如何开启并查看慢查询日志,通过mysqldumpslow分析高频耗时语句,以及SQL编写层面的核心优化规范。同时探讨慢SQL对数据库I/O资源及应用体验的影响,明确主从架构下的治理优先级,为排查和解决数据库性能瓶颈提供实用思路。