深入解析MySQL InnoDB与MyISAM索引数据结构原理
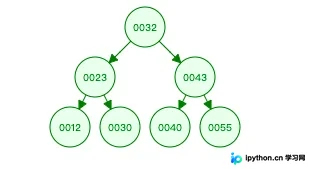
本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。
2026-10-16
5

本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。
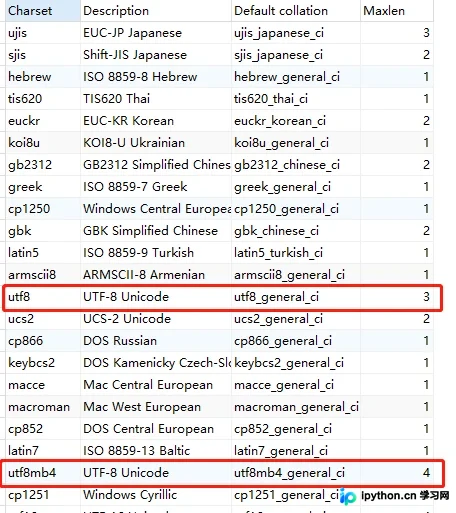
微信昵称等数据常包含 Emoji 表情,导致 MySQL utf8 编码报错。原因在于 MySQL 的 utf8 仅支持最多3字节,而 Emoji 需4字节。将数据库、表及字段的字符集设置为 utf8mb4 即可解决此问题并完整保留特殊字符。
MySQL默认仅允许本地访问,导致远程连接失败。本文总结了三大排查步骤:首先检查防火墙与端口监听;其次修改mysql.user表host或执行GRANT授权以允许特定IP或%访问;最后务必使用FLUSH PRIVILEGES刷新权限并重启服务生效。
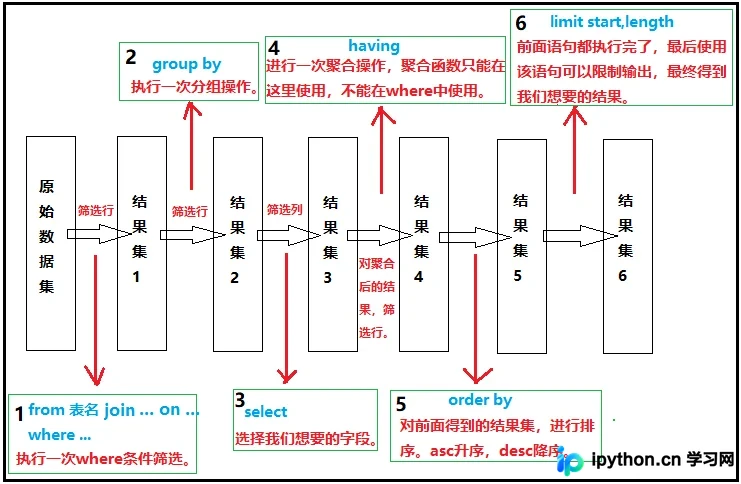
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
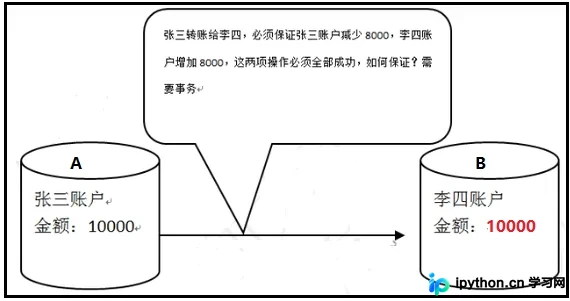
本文深入分析MySQL事务机制对数据库性能的潜在影响,重点解释原子性、一致性、隔离性和持久性原则下的锁等待问题。针对长耗时、大数据量的“大事务”导致的阻塞和主从延迟风险,提供将读取操作移出事务、分批次处理数据等具体优化手段,帮助提升数据库并发效率。
本文详解 MySQL 中如何实现不检索实际数据而是直接进行统计分析。介绍 AVG、COUNT、SUM 等聚合函数的使用方法,重点解析 GROUP BY 子句的嵌套规则、NULL 值处理以及与 HAVING 的区别。结合 ROLLUP 和 ORDER BY 提供完整的分组统计操作示例,帮助开发者快速掌握复杂报表生成的 SQL 编写技巧。
本文详细讲解MySQL服务器的安全管理核心——访问控制。涵盖从最小权限原则出发,通过CREATE USER创建账户,利用GRANT和REVOKE语句进行细粒度的权限分配(包括库、表、列及存储过程级别),以及使用DROP USER清理账号。同时强调严禁在日常操作中滥用root权限,并通过具体SQL示例演示如何配置用户密码及验证授权状态,帮助企业建立规范的数据库安全体系。
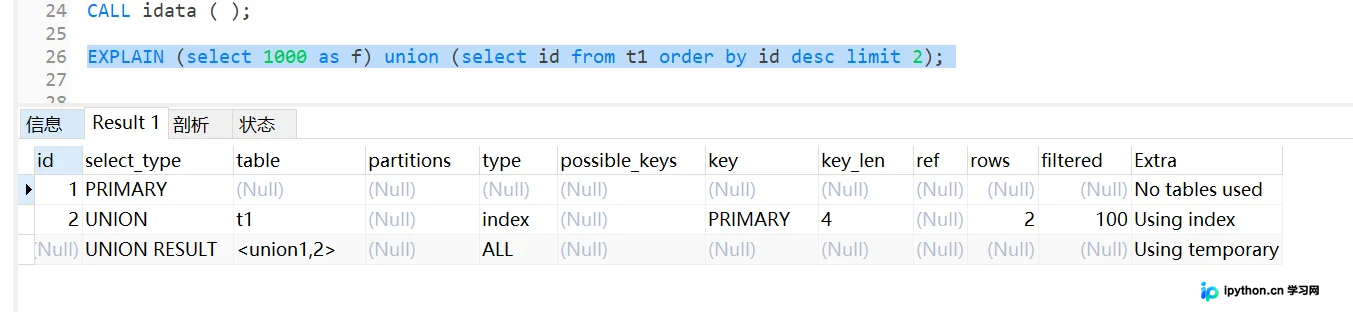
MySQL在特定SQL操作下会创建内部临时表以辅助计算。本文通过具体示例分析两种常见场景:UNION进行结果集去重时,内存临时表存储中间结果并约束主键实现去重;GROUP BY分组聚合时,临时表暂存分组键与计数值,完成后需Filesort排序。当数据量超过tmp_table_size(默认16MB)限制时,临时表将转化为磁盘InnoDB表,影响性能。理解其执行流程有助于优化查询语句。
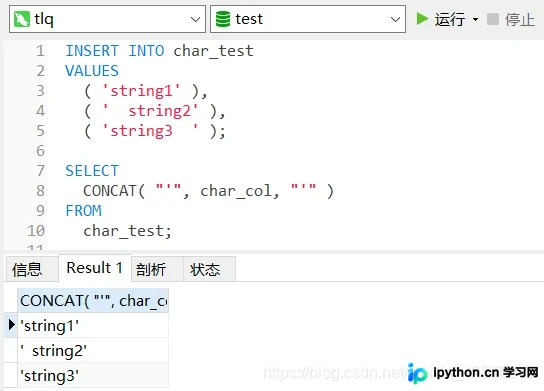
本文深入解析MySQL中CHAR与VARCHAR两种字符串类型的核心差异。CHAR为定长存储,适合短文本及高频更新场景;VARCHAR为变长存储且需额外字节记录长度,节省空间。通过SQL实例对比两者的存储行为,并给出基于数据特征、更新频率及字符集选择的最佳实践建议。
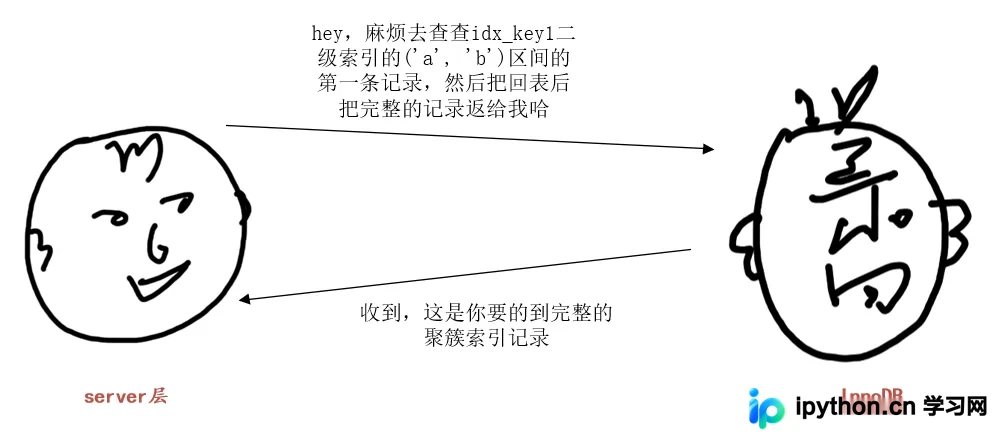
探讨MySQL中LIMIT语句的执行机制,揭示server层与InnoDB存储引擎的交互过程。分析当OFFSET较大时全表扫描的原因,并提供一种利用子查询仅扫描二级索引的高效优化方案,解决深分页性能问题。
本文详细解析MySQL数据操纵语言(DML)的核心操作,涵盖INSERT多方式插入数据、基于WHERE条件的UPDATE更新及DELETE删除技巧。重点对比TRUNCATE与DELETE在清空表时的性能差异与底层机制,并提供表结构复制的SQL实例,帮助开发者掌握高效且安全的数据管理方法。
本文详解MySQL数据库事务的核心概念,包括事务的定义、适用场景及其四大特性(ACID)。深入分析四种隔离级别(读未提交、读已提交、可重复读、串行化)及其解决的问题,并提供设置全局隔离级别及演示各类异常现象的具体SQL命令与操作流程。