

Python StatsModels统计回归模型数据准备与预处理实战
本文详解Python中利用StatsModels进行统计回归分析前的数据准备工作。内容涵盖从CSV、Excel及TXT文件读取数据,使用pandas进行数据拆分合并,以及缺失值、重复值和异常值的预处理方法,并附带完整代码示例。
2026-10-14
6

本文详解Python中利用StatsModels进行统计回归分析前的数据准备工作。内容涵盖从CSV、Excel及TXT文件读取数据,使用pandas进行数据拆分合并,以及缺失值、重复值和异常值的预处理方法,并附带完整代码示例。
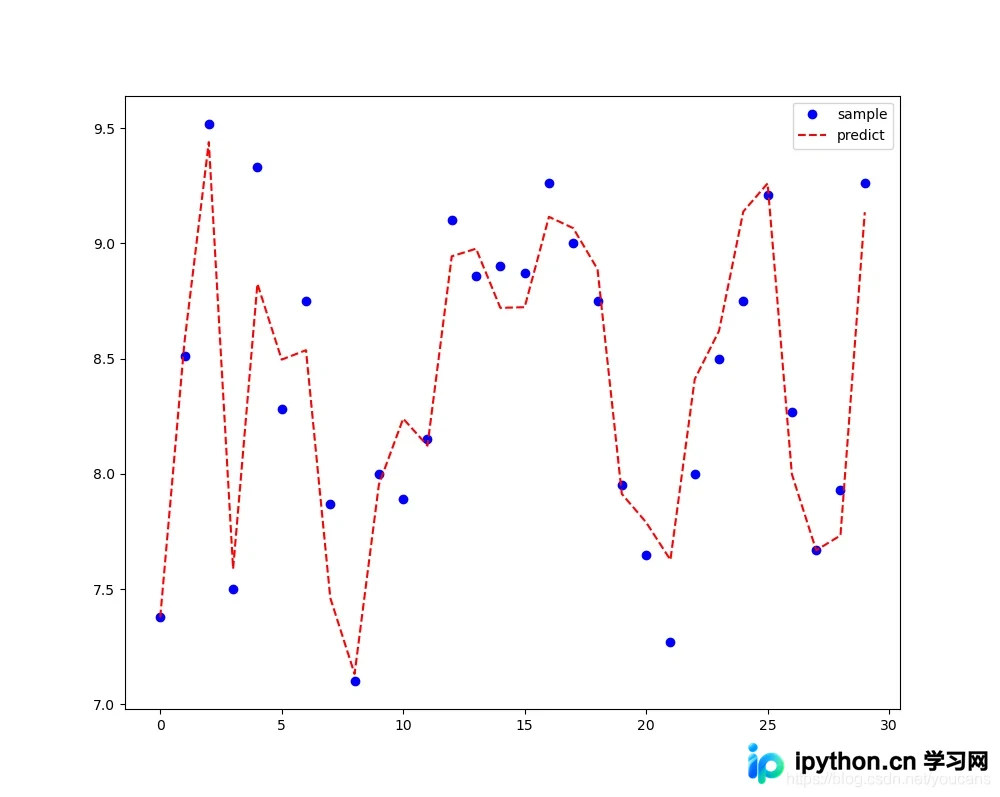
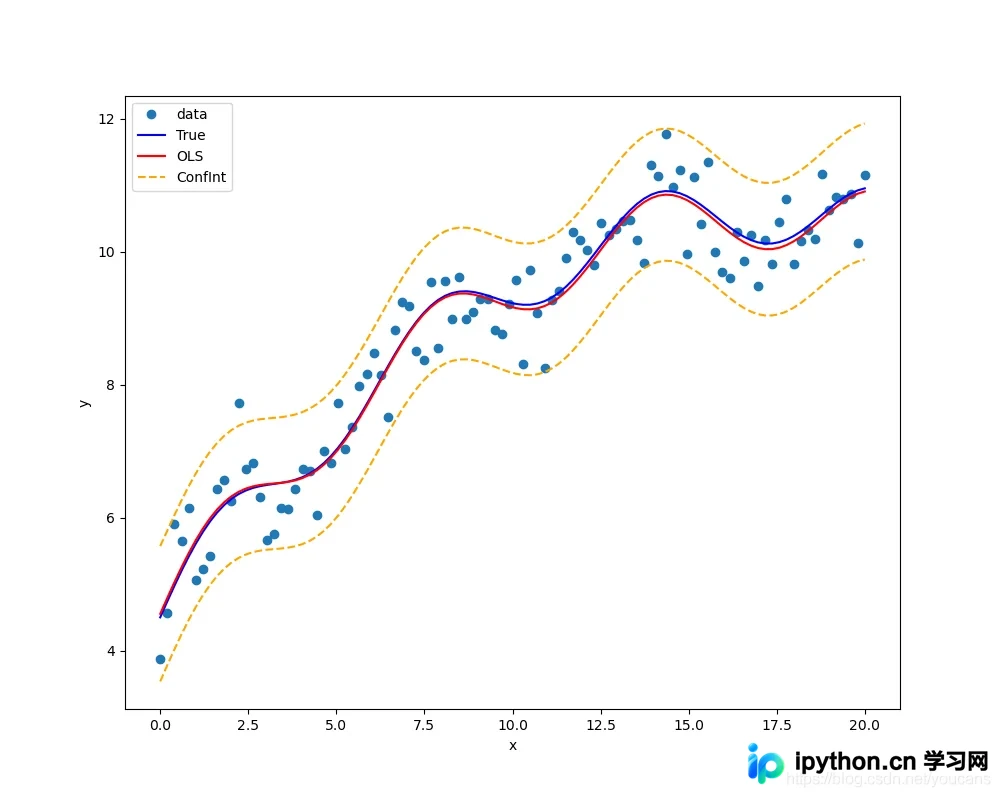
本文详解Python中StatsModels库的线性回归应用。从插值、拟合与回归的概念辨析入手,深入讲解一元及多元线性回归的建模流程。通过完整代码示例展示数据预处理、模型拟合及参数估计过程,并详细解读回归系数、P值、R方等关键统计指标,帮助读者掌握统计回归分析的核心方法。
本文介绍如何利用OpenCV的ml模块中的KNearest算法实现标准数字识别。通过图像预处理、自适应阈值化及轮廓提取构建训练集,保存特征数据后加载模型进行预测。文中提供完整的Python代码示例,涵盖从数据生成到识别输出的全过程,适合OpenCV初学者参考学习。
本文介绍如何在TensorFlow2中通过自定义网络构建复杂结构。详细讲解Sequential容器的使用方法,以及如何继承Model和Layer类实现[[wp:a3]]和[[wp:a4]]来自定义层。结合CIFAR-10数据集案例,展示完整代码实现与训练输出结果,帮助开发者掌握自定义网络结构的技巧。
本文详细介绍TensorFlow2中张量的核心操作,包括使用tf.sort和tf.argsort进行排序,利用tf.pad进行边缘填充,通过tf.tile实现张量复制,以及使用tf.where和tf.scatter_nd进行条件查找与索引更新。涵盖参数说明、代码示例及输出解析,帮助开发者掌握基础张量处理技巧。
本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
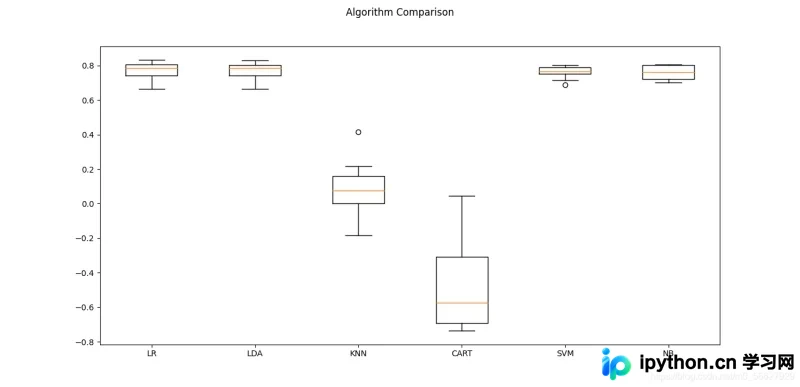
本文详细介绍在Python机器学习项目中如何进行算法审查。通过逻辑回归、LDA、KNN、SVM等分类算法,以及线性、岭、套索、弹性网络等回归算法的对比实验,展示如何利用scikit-learn进行10折交叉验证。文章提供了完整的代码模板和评估结果,帮助开发者科学选择最优算法。
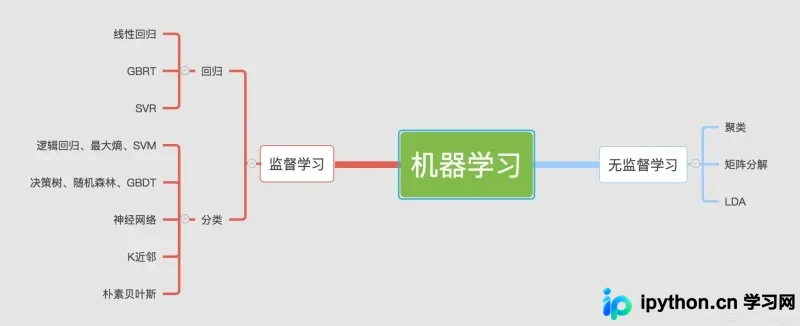
本文作为Python机器学习系列的开篇,系统梳理了机器学习的基本概念、监督与无监督学习的区别,以及基于Python的数据科学生态。重点详解了SciPy、NumPy、Pandas等核心库的作用,并提供了通过清华镜像安装Anaconda及验证环境配置的完整操作步骤,帮助初学者快速搭建开发环境并理解机器学习工作流。
本文深入解析Python机器学习中的数据准备流程,涵盖数据预处理四大核心方法:Min-Max缩放、正态化、标准化及二值化处理,并详细阐述特征选定策略,包括单变量卡方检验、递归特征消除(RFE)、主成分分析(PCA)及基于树模型的特征重要性评估,助力提升模型精度与训练效率。
本文深入解析Python机器学习中的模型评估与数据集分离技术。详细对比了训练集/测试集简单划分、K折交叉验证、弃一交叉验证及重复随机分离四种方法,并探讨了分类准确度、分类报告、平均绝对误差、均方误差及判定系数等核心评估指标,帮助开发者选择最优模型验证策略。
本文提供基于Python和SVM的手写数字识别完整源码。内容涵盖从CSV训练集下载、使用PCA进行特征降维、SVC模型训练与保存,到加载模型对单张手写图片进行预处理和预测的全流程。代码包含详细的参数设置与准确率计算,可直接运行实现识别功能。
本文深入解析Python环境下的模型集成技术,强调模型多样性对提升预测性能的关键作用。详细对比了简单平均与加权平均两种集成策略,并系统介绍了Bagging(挂袋法)、加权提升法及梯度提升法的核心原理与适用场景,为构建更稳定、准确的机器学习模型提供理论依据与实践指导。