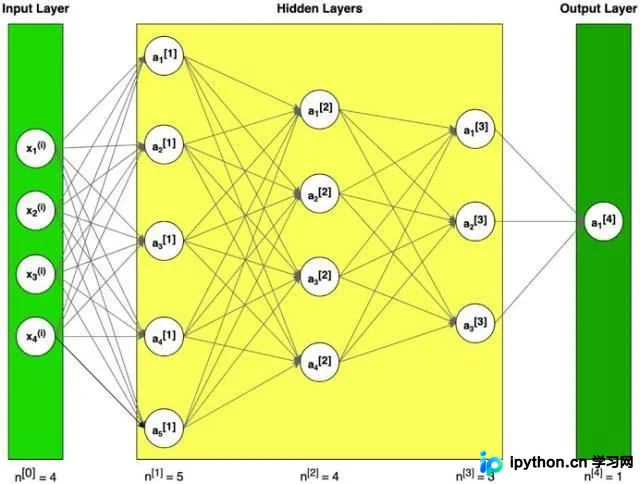
Python构建任意层数深度神经网络:从原理到代码实现
本文详细解析如何使用Python从零构建支持任意层数的深度神经网络。内容涵盖神经网络基础原理、数据集预处理、参数初始化策略、Sigmoid与ReLU激活函数应用,以及正向传播、损失函数计算和反向传播的核心算法。通过完整的Python代码示例,展示如何定义模型架构、执行梯度下降优化及更新参数,帮助开发者掌握深度学习模型构建的关键步骤。
2026-10-14
6

本文详细解析如何使用Python从零构建支持任意层数的深度神经网络。内容涵盖神经网络基础原理、数据集预处理、参数初始化策略、Sigmoid与ReLU激活函数应用,以及正向传播、损失函数计算和反向传播的核心算法。通过完整的Python代码示例,展示如何定义模型架构、执行梯度下降优化及更新参数,帮助开发者掌握深度学习模型构建的关键步骤。
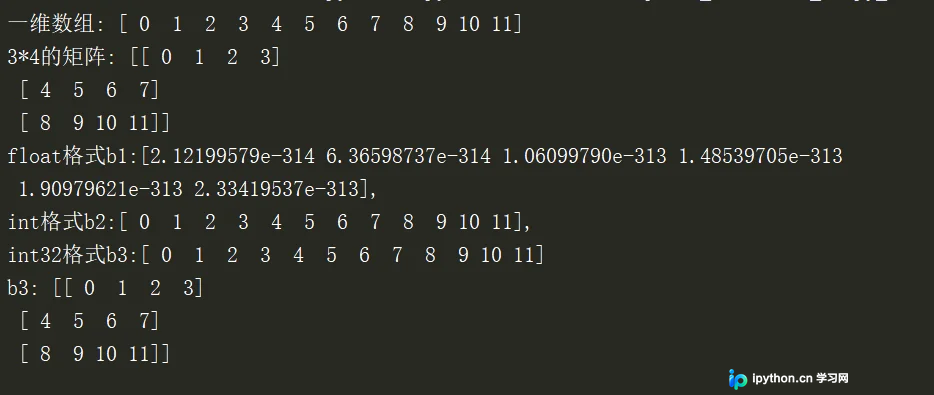
本文详解Python中NumPy库的文件存取方法,涵盖tofile/fromfile二进制读写、save/load保存单一数组及savez保存多数组至npz压缩文件,以及savetxt/loadtxt处理文本与CSV数据。通过代码案例解析各函数特性、参数设置及适用场景,帮助开发者高效管理训练集与模型数据。
本文详解如何利用Python和HanLP库实现基于二元语法的中文分词。通过加载一元与二元语法模型构建词网,并应用Viterbi算法求解最短路径,完成从模型训练到预测解码的完整流程。文章包含核心代码解析与实战测试,展示模型对未见词汇的泛化能力。
本文介绍一种针对固定窗口字符的定制化OCR方案。通过OpenCV进行灰度化、二值化及纵向膨胀处理,结合轮廓查找与外接矩形过滤,实现字符精准分割。利用KNeighborsClassifier构建向量分类模型,无需复杂深度学习即可在特定场景下实现极高识别率。
本文详细解析TensorFlow中反向传播求导的实现机制,结合具体代码示例展示权重更新过程。通过前向计算与反向链式法则推导偏导数,深入讲解梯度下降优化器在模型训练中的应用,帮助开发者理解底层数学原理与框架行为的对应关系。
本文深入解析TensorFlow的自动求导(Automatic Differentiation)原理,阐述其如何结合符号与数值求导优势。重点介绍tf.GradientTape()在即时执行模式下的应用,通过y=x^2实例演示梯度计算流程,并解析math_grad.py中RegisterGradient装饰器的作用,帮助开发者理解模型训练中的梯度反向传播机制。
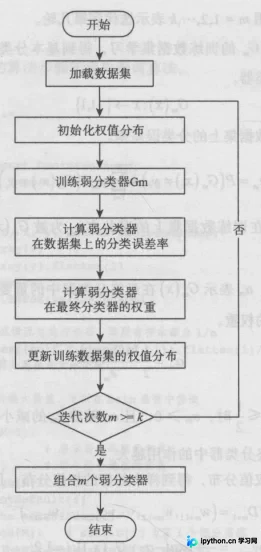
本文深入解析Python中AdaBoost(自适应增强)算法的核心原理与实现步骤。从初始化权值分布到多轮迭代训练弱分类器,详细阐述如何构建强分类器。同时探讨正负样本失衡、过拟合及训练效率等实际问题的优化策略,包括并行计算与多算法结合方案,为机器学习开发者提供完整的算法应用参考。
本文详细介绍如何使用Python和Tensorflow 2.0搭建BP神经网络进行鸢尾花分类。通过加载sklearn数据集,定义输入输出矩阵,利用均方误差作为损失函数,并采用梯度下降算法优化权重w和偏置b。代码涵盖数据预处理、模型训练及测试环节,最终实现高准确率的分类预测。
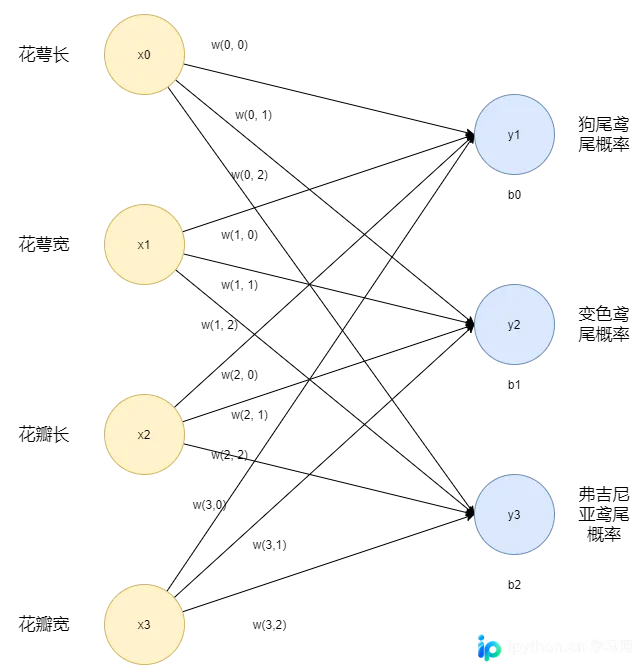
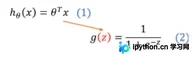
本文详细介绍在Python环境下使用逻辑回归解决二分类问题的完整流程。内容涵盖Sigmoid函数原理、对数损失函数的推导,并对比实现了梯度下降法与牛顿迭代法两种参数优化策略。通过具体实验数据,分析学习率对收敛速度的影响,展示如何计算分类边界及预测录取概率,为机器学习初学者提供从理论到代码的实操指南。
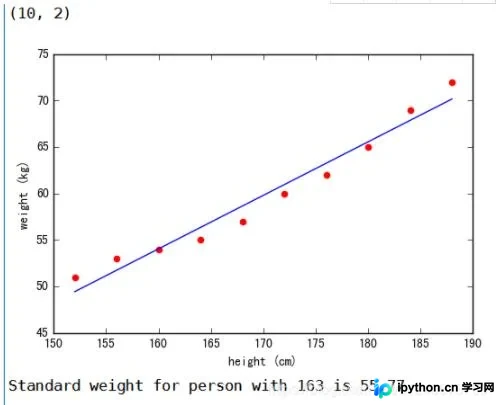
本文详细介绍如何使用Python及sklearn库实现线性回归算法。通过构建包含身高体重数据的NumPy数组,实例化LinearRegression模型并进行训练。代码展示了如何绘制散点图与回归直线,并利用训练好的模型对指定身高进行体重预测,为初学者提供完整的算法落地示例。
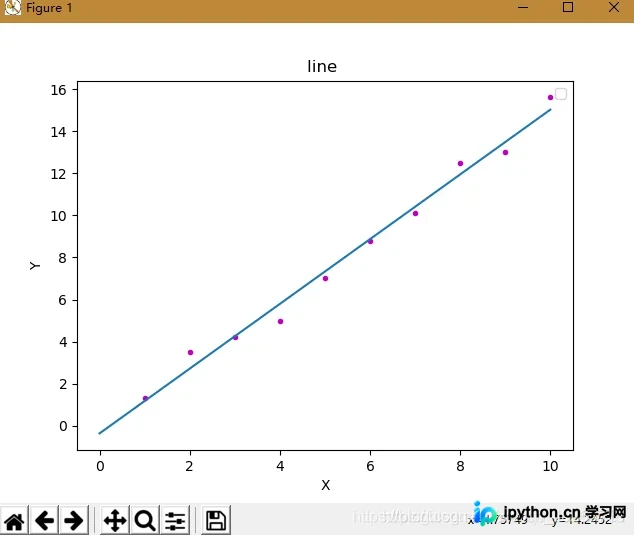
本文深入解析Python中的线性回归模型,涵盖最小二乘法(OLS)的原理与代码实现、梯度下降算法的迭代优化过程,以及多项式回归的特征转换技巧。通过具体代码示例,展示如何利用statsmodels和scikit-learn构建模型,帮助读者掌握从基础线性拟合到非线性多项式处理的完整技术路径。
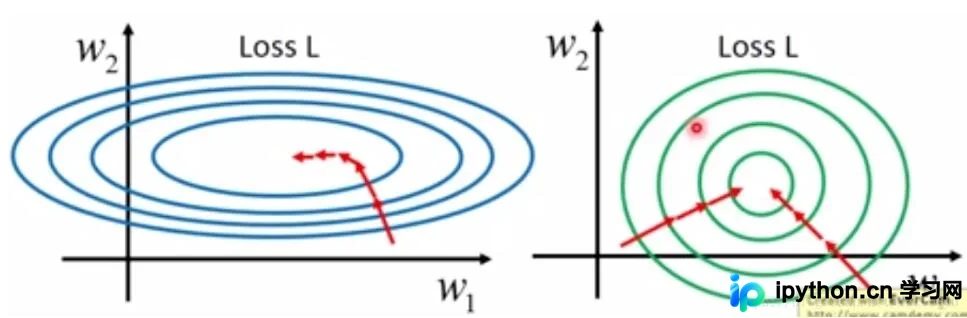
本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。