

Python读取MNIST数据集:.gz与.uncompressed格式实现详解

发布时间:2026-10-14| 4人浏览过
本文详解使用Python从本地读取MNIST手写数字数据集的方法。涵盖.gz压缩格式与解压缩后.ubyte格式的两种读取策略,解析文件头Magic Number与样本数量结构,提供训练集与测试集的完整加载代码及验证步骤,适用于机器学习入门与模型训练准备。
MNIST手写数字数据集在机器学习领域应用广泛,本文记录在Python环境中从本地加载该数据集的具体实现方式。
数据集格式介绍
该部分内容在网络上较为常见,此处仅作简要说明。从网络下载的MNIST数据集通常包含四个文件:
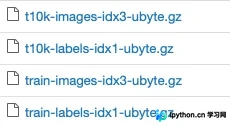
前两个文件分别对应测试集的图像(image)和标签(label),包含10000个样本;后两个文件对应训练集,包含60000个样本。文件后缀为.gz,表示其为压缩包,解压后将得到.ubyte格式的二进制文件。
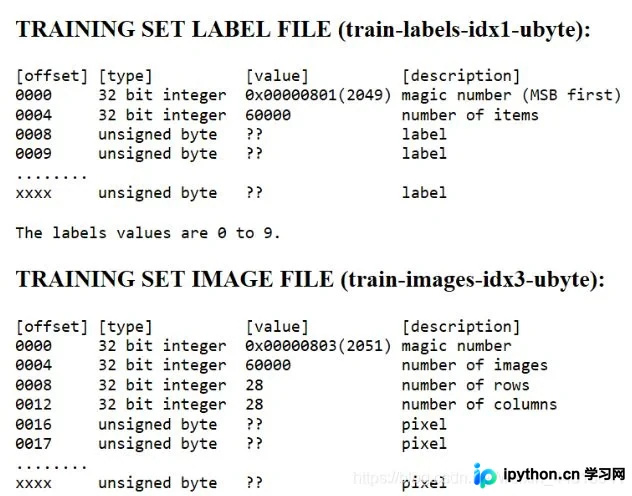
上图展示了训练集中label和image数据的存储结构。两个文件头部均包含magic number(魔数)和number of images/items(样本数量)两个字段,其中样本数量是实际读取时需要的关键信息。此外需注意数据位宽,分为32位整型和8位整型两种情况。
读取方法
.gz格式的文件读取
首先需要导入gzip模块。以下是读取训练集的具体代码实现:
def load_mnist_train(path, kind='train'):
'‘'
path:数据集的路径
kind:值为train,代表读取训练集
‘'‘
    labels_path = os.path.join(path,'%s-labels-idx1-ubyte.gz'% kind)
    images_path = os.path.join(path,'%s-images-idx3-ubyte.gz'% kind)
    #使用gzip打开文件
    with gzip.open(labels_path, 'rb') as lbpath:
	    #使用struct.unpack方法读取前两个数据,>代表高位在前,I代表32位整型。lbpath.read(8)表示一次从文件中读取8个字节
	    #这样读到的前两个数据分别是magic number和样本个数
        magic, n = struct.unpack('>II',lbpath.read(8))
        #使用np.fromstring读取剩下的数据,lbpath.read()表示读取所有的数据
        labels = np.fromstring(lbpath.read(),dtype=np.uint8)
    with gzip.open(images_path, 'rb') as imgpath:
        magic, num, rows, cols = struct.unpack('>IIII',imgpath.read(16))
        images = np.fromstring(imgpath.read(),dtype=np.uint8).reshape(len(labels), 784)
    return images, labels
读取测试集的代码逻辑与上述类似。
非压缩文件的读取
若在本地对四个文件进行解压缩,将获得.ubyte格式的文件,此时读取代码需相应调整。
def load_mnist_train(path, kind='train'):
'‘'
path:数据集的路径
kind:值为train,代表读取训练集
‘'‘
    labels_path = os.path.join(path,'%s-labels-idx1-ubyte'% kind)
    images_path = os.path.join(path,'%s-images-idx3-ubyte'% kind)
    #不再用gzip打开文件
    with open(labels_path, 'rb') as lbpath:
	    #使用struct.unpack方法读取前两个数据,>代表高位在前,I代表32位整型。lbpath.read(8)表示一次从文件中读取8个字节
	    #这样读到的前两个数据分别是magic number和样本个数
        magic, n = struct.unpack('>II',lbpath.read(8))
        #使用np.fromfile读取剩下的数据
        labels = np.fromfile(lbpath,dtype=np.uint8)
    with gzip.open(images_path, 'rb') as imgpath:
        magic, num, rows, cols = struct.unpack('>IIII',imgpath.read(16))
        images = np.fromfile(imgpath,dtype=np.uint8).reshape(len(labels), 784)
    return images, labels
读取完成后,可通过检查images和labels的长度来确认数据读取是否正确。
至此,关于Python读取MNIST数据集方法的案例详解介绍完毕。如需了解更多相关内容,建议搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









