

Python机器学习入门(二)之Python数据理解

本文详解Python机器学习中的数据理解环节,涵盖使用Python标准库、Numpy及Pandas导入CSV数据的方法,重点推荐Pandas。通过查看前10行、维度、类型及描述性统计深入理解数据,并利用相关矩阵和高斯分布分析特征关系,最后借助Matplotlib进行直方图、密度图等可视化操作,为模型构建奠定基础。
统计学依托概率与数学工具,旨在量化分析人群特征,其结论并非对个体行为的直接描述。若将群体统计结果直接套用于个体决策,易产生认知偏差。因此,在数据分析中,对数据的深入解读往往比单纯的技术实现更为关键。
——刘德寰
1.数据导入
机器学习模型的训练通常依赖海量历史数据,其中CSV格式因其通用性成为最常用的存储方式。在启动机器学习项目之初,首要步骤是将存储在CSV文件中的数据成功导入至Python环境中。
CSV(逗号分隔值)文件是一种以逗号作为字段分隔符的纯文本格式。在该文件中,以井号(#)开头的行通常被识别为注释内容。
后续示例将采用来自UCI机器学习仓库的Pima Indians数据集(下载地址:https://archive.ics.uci.edu/ml/index.php),也可通过百度网盘获取(链接:https://pan.baidu.com/s/1nv2xuVpXWHC1HUdS1c5QaQ,提取码:d4im)。
Pima Indians数据集属于分类问题范畴,主要记录了印第安人过去五年内的糖尿病患病情况及相关医疗指标。
1.1使用标准Python类库导入数据
Python内置了标准的CSV类库,专门用于处理CSV格式的文件读写操作。
from csv import reader

#python标准库导入数据

filename = 'pima_data.csv'
with open(filename, 'rt') as raw_data:
    readers = reader(raw_data, delimiter=",")
    x = list(readers)
    data = np.array(x).astype('float')
    print(data.shape)
相关代码实现较为直观,此处不再赘述具体语法细节。
运行结果:
(768, 9)
1.2使用Numpy导入数据
利用Numpy库中的loadtxt()函数可以高效导入数据。需注意,该函数处理的数据文件不应包含文件头,且所有字段的数据类型必须保持一致。
import numpy as np
#使用Numpy导入数据
from numpy import loadtxt
filename = 'pima_data.csv'
with open(filename, 'rt') as raw_data:
    data = loadtxt(raw_data, delimiter=',')
    print(data.shape)
在loadtxt函数中,第一个参数指定数据文件路径,第二个参数定义字段分隔符。
输出结果与前述方法一致。
(768, 9)
1.3使用Pandas导入数据
使用Pandas库导入CSV文件需调用pandas.read_csv()函数,该函数返回一个DataFrame对象。鉴于Pandas在机器学习数据预处理中的核心地位,强烈建议使用此方法导入数据。
#推荐使用!!!!
#使用Pandas导入数据
from pandas import read_csv
filename = 'pima_data.csv'
names = ['preg', 'plas', 'pres', 'skin', 'test', 'mass', 'pedi', 'age', 'class']
#设置文件头
data = read_csv(filename, names=names)
print(data.shape)
print(data.head(10))
使用Pandas导入数据时,可以指定文件头信息,这有助于后续的数据解析与理解。read_csv()方法主要接受两个参数:文件名以及文件头字段名称数组。
输出结果与前述方法一致。
(768, 9)
2.数据理解
为了获得更精准的模型预测结果,必须深入理解数据的特征分布及所解决的具体问题,从而构建并优化相应的算法模型。
2.1数据基本属性
对数据进行初步审视是加深理解的最有效途径之一。通过观察数据,可以发现其内在关联与规律,这些发现对后续的数据整理和清洗至关重要。
2.1.1查看前10行数据
本例继续使用Pima Indians数据集:
from pandas import read_csv

filename = 'pima_data.csv'
names = ['preg','plas','pres','skin','test','mass', 'pedi','age','class']
data = read_csv(filename,names=names)
#查看前十行数据
print(data.head(10))
首先利用Pandas导入数据集,随后通过print函数调用data的head属性,以查看前10行数据内容。
输出结果:
preg plas pres skin test mass pedi age class 0 6 148 72 35 0 33.6 0.63 50 1 1 1 85 66 29 0 26.6 0.35 31 0 2 8 183 64 0 0 23.3 0.67 32 1 3 1 89 66 23 94 28.1 0.17 21 0 4 0 137 40 35 168 43.1 2.29 33 1 5 5 116 74 0 0 25.6 0.20 30 0 6 3 78 50 32 88 31.0 0.25 26 1 7 10 115 0 0 0 35.3 0.13 29 0 8 2 197 70 45 543 30.5 0.16 53 1 9 8 125 96 0 0 0.0 0.23 54 1
2.1.2查看数据维度,数据属性和类型:
'''
数据维度
'''
#查看数据维度
#通过DATa Frame的shape属性来查看数据集中有多少行多少列
print(data.shape)


'''
数据属性和类型
'''
#查看数据属性和类型
#通过DATa Frame的Type属性来查看每一个字段的数据类型
print(data.dtypes)
运行结果:
(768, 9) preg int64 plas int64 pres int64 skin int64 test int64 mass float64 pedi float64 age int64 class int64 dtype: object
2.1.3查看数据描述性统计
利用DataFrame的describe()方法可查看数据的描述性统计信息,包括数据记录数量、平均值、标准差、最小值、下四分位数、中位数、上四分位数及最大值。(此处省略前文读取数据的部分代码)
from pandas import set_option

'''
描述性统计
'''
#通过DATa frame的describe()方法来查看描述性统计
#数据记录数、平均住、标准方差、最小值、下四分位数、中位数、上四分位数、最大值
set_option('display.width',100)
#设置数据的精确度
set_option('precision',2)
print("数据描述性分析:")
print(data.describe())
运行结果:
数据描述性分析: preg plas pres skin test mass pedi age class count 768.00 768.00 768.00 768.00 768.00 768.00 768.00 768.00 768.00 mean 3.85 120.89 69.11 20.54 79.80 31.99 0.47 33.24 0.35 std 3.37 31.97 19.36 15.95 115.24 7.88 0.33 11.76 0.48 min 0.00 0.00 0.00 0.00 0.00 0.00 0.08 21.00 0.00 25% 1.00 99.00 62.00 0.00 0.00 27.30 0.24 24.00 0.00 50% 3.00 117.00 72.00 23.00 30.50 32.00 0.37 29.00 0.00 75% 6.00 140.25 80.00 32.00 127.25 36.60 0.63 41.00 1.00 max 17.00 199.00 122.00 99.00 846.00 67.10 2.42 81.00 1.00
2.2数据相关性和分布分析
2.2.1数据相关矩阵
数据属性的相关性反映了两个属性之间是否存在相互影响及其影响方式。通常使用皮尔逊相关系数来衡量这种关联性,其取值范围在(-1,1)之间。当属性间存在高相关性时,部分算法(如线性回归、逻辑回归等)的性能可能会下降,因此需要检查数据的相关性。使用Data Frame的corr()方法来计算数据属性之间的相关矩阵。
print("数据属性的相关性:")
print(data.corr(method='pearson'))
结果如下:
数据属性的相关性: preg plas pres skin test mass pedi age class preg 1.00 0.13 0.14 -0.08 -0.07 0.02 -0.03 0.54 0.22 plas 0.13 1.00 0.15 0.06 0.33 0.22 0.14 0.26 0.47 pres 0.14 0.15 1.00 0.21 0.09 0.28 0.04 0.24 0.07 skin -0.08 0.06 0.21 1.00 0.44 0.39 0.18 -0.11 0.07 test -0.07 0.33 0.09 0.44 1.00 0.20 0.19 -0.04 0.13 mass 0.02 0.22 0.28 0.39 0.20 1.00 0.14 0.04 0.29 pedi -0.03 0.14 0.04 0.18 0.19 0.14 1.00 0.03 0.17 age 0.54 0.26 0.24 -0.11 -0.04 0.04 0.03 1.00 0.24 class 0.22 0.47 0.07 0.07 0.13 0.29 0.17 0.24 1.00
2.2.2数据分布分析
通过分析数据的高斯分布情况,可以确认数据的偏离程度。使用Data Frame的skew()方法来计算所有数据属性的高斯分布偏离情况。
print("数据的高斯分布偏离情况:")
print(data.skew())
结果如下:
数据的高斯分布偏离情况: preg 0.90 plas 0.17 pres -1.84 skin 0.11 test 2.27 mass -0.43 pedi 1.92 age 1.13 class 0.64 dtype: float64
3.数据可视化
对数据进行理解最快、最有效的方式是通过数据的可视化。我们将使用Matplotlib库来可视化数据,以便更直观地理解数据特征。
3.1单一图表
3.1.1直方图
直方图在数据分析中使用广泛,此处不再做过多介绍。
from pandas import read_csv
import matplotlib.pyplot as plt

filename = 'pima_data.csv'
names = ['preg','plas','pres','skin','test','mass', 'pedi','age','class']
data = read_csv(filename,names=names)

'''
直方图
'''
data.hist()
plt.show()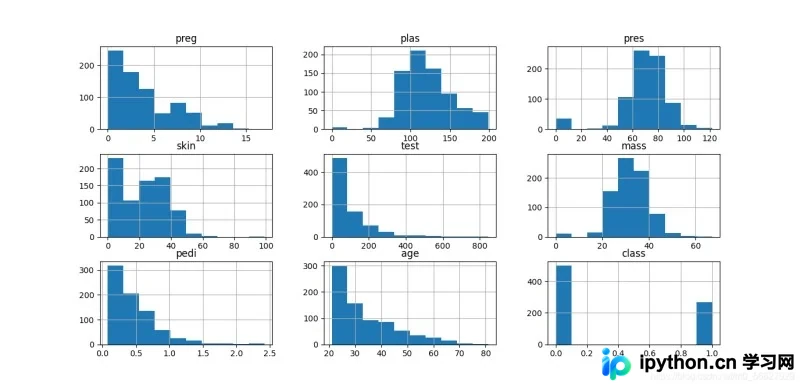
3.1.2密度图
密度图是一种表现与数据值对应的边界或域对象的图形表示方法,一般用于呈现连续变量。密度图类似于对直方图进行抽象,用平滑的线来描述数据的分布情况。
'''
密度图
'''
data.plot(kind='density',subplots=True,layout=(3,3),sharex=False,sharey=False)
plt.show()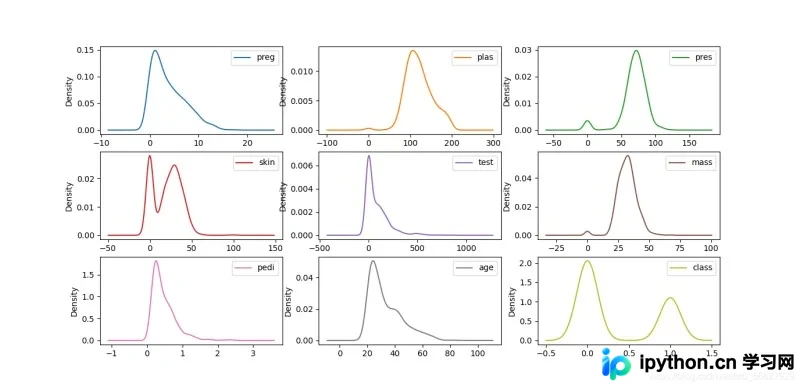
3.1.3箱线图
箱线图又称盒须图、盒式图或箱行图,是一种用于显示一组数据分散情况的统计图表。
'''
箱线图
'''
data.plot(kind='box',subplots=True,layout=(3,3),sharex=False,sharey=False)
plt.show()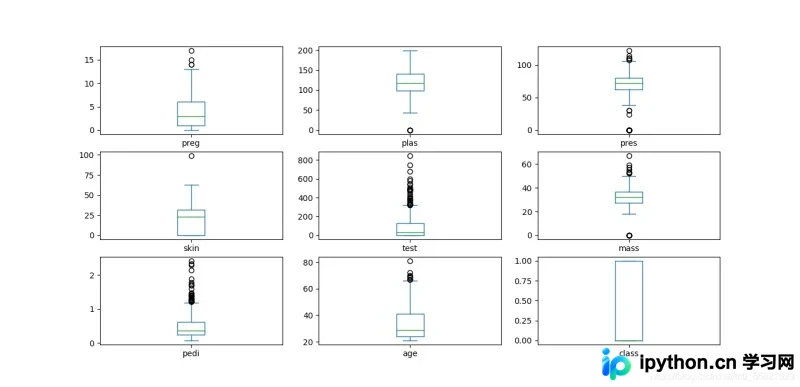
3.2多重图表
3.2.1相关矩阵图
from pandas import read_csv
import matplotlib.pyplot as plt
import numpy as np

filename = 'pima_data.csv'
names = ['preg','plas','pres','skin','test','mass','pedi','age','class']
data = read_csv(filename,names=names)

#相关矩阵图
correlations = data.corr()
fig = plt.figure()
ax = fig.add_subplot(111)
cax = ax.matshow(correlations, vmin=-1, vmax=1)
fig.colorbar(cax)
ticks = np.arange(0,9,1)
ax.set_xticks(ticks)
ax.set_yticks(ticks)
ax.set_xticklabels(names)
ax.set_yticklabels(names)
plt.show()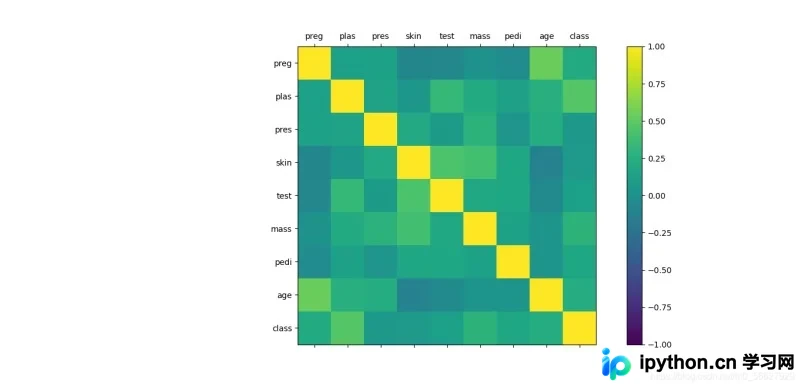
3.2.2散点矩阵图
from pandas import read_csv
import matplotlib.pyplot as plt
import numpy as np
from pandas.plotting import scatter_matrix

filename = 'pima_data.csv'
names = ['preg','plas','pres','skin','test','mass','pedi','age','class']
data = read_csv(filename,names=names)

scatter_matrix(data)
plt.show()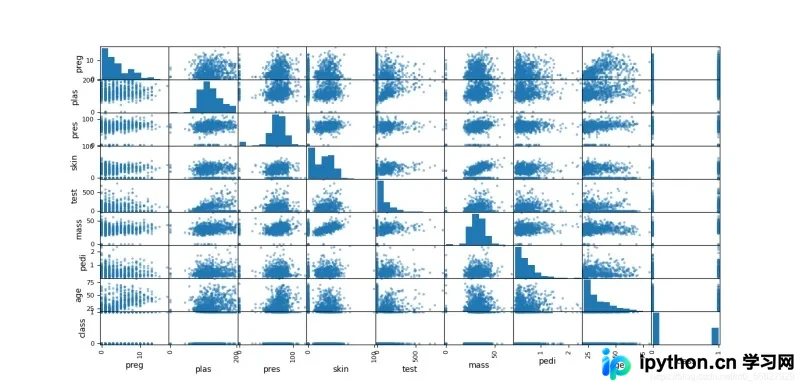
总结
本文主要介绍了机器学习项目启动前的准备工作,包括数据导入、数据理解和数据可视化。数据导入有三种方法:Python标准库函数、Numpy和Pandas导入,其中推荐使用Pandas导入CSV文件。数据理解部分涵盖了查看数据基本属性、相关矩阵以及高斯分布情况。数据可视化方面,主要介绍了Matplotlib库的一些常用绘图方法。
到此这篇关于Python机器学习(二)数据理解的文章就介绍到这了,更多相关Python机器学习(二)内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









