

Python主要应用在哪些领域?数据科学、Web开发与自动化场景解析

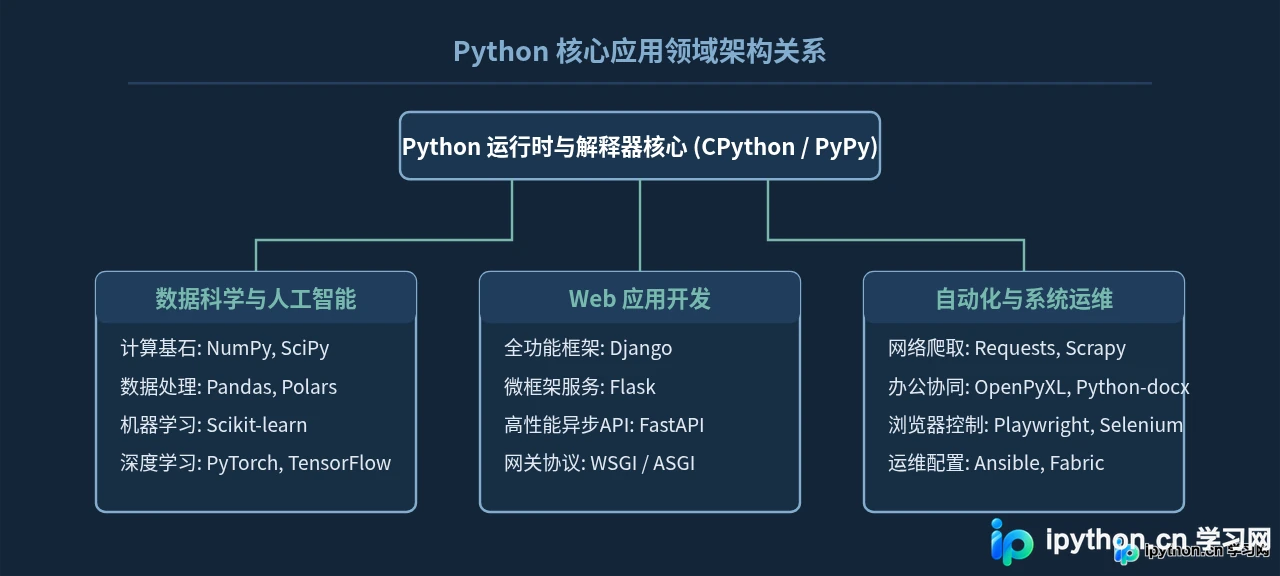
一、全景认知:三大支柱的技术分布与关系
Python的设计哲学强调语法清晰与高可读性,但它作为解释型语言,单核执行纯代码的速度并不占优。它之所以能在工业界大范围普及,关键在于“胶水语言”的能力:底层通过C或C++编写高性能计算与网络驱动,上层封装出易用的Python API。这使得它在不同场景中承担着明确的分工角色。
二、数据科学与机器学习:从数据清洗到模型推理
在数据科学领域,Python解决的核心问题是“如何从杂乱无章的原始数据中提取结构化信息,并转化为业务决策依据或算法模型”。无论是金融机构的风控建模,还是互联网产品的用户行为归因,整个闭环都可以使用一套连贯的工具链完成。
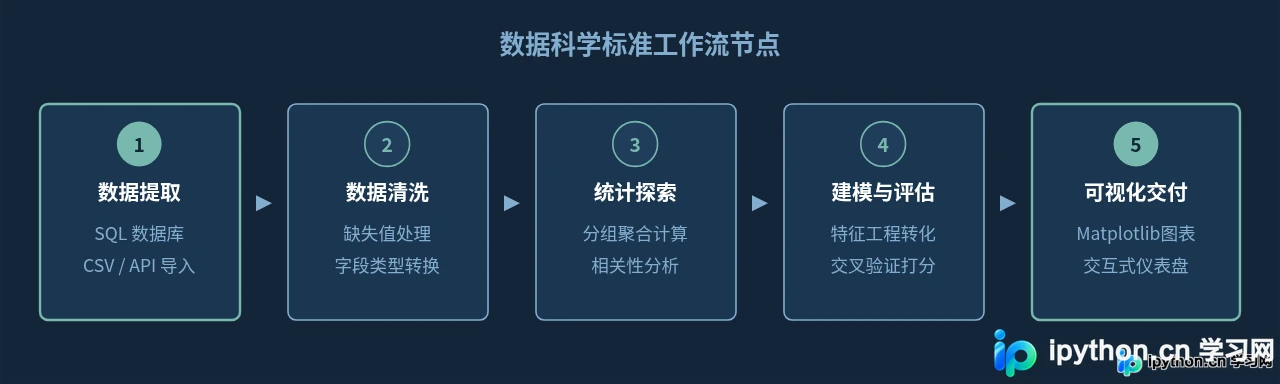
1. 典型分析流:五步数据处理闭环
真实业务场景下的数据极少是开箱即用的,往往存在缺失项、格式不一致或重复记录。标准分析流程通常按序包含五个阶段:
2. 实操代码:利用 Pandas 统计各品类销售数据
以下代码演示如何在一个完整的运行单元中处理包含缺失值的销售数据,并计算各品类的销售总额与退货率。
import pandas as pd
import numpy as np

# 1. 模拟原始订单数据(包含缺失值和异常状态)
raw_data = {
    'order_id': [1001, 1002, 1003, 1004, 1005, 1006],
    'category': ['电子产品', '家居', '电子产品', '服装', '家居', '电子产品'],
    'sales_amount': [1200.0, 350.0, np.nan, 180.0, 420.0, 899.0],
    'is_returned': [False, False, False, True, False, True]
}

df = pd.DataFrame(raw_data)

# 2. 清洗:使用同品类中位数填充缺失金额
median_electronic = df[df['category'] == '电子产品']['sales_amount'].median()
df['sales_amount'] = df['sales_amount'].fillna(median_electronic)

# 3. 聚合分析:计算品类销售额总和与退货率
summary = df.groupby('category').agg(
    total_sales=('sales_amount', 'sum'),
    return_rate=('is_returned', 'mean')
).reset_index()

# 4. 格式化输出
summary['return_rate'] = (summary['return_rate'] * 100).round(1).astype(str) + '%'
print(summary)
执行该脚本后的示例输出如下:
0 家居 770.0 0.0%
1 服装 180.0 100.0%
2 电子产品 3148.5 33.3%
pd.read_csv(..., chunksize=10000) 进行分块迭代,或转向底层采用Rust编写的 polars 库。
三、Web应用开发:主流框架与架构分层
Python在Web领域主要用于服务端开发。浏览器端依然使用HTML、CSS和JavaScript,Python负责处理HTTP请求、解析业务逻辑、与数据库交互并返回JSON接口或渲染好的页面。
1. 三大主流后端框架的技术特征
| 框架名称 | 架构类型 | 原生内置功能 | 最适合的业务场景 |
|---|---|---|---|
| Django | 全栈巨石型 (Batteries-Included) | ORM、身份认证、Admin后台管理、表单校验、CSRF防护 | 中大型管理系统、内容发布平台、需要自带后台的企业级项目 |
| Flask | 轻量微框架 (Micro-framework) | 路由分发、请求上下文、Jinja2模板引擎 | 小型微服务、原型验证、高度自由定制的定制化接口 |
| FastAPI | 现代异步框架 (基于ASGI) | 基于Pydantic的类型检查、自动生成OpenAPI(Swagger)文档 | 高并发API网关、AI/机器学习模型推理服务接口 |
2. 实操代码:使用 FastAPI 构建带参数校验的 REST 接口
FastAPI充分利用了现代Python的类型标注(Type Hints),在接收请求的同时自动完成数据验证、类型转换和文档生成。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

app = FastAPI(title="用户报销单提交流程")

# 定义数据结构模型,具备自动化校验约束
class ExpenseItem(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="报销款项名称")
    amount: float = Field(..., gt=0, description="报销金额,必须大于0")
    department: str = Field(default="研发部", description="归属部门")

@app.post("/api/v1/expenses")
async def create_expense(item: ExpenseItem):
    # 模拟业务边界校验
    if item.amount > 50000.0:
        raise HTTPException(status_code=400, detail="单笔金额超过上限,需走特殊审批流")

    # 模拟数据持久化成功
    saved_record = {
        "status": "success",
        "data": item.model_dump(),
        "assigned_reviewer": "财务主管"
    }
return saved_record启动服务命令:uvicorn main:app --reload --port 8000。使用 curl 发送异常负数金额请求时的返回示例:
{"detail":[{"type":"greater_than","loc":["body","amount"],"msg":"Input should be greater than 0","input":-100}]}
四、自动化场景:办公协同与系统运维
自动化是Python最立竿见影的应用方向。它不要求用户构建庞大的系统架构,往往只需编写30~50行脚本,就能替代原本需要人工重复点按数小时的操作。
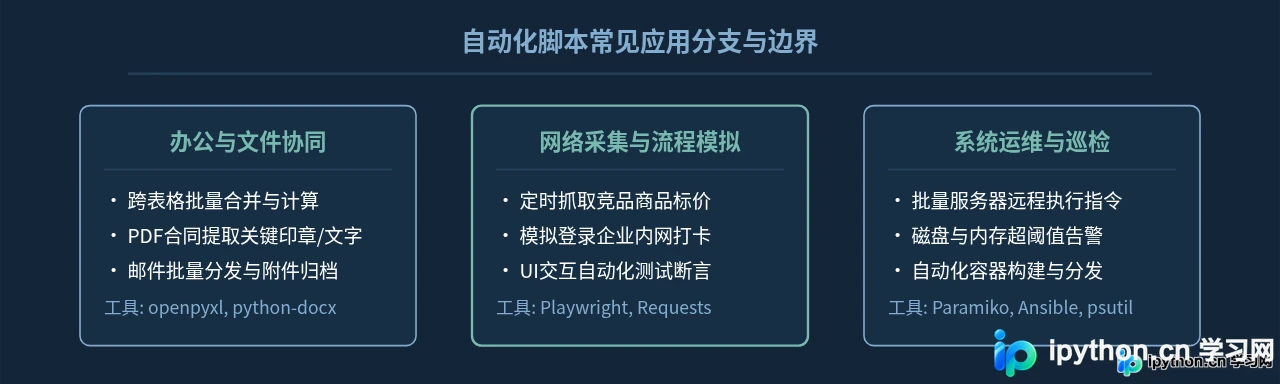
1. 实操代码:利用内置库与 Requests 完成服务器运行状态监控与告警
无需复杂的监控平台,一段简短的脚本即可实现对磁盘空间的周期巡检。当剩余空间低于设定安全水位时,自动向企业通讯机器人发送告警通知。
import shutil
import json
import urllib.request

# 1. 检查根分区磁盘使用情况
total, used, free = shutil.disk_usage("/")
free_gb = free // (2**30)
free_percent = (free / total) * 100

print(f"磁盘巡检结果: 剩余 {free_gb} GB, 可用比例 {free_percent:.1f}%")

# 2. 告警阈值判断(假设阈值为少于 15% 可用)
ALERT_THRESHOLD_PERCENT = 15.0

if free_percent < ALERT_THRESHOLD_PERCENT:
    webhook_url = "https://example.com/robot/send?key=mock-key"
    payload = {
        "msgtype": "text",
        "text": {
            "content": f"【告警】服务器根分区剩余空间不足 {ALERT_THRESHOLD_PERCENT}%!当前仅剩: {free_gb} GB ({free_percent:.1f}%)"
        }
    }

    req = urllib.request.Request(
        webhook_url,
        data=json.dumps(payload).encode('utf-8'),
        headers={'Content-Type': 'application/json'}
    )
    # 本地演示:打印告警体(生产环境下通过 urllib.request.urlopen(req) 触发)
    print("已触发告警推送 Payload:", payload["text"]["content"])
else:
print("系统状态健康,无需推送告警。")robots.txt 协议,并在请求头中补充合法的 User-Agent,避免高频并发对生产接口造成负载压迫。
五、技术选型与适用边界总结
尽管Python覆盖面极广,但在选择技术栈时,必须明确其适用边界与劣势场景。
- 不适合的场景:对执行延迟有微秒级硬要求的场景(如高频交易引擎、操作系统内核、3D物理引擎渲染管线),以及移动端原生APP(iOS/Android应用开发通常优先选用Swift、Kotlin或Flutter)。
- 适合的场景:业务逻辑经常变动、需要极高开发交付速度、依赖丰富第三方算法或机器学习模型集成的工程项目。
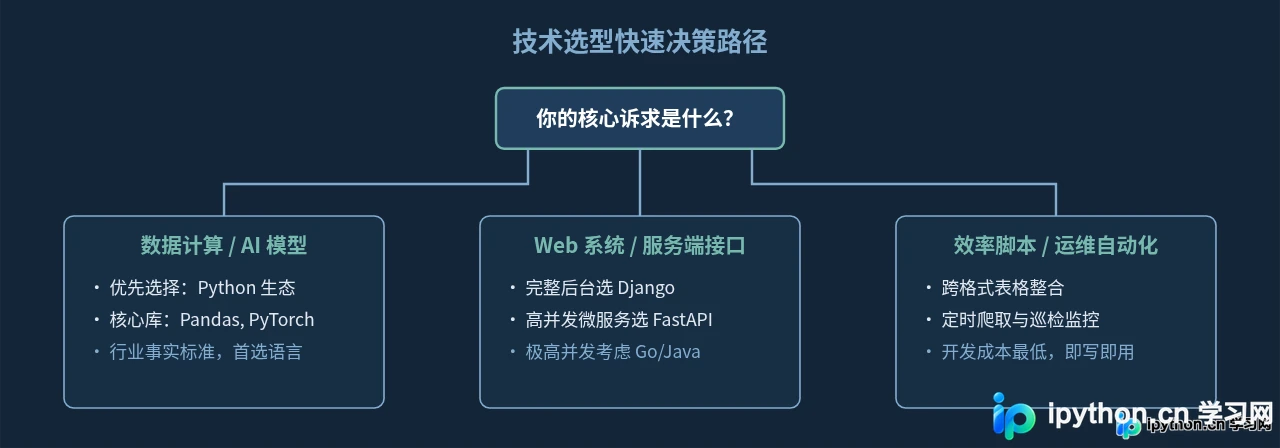
综合来看,Python的优势并非单点性能的绝对胜出,而是它在“开发效率、成熟工具库、跨领域协同”三者间达成了极佳的平衡。无论是作为主开发语言构建Web服务与数据系统,还是作为辅助脚本解决重复劳动,理解这三个主要领域的边界与工作流,都能帮助开发者快速匹配到合适的解决方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









