

Python可视化实现KNN算法详解
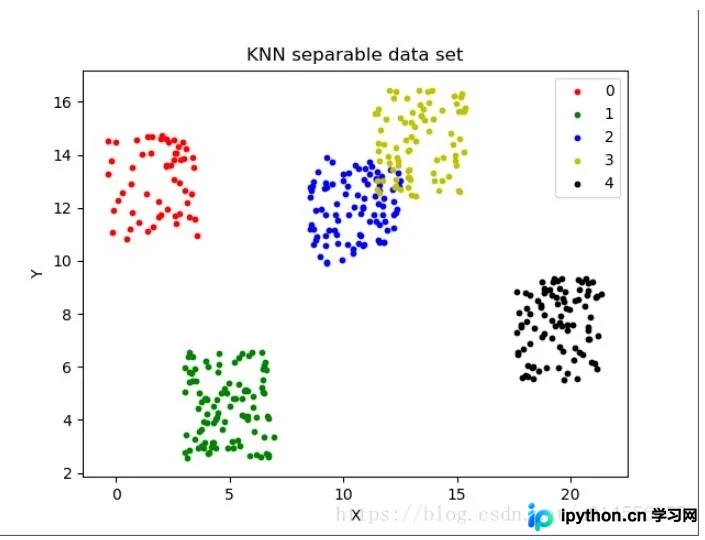
本文通过Python的Matplotlib和Numpy库,详细演示如何可视化实现KNN(最近邻)分类算法。内容涵盖算法核心逻辑、模拟数据集生成、数据可视化展示以及完整的KNN分类代码实现,帮助读者直观理解机器学习基础算法原理。
2026-10-13
6

本文通过Python的Matplotlib和Numpy库,详细演示如何可视化实现KNN(最近邻)分类算法。内容涵盖算法核心逻辑、模拟数据集生成、数据可视化展示以及完整的KNN分类代码实现,帮助读者直观理解机器学习基础算法原理。
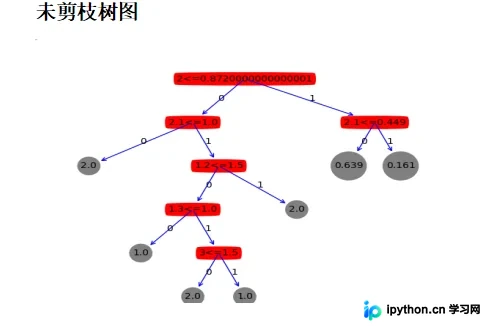
本文详细解析Python中决策树剪枝算法的实现。涵盖ID3算法基于信息熵的分裂逻辑,以及CART算法采用基尼指数进行二元划分的机制。通过完整代码示例,展示如何计算香农熵、处理连续变量划分,并实现预剪枝与后剪枝策略,帮助开发者掌握机器学习核心算法的底层实现。
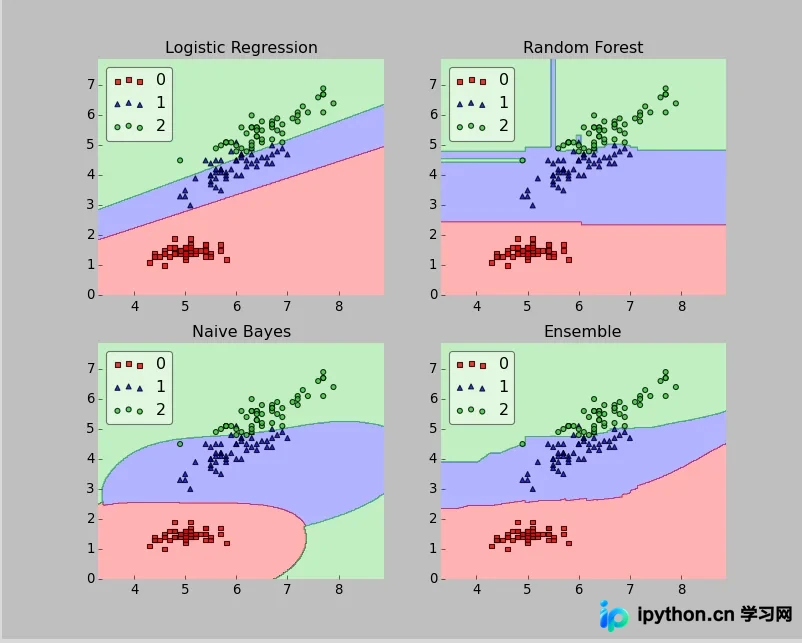
本文详细介绍Python机器学习库mlxtend的安装与配置过程。涵盖基础pip安装、Linux环境下matplotlib和scipy等核心依赖的apt-get解决方案,以及使用iris数据集运行集成分类器示例的完整代码。适合希望快速体验mlxtend内置数据与可视化功能的开发者参考。
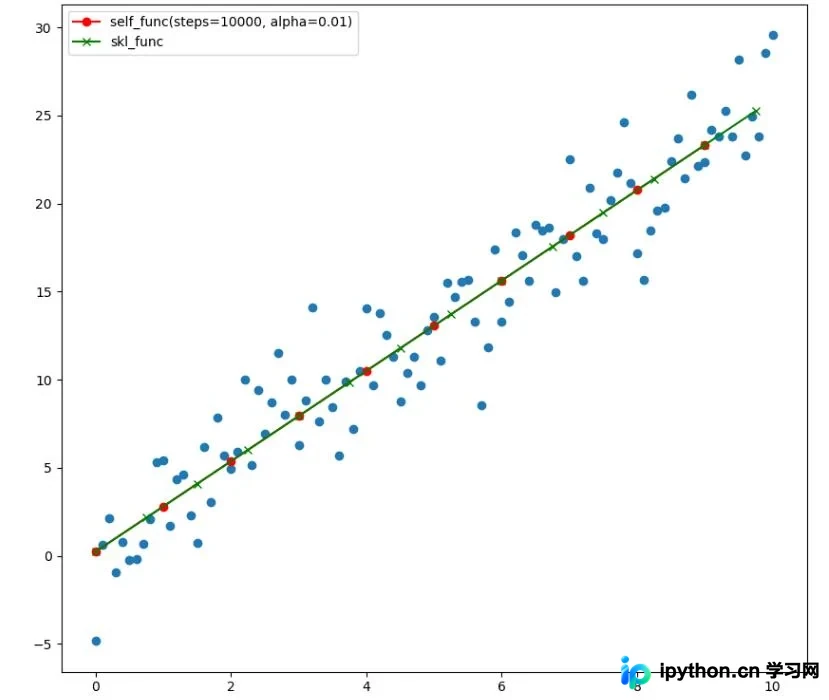
本文通过Python代码演示最小二乘法线性拟合过程,对比自定义实现与Scikit-learn库的结果。实验生成带噪声数据,自定义函数通过梯度下降迭代求解参数,最终输出斜率W约2.5649和截距b约0.2453,与官方库结果高度一致,验证了算法有效性。
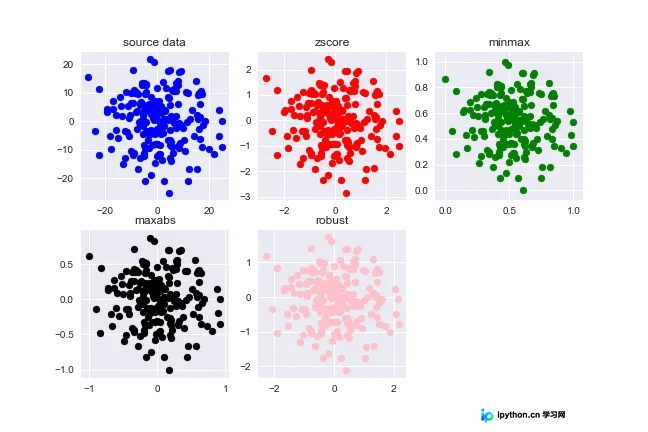
本文介绍Python中数据标准化的四种核心方法:Max-Min归一化、Z-Score标准化、MaxAbs绝对值标准化及RobustScaler鲁棒标准化。通过Sklearn库实现,解析各方法适用场景,如稀疏数据与含离群点数据的处理,助力提升模型训练效果。
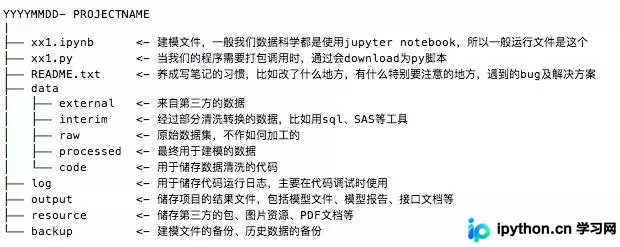
本文总结了Python机器学习项目中的8个关键实践,涵盖从项目归档、源数据备份、路径配置到代码注释、循环加速、进度可视化、高效调试及异常处理的完整工作流。通过引入Git、Rsync等工具及PySnooper、tqdm等库,帮助开发者规避常见陷阱,提升代码的可维护性与执行效率,适合Python入门及进阶开发者参考。
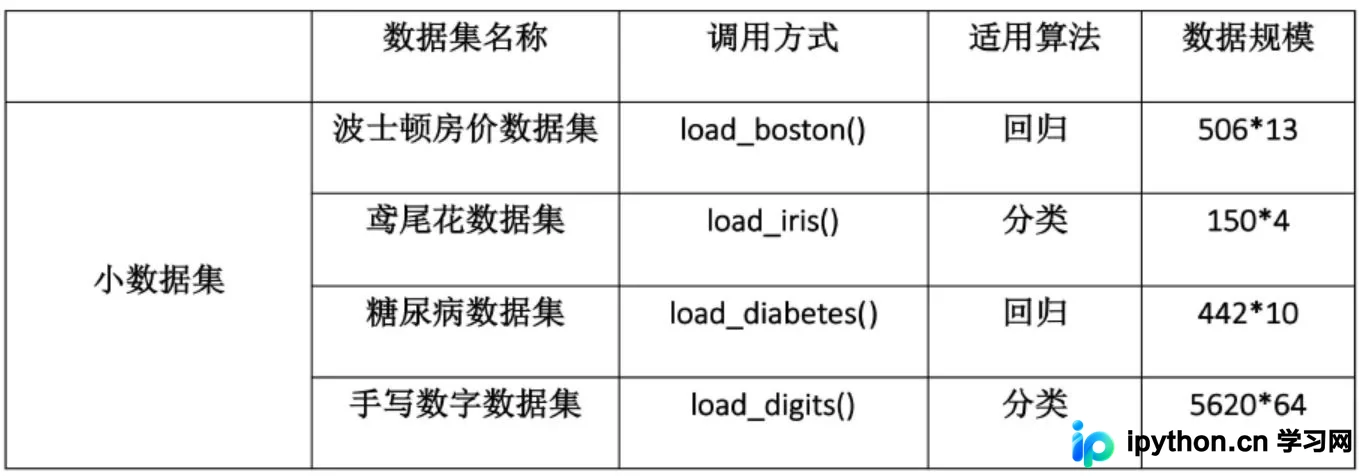
本文详细介绍Python中两大核心库NumPy与Scikit-learn的基础应用。涵盖NumPy数组创建、内存优势及常用数值计算方法,并系统讲解Sklearn的监督与无监督学习模块、数据变换工具及标准API调用流程,助力快速上手机器学习实践。
本文深入解析机器学习中的数据划分策略,重点对比留出法与交叉验证法的原理及适用场景。通过Python sklearn库代码示例,详细演示如何实现train_test_split、KFold及LeaveOneOut等关键函数,帮助开发者根据数据量大小选择最优划分方案,平衡计算成本与模型评估的准确性。
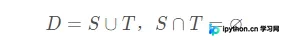
本文介绍在机器学习中如何按比例随机切分数据集。通过Python脚本实现训练集与验证集的自动划分,支持随机打乱功能。代码包含核心split函数及测试用例,帮助开发者高效处理数据划分任务,避免手动操作的重复性。
本文详细对比了Python中实现线性回归的8种主流方法,包括SciPy、NumPy、Statsmodels及Sklearn等库的具体用法。通过构建最大1000万样本的合成数据集进行压力测试,结果显示简单矩阵求逆和SciPy特定函数在速度上显著优于通用的Sklearn模型,为大数据量下的线性回归选型提供实证参考。
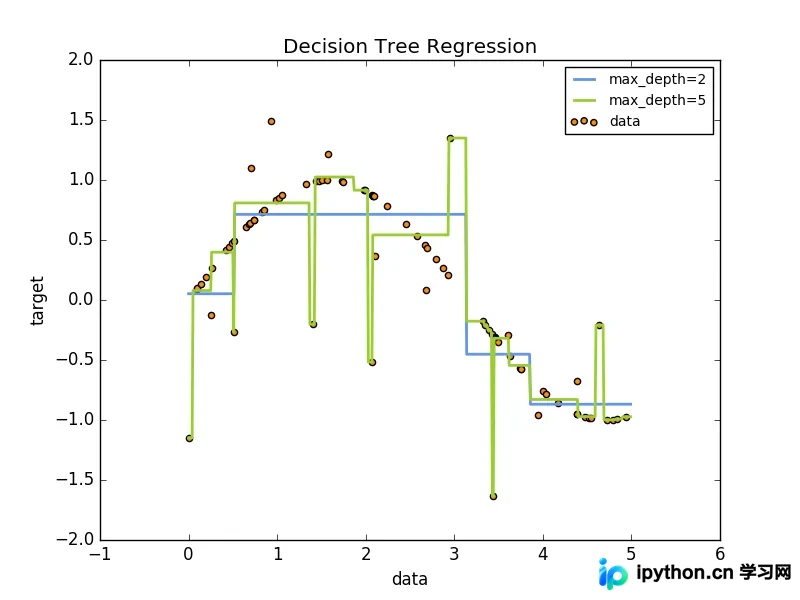
本文详解Python中scikit-learn库的决策树实现。涵盖决策树原理、分类器DecisionTreeClassifier与回归器DecisionTreeRegressor的使用,包括模型训练、预测及可视化导出。重点解析多输出问题的处理策略,通过虹膜数据集等实例展示代码应用,帮助开发者掌握从基础分类到复杂多输出回归的完整技术路径。
本文介绍如何使用Python的Sklearn库实现简单的逻辑回归模型。通过读取Excel数据,利用NumPy进行数据处理,并使用Matplotlib进行可视化展示。代码涵盖了数据加载、模型训练、预测及结果评估的全过程,旨在为初学者提供清晰的逻辑回归实现示例。